
Когда речь заходит о том, как отсортировать список в Python, почти сразу появляется путаница между sorted() и .sort(). Эти два инструмента выглядят похоже, но ведут себя по-разному, и именно на этом месте чаще всего возникают ошибки: от неожиданного изменения данных до ситуации, когда переменная внезапно становится None.
Разберём, чем они отличаются, как работает сортировка списков в Python и как использовать ключи сортировки для более сложных структур данных.
ВАМ ПРИШЛО ПРИГЛАШЕНИЕ 💌
Приходите к нам в соцсети поделиться своим мнением и почитать, что пишут другие. А ещё там выходит дополнительный контент, которого нет на сайте — шпаргалки, опросы и разная дурка. В общем, вот тележка, вот ВК — велком!
Чем sorted отличается от sort
Функция sorted() в Python принимает данные, оставляет их нетронутыми и возвращает абсолютно новый отсортированный список. В отличие от нее, метод списка .sort() перестраивает элементы прямо на месте (изменяет оригинальный массив) и возвращает пустое значение None.
| Признак | sorted() | list.sort() |
| Что возвращает | Новый список | None |
| Исходные данные | Остаются нетронутыми | Перестраиваются |
| К чему применяется | К любому итерируемому объекту (списки, кортежи, строки, словари) | Только к списку (list) |
| Когда брать | Нужен исходный порядок для истории, или работаем не со списком | Когда важна экономия памяти |
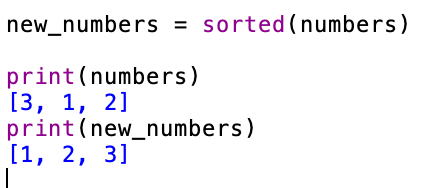
Теперь посмотрим на базовую сортировку списка в Python:
numbers = [3, 1, 2]
# Вариант 1: sorted
new_numbers = sorted(numbers)
print(numbers)      # [3, 1, 2] - оригинал цел
print(new_numbers)  # [1, 2, 3] - получили новый
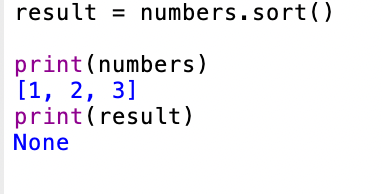
# Вариант 2: sort python
result = numbers.sort()
print(numbers)      # [1, 2, 3] - оригинал изменился
print(result)       # None - частая ошибка новичков!
Синтаксис и параметры
У sorted() и .sort() сигнатуры очень похожи — различие в том, как они вызываются. Функция sorted() принимает итерируемый объект в качестве первого аргумента и возвращает новый список. Метод .sort() вызывается прямо у списка и не возвращает результат.
Правила вызова строятся на четырех принципах:
- Обязательный аргумент: для функции это итерируемый объект, для метода аргументов нет.
- Параметр
reverse: разворачивает сортировку в обратном порядке (по убыванию). - Параметр
key: функция, которая задаёт правило сортировки (по умолчаниюNone). - Только именованная передача:
keyиreverseнельзя передавать просто через запятую, нужно явно писать их имена (keyword-only arguments).
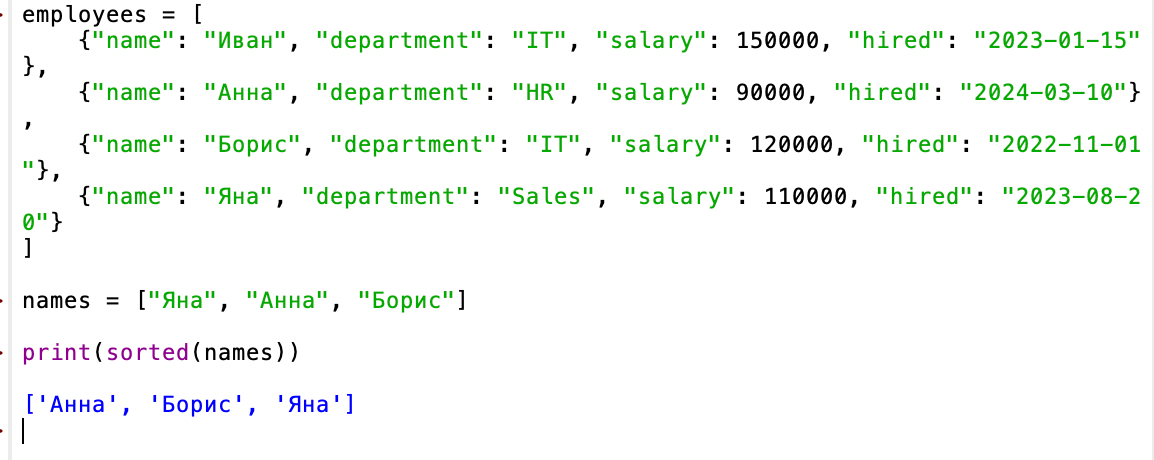
Разберём на примере. Допустим, у нас есть список сотрудников. Дальше мы будем использовать его во всех примерах в статье и на одной и той же структуре смотреть разные способы сортировки.
employees = [
    {"name": "Иван", "department": "IT", "salary": 150000, "hired": "2023-01-15"},
    {"name": "Анна", "department": "HR", "salary": 90000, "hired": "2024-03-10"},
    {"name": "Борис", "department": "IT", "salary": 120000, "hired": "2022-11-01"},
    {"name": "Яна", "department": "Sales", "salary": 110000, "hired": "2023-08-20"}
]
names = ["Яна", "Анна", "Борис"]
# по возрастанию (по умолчанию — алфавит)
print(sorted(names))
# ['Анна', 'Борис', 'Яна']
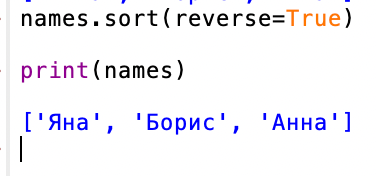
# по убыванию
names.sort(reverse=True)
print(names)
# ['Яна', 'Борис', 'Анна']
Суть в том, что sorted() всегда создаёт новый список, а .sort() изменяет существующий. Всё остальное — это настройки того, как именно происходит сортировка.
Сортировка по ключу
Параметр key — это основа всей логики сортировки в Python. Он принимает функцию с одним аргументом. Python применяет её к каждому элементу списка и сортирует данные на основе того, что вернула эта функция.
Лямбда-функция
Чаще всего для простых ключей используют lambda — короткую анонимную функцию.
Задача: отсортировать сотрудников по зарплате:
by_salary = sorted(employees, key=lambda emp: emp[“salary”])

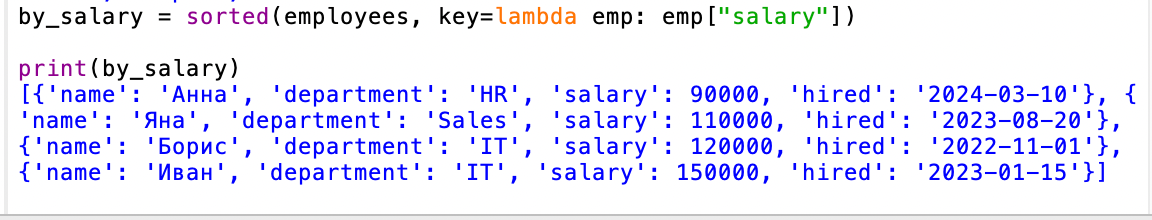
Здесь lambda принимает один элемент (словарь сотрудника) и возвращает значение поля salary, по которому и происходит сортировка.
itemgetter и attrgetter
Для простых извлечений полей вместо lambda часто используют функции из модуля operator — они работают быстрее, потому что реализованы на уровне C.
Задача: сделать то же самое (отсортировать по зарплате), но быстрее:
from operator import itemgetter

by_salary_fast = sorted(employees, key=itemgetter(“salary”))

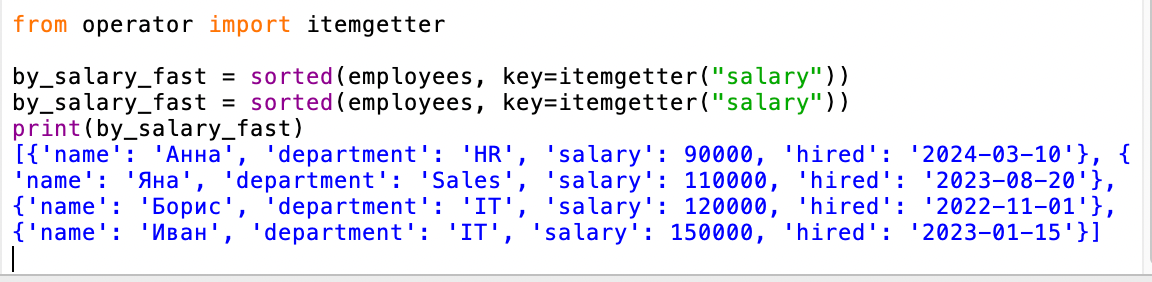
На списке из 100 000 словарей (Python 3.14) itemgetter отрабатывает примерно на 15–20% быстрее, чем лямбда, за счет того, что он реализован на языке C под капотом интерпретатора. Для сортировки объектов (экземпляров классов) аналогично используется attrgetter.


Обычная функция и методы объекта
Если логика сортировки становится сложнее, лучше вынести её в отдельную функцию. В key можно передавать и встроенные методы объектов — главное не вызывать их, а передавать как ссылку.
Задача: отсортировать строки без учёта регистра:
names_sorted = sorted([“Яна”, “анна”, “Борис”], key=str.lower)

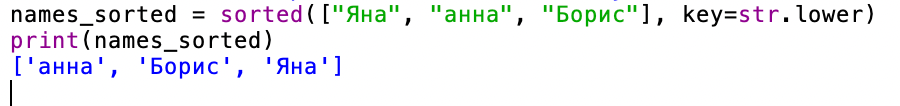
Здесь str.lower применяется к каждому элементу списка автоматически.
Ключ-кортеж
Если нужно сортировать сразу по нескольким полям, key должен возвращать кортеж.
Задача: отсортировать сначала по отделу, затем по зарплате (по убыванию):
by_dept_and_salary = sorted(
    employees,
    key=lambda emp: (emp["department"], -emp["salary"])
)
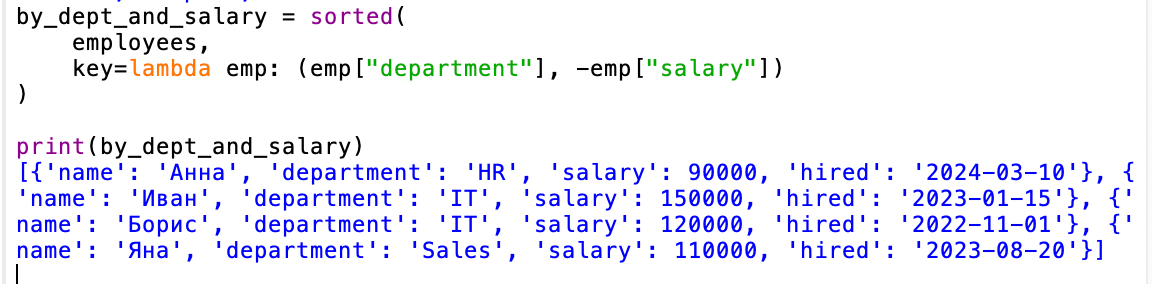
Кортеж сравнивается поэлементно: сначала department, а если они равны — сравнивается зарплата.
Многоуровневая сортировка и стабильность
В Python применяется стабильная сортировка. Это значит, что если у двух элементов значение ключа одинаковое, их относительный порядок из исходного списка сохраняется.
Благодаря этому сортировку по нескольким полям можно делать двумя способами: через кортеж в key или через последовательные сортировки. Второй вариант работает за счёт того, что каждая следующая сортировка не ломает порядок уже отсортированных элементов с равным ключом.
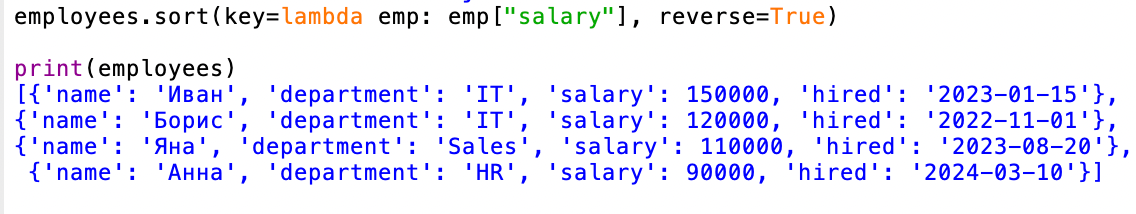
Задача: отсортировать сотрудников сначала по отделу, а внутри отдела — по зарплате по убыванию:
# 1. Сначала сортируем по младшему критерию (зарплата)
employees.sort(key=lambda emp: emp["salary"], reverse=True)
# 2. Затем сортируем по старшему критерию (отдел)
employees.sort(key=lambda emp: emp["department"])
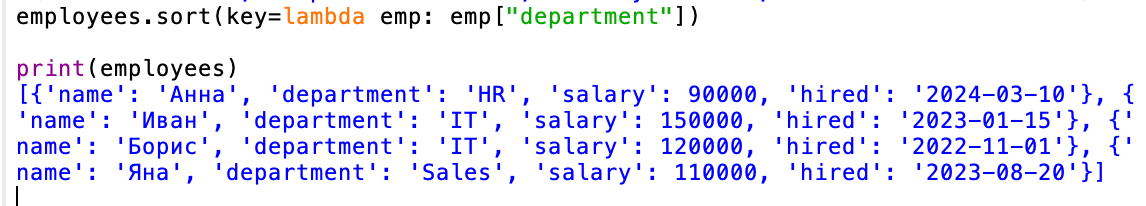
После этого внутри каждого отдела сотрудники уже будут упорядочены по зарплате за счёт стабильности сортировки.
Ключ-кортеж работает в один проход, поэтому он быстрее. Но если вам нужно отсортировать данные, где одно поле сортируется по убыванию (строка), а другое по возрастанию (число) — поставить минус перед строкой в кортеже нельзя. В таких сложных случаях последовательная сортировка незаменима.
Сортировка словарей и вложенных структур
Разберём несколько типичных ситуаций, с которыми чаще всего сталкиваются при работе с сортировкой в Python.
Список словарей (с отсутствующим ключом)
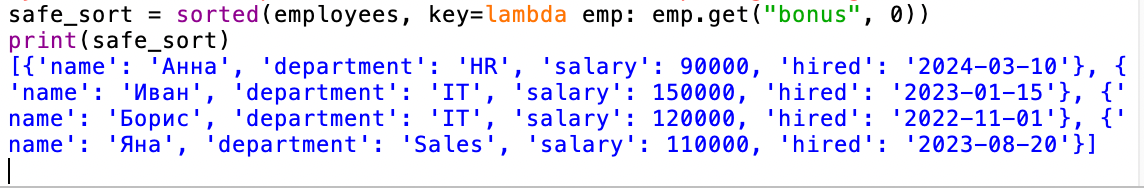
Если в части словарей нет нужного поля, прямой доступ через emp[“bonus”] приведёт к KeyError. Чтобы избежать падения, используют dict.get() с дефолтным значением.
# если бонуса нет, считаем его равным 0
safe_sort = sorted(employees, key=lambda emp: emp.get("bonus", 0))
Словарь по значениям
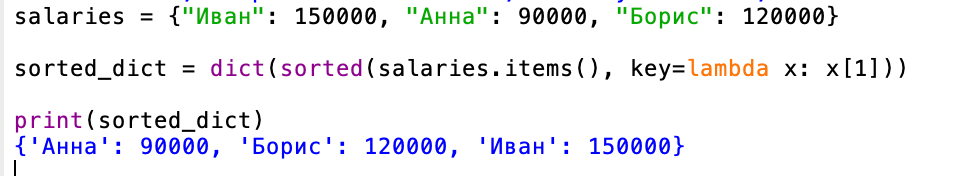
Сам словарь напрямую отсортировать нельзя. Но можно взять его пары через .items(), отсортировать как кортежи и затем собрать обратно.
Начиная с Python 3.7, обычный dict сохраняет порядок вставки, поэтому результат сортировки будет корректно «запоминаться».
salaries = {"Иван": 150000, "Анна": 90000, "Борис": 120000}
# x[1] — значение (зарплата), x[0] — ключ (имя)
sorted_dict = dict(sorted(salaries.items(), key=lambda x: x[1]))
Список кортежей
Часто данные приходят не в виде словарей, а как «сырые записи» — например, строки из логов, выгрузки из CSV или ответ API, где каждая запись — это кортеж. Допустим, у нас есть список заказов: имя клиента, количество товаров, сумма заказа:
from operator import itemgetter
orders = [
    ("Иван", 3, 12000),
    ("Анна", 1, 5000),
    ("Борис", 5, 8000),
    ("Яна", 2, 15000)
]
sorted_orders = sorted(orders, key=itemgetter(2, 1))
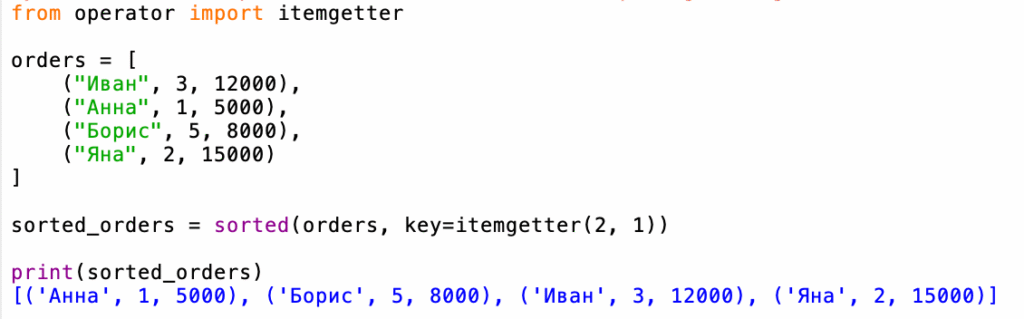
Здесь сортировка идёт так: сначала по сумме заказа, если суммы одинаковые — по количеству товаров. То есть, itemgetter удобно использовать, когда структура фиксированная и вы работаете с позициями, а не с именованными полями.
Вложенные структуры
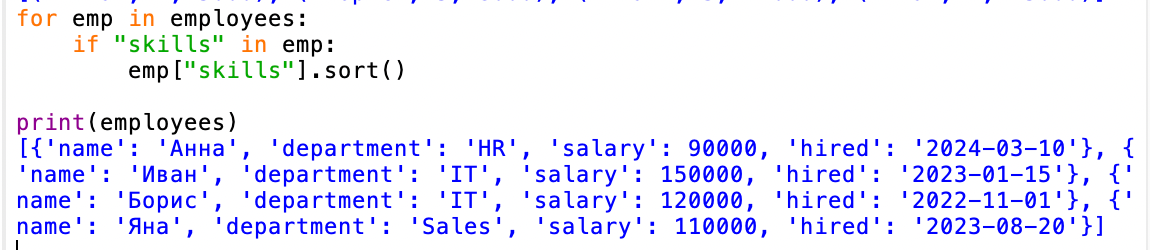
Если внутри объектов есть вложенные списки, их сортируют отдельно — через цикл. Важно понимать: здесь мы не сортируем список сотрудников целиком, а приводим в порядок вложенные данные внутри каждого элемента.
for emp in employees:
    if "skills" in emp:
        emp["skills"].sort()  # сортируем список навыков внутри словаря
Полезный блок со скидкой
По промокоду: KOD (можно просто нажать) — вы получите скидку на все курсы Практикума.
Если синтаксис и базовые структуры данных пока по ощущениям на грани — начните с Python-разработчик; зацепило, как устроен Timsort и что вообще значит O(n log n), и хочется идти дальше в алгоритмы, — Алгоритмы и структуры данных; а если четыре задачи для самопроверки в конце статьи оказались слишком лёгкими — попробуйте бесплатную Подготовку к алгоритмическому собеседованию и проверьте, где предел.
Бесплатные вводные курсы в Практикуме тоже есть — по всем направлениям, от Python до аналитики.
Сортировка строк
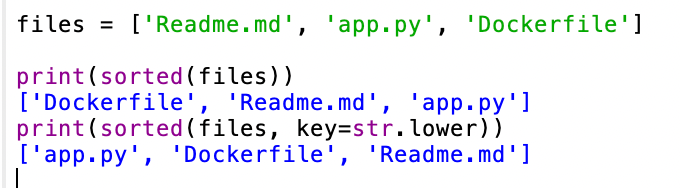
Если вы начнете гуглить, как отсортировать список строк в Python, то столкнетесь с тем, что Python сортирует строки посимвольно по Unicode-кодам. Из-за этого регистр и алфавит влияют на порядок: заглавные символы идут раньше строчных, а порядок кириллицы и латиницы может выглядеть неожиданно.
Решение 1: игнорирование регистра
files = ['Readme.md', 'app.py', 'Dockerfile']
print(sorted(files))  # чувствительно к регистру и Unicode
print(sorted(files, key=str.lower))  # нормализация регистра
Решение 2: корректный алфавитный порядок локали
Для языков с особыми правилами сортировки (например, кириллица с буквой «ё») str.lower уже недостаточно. И чтобы привести строки к языковым правилам сортировки, используется модуль locale.
import locale
# locale.strxfrm преобразует строку с учетом правил русского алфавита
locale.setlocale(locale.LC_ALL, 'ru_RU.UTF-8')
files = ['Задача.md', 'README.md', 'архив.zip']
sorted_files = sorted(files, key=locale.strxfrm)
print(sorted_files)
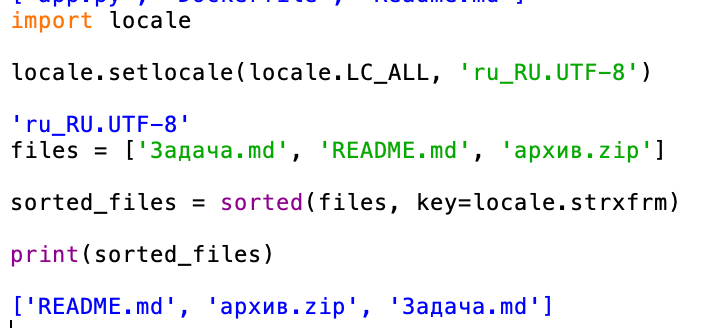
Здесь locale.strxfrm преобразует каждую строку в специальную «сортируемую форму», где уже учтены правила языка (порядок букв, регистр, особенности кириллицы).
Решение 3: естественная сортировка чисел в строках
Стандартная сортировка поставит файл10 раньше файл2, потому что символ 1 меньше символа 2. Самый надежный способ решить это — установить библиотеку natsort.
from natsort import natsorted
files = ['log2.txt', 'log10.txt', 'log1.txt']
print(natsorted(files))
# ['log1.txt', 'log2.txt', 'log10.txt']
Сортировка объектов своих классов
Когда речь заходит о сортировке объектов пользовательских классов в Python, есть несколько подходов. Выбор зависит от того, нужна ли вам разовая сортировка или вы хотите задать «естественный порядок» объектов в системе.
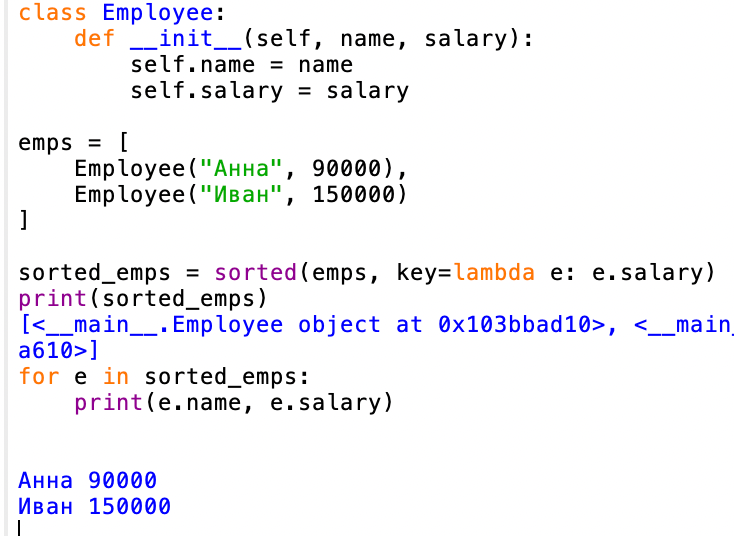
Путь 1: обращение к атрибуту (через key)
Самый простой и гибкий способ — сортировать по конкретному атрибуту через key. Используется, когда порядок нужен только в конкретном месте кода.
class Employee:
    def __init__(self, name, salary):
        self.name = name
        self.salary = salary
emps = [
    Employee("Анна", 90000),
    Employee("Иван", 150000)
]
sorted_emps = sorted(emps, key=lambda e: e.salary)
Путь 2: магический метод __lt__ (Less Than)
Если у объектов есть логичный естественный порядок, например, даты всегда сортируются хронологически, мы прописываем его внутри класса. Тогда sorted() будет работать без параметра key.
class Employee:
    def __init__(self, name, salary):
        self.name = name
        self.salary = salary
    def __lt__(self, other):
        return self.salary < other.salary
После этого sorted(emps) будет работать автоматически.
Путь 3: dataclass(order=True)
Если класс — это в основном структура данных без сложной логики, Python может сам сгенерировать методы сравнения. Сортировка будет идти по полям в том порядке, в котором они объявлены.
from dataclasses import dataclass
@dataclass(order=True)
class EmpData:
    salary: int
    name: str
Здесь порядок сортировки задаётся порядком полей в классе: сначала salary, потом name.
Путь 4: functools.cmp_to_key
Нужен крайне редко — когда логика сортировки базируется не на извлечении одного поля, а на сравнении двух элементов друг с другом (например, перенос старого C-кода). Функция возвращает -1, 0 или 1.

Что происходит внутри
Внутри Python сортировка реализована через алгоритм Timsort — это гибридный подход, который объединяет сортировку вставками и сортировку слиянием. Его асимптотическая сложность в худшем случае составляет O(n log n), но главное преимущество в адаптивности: если данные частично уже отсортированы, алгоритм может отрабатывать значительно быстрее, вплоть до линейного времени в лучшем сценарии.
В современных версиях CPython (начиная с 3.11) логика слияния в Timsort была оптимизирована с помощью стратегии powersort. Это не замена алгоритма, а улучшение того, как выбираются оптимальные точки слияния серий.
Если смотреть на реальные замеры в Python 3.14 (актуальная стабильная ветка на апрель 2026 года), то на случайных данных разница между версиями практически не заметна. Но на реальных рабочих сценариях, где данные часто бывают частично упорядочены, например, логи, временные ряды или данные из БД, powersort даёт прирост производительности примерно на 10–15% за счёт более оптимальной структуры слияний.
Производительность и большие объёмы
В контексте высоких нагрузок и задачи python sort list важно понимать несколько практических нюансов, которые напрямую влияют на производительность:
- Тяжелый ключ — это нормально. Функция, переданная в
key, вычисляется ровно по одному разу для каждого элемента перед началом сортировки, а не при каждом сравнении. operator.itemgetterбыстрее лямбды. На больших объёмах данных разница может достигать ~15–20%, потому чтоitemgetterреализован на уровне C и не создаёт накладных расходов интерпретатора.- Не сортируйте всё ради нескольких элементов. Если из миллиона строк вам нужны только топ-5 самых высокооплачиваемых сотрудников, полная сортировка за O(n log n) избыточна. Используйте
heapq.nlargest(5, employees, key=…). Сложность будет O(n log k), что кардинально быстрее. - Поддержание отсортированного списка дорого. Если вам нужно постоянно добавлять элементы и сохранять порядок, используйте модуль
bisect.insort. Вставка займет O(n), но массив не придется сортировать заново. - Будьте внимательны с генераторами. Передача генератора в функцию sorted() мгновенно материализует его в оперативную память. Файл на 10 гигабайт обрушит ваш сервер с ошибкой
MemoryError.
Частые ошибки
Здесь мы собрали типовые ошибки при сортировке в Python, с которыми чаще всего сталкиваются новички.
1. Переменная стала равна None
- Код:
result = my_list.sort() - Что происходит:
метод sort()меняет список на месте и возвращает пустоту. - Исправление: либо используем
my_list.sort()и работаем с исходным списком, либо используемsorted(my_list), если нужен новый список.
2. TypeError при сравнении разнотипных данных
- Код:
sorted([1, “два”, 3]) - Что происходит: Python строго типизирован, и поэтому не умеет сравнивать число со строкой.
- Исправление: привести всё к одному типу или отфильтровать список.
3. Значения None ломают ключ
- Код:
sorted([{“val”: 3}, {“val”: None}], key=lambda x: x[“val”]) - Что происходит:
Noneнельзя сравнивать с числами, поэтому возникаетTypeError. - Исправление: задать значение по умолчанию через
get()или подменитьNone: key=lambda x: x[“val”] if x[“val”] is not None else float(‘-inf’).
4. Числа в виде строк
- Код:
sorted([“10”, “2”, “1”]) - Что происходит: лексикографическая сортировка вернет
[‘1′, ’10’, ‘2’]. - Исправление: привести ключ к числу:
key=int.
5. Попытка вызвать sort у кортежа или словаря
- Код:
(3, 1, 2).sort() - Что происходит: AttributeError. Кортежи и словари не изменяются на месте, поэтому метода .sort() у них нет.
- Исправление: использовать функцию sorted(), которая вернет отсортированный список [1, 2, 3].
6. Сортировка внутри цикла
- Код:
for i in range(10): arr.sort(); print(arr[i]) - Что происходит: список сортируется заново на каждой итерации, что резко увеличивает нагрузку и не даёт смысла.
- Исправление: выполнять сортировку один раз до цикла.
7. Вызов функции в параметре key
- Код:
sorted(names, key=str.lower()) - Что происходит: функция вызывается сразу, а не передаётся как правило сортировки, из-за чего возникает ошибка
TypeError. - Исправление: убрать скобки
key=str.lower.
Шпаргалка по задачам
Когда вам нужно отсортировать список в Python, удобно держать под рукой короткие типовые конструкции для самых частых задач.
| Задача | Строка кода (с использованием data) |
| По возрастанию | data.sort() |
| По убыванию | data.sort(reverse=True) |
| По длине строки | data.sort(key=len) |
| Без учёта регистра | data.sort(key=str.lower) |
| По значению словаря | sorted(d.items(), key=lambda x: x[1]) |
| По двум полям (отдел, ЗП) | data.sort(key=lambda x: (x[‘dept’], x[‘salary’])) |
| С сохранением исходника | new_data = sorted(data) |
| Топ-5 максимумов | heapq.nlargest(5, data) |
| Обратный порядок (не сорт.) | data.reverse() |
Задачи для самопроверки
Попробуйте решить эти задачи на сортировку в Python самостоятельно, используя общий пример со списком сотрудников из начала статьи.
- Отсортировать сотрудников по отделу (по алфавиту) и внутри отдела по убыванию зарплаты.
- Отсортировать список имен сотрудников по алфавиту с учетом кириллицы.
- Получить трех самых давно работающих сотрудников (по дате найма
hired), не сортируя весь список. - Дан массив файлов
[‘file2.txt’, ‘file10.txt’, ‘file1.txt’]. Отсортируйте его естественным порядком.
Разбор решения:
sorted(employees, key=lambda x: (x[“department”], -x[“salary”]))(используем минус для убывания зарплаты).import locale; locale.setlocale(locale.LC_ALL, ‘ru_RU.UTF-8’); sorted([“Яна”, “Иван”], key=locale.strxfrm)import heapq; heapq.nsmallest(3, employees, key=lambda x: x[“hired”])(nsmallest, так как старые даты лексикографически меньше).from natsort import natsorted; natsorted(files)
Частые вопросы
Чем sorted отличается от sort?
Функция sorted() создает и возвращает новый список, оставляя оригинал нетронутым. Метод list.sort() изменяет сам массив на месте и возвращает None, экономя память и не создавая копий.
Как отсортировать словарь по значению?
Сам словарь отсортировать нельзя. Нужно превратить его в список кортежей через items(), отсортировать их, передав в key второй элемент кортежа (lambda x: x[1]), и обернуть обратно в функцию dict().
Почему sort возвращает None?
Это сделано специально: метод изменяет объект на месте и ничего не возвращает. None здесь служит сигналом, что функция работает как «мутатор», а не как генератор нового результата.
Как отсортировать список по нескольким полям?
Достаточно передать в параметр key лямбда-функцию, которая возвращает кортеж с нужными полями: key=lambda item: (item.field1, item.field2). Сортировка пойдет от первого поля ко второму.
Какая сложность у сортировки в Python?
Встроенная сортировка (Timsort) работает со сложностью O(n log n) в среднем и худшем случаях. Если данные почти отсортированы, алгоритм может работать значительно быстрее — вплоть до O(n).
Заключение
Выбор между sorted() и .sort() всегда сводится к одному вопросу: нужно ли сохранять исходный список без изменений. Если нужен новый объект — используйте sorted(). Если важно сэкономить память и работать с тем же списком — используйте .sort().
Всё остальное в сортировке Python упирается в понимание ключа key, лямбда-функций и того, как Python сравнивает данные под капотом. Когда эта логика становится понятной, даже сложные структуры данных начинают сортироваться предсказуемо.
Советуем дополнительно почитать
Функции (def) в Python: описание, какие бывают и как их применять — если lambda в статье была первой встречей с функциями как понятием, здесь база: синтаксис, return, область видимости, аргументы.
Множества (set) в Python: что это, как создать и использовать — статья подробно разбирает сортировку списков, словарей и кортежей, но не множеств; здесь — почему set неупорядочен по своей природе и как всё же навести в нём порядок.
Что такое LeetCode: как пользоваться и решать задачи — если задачи для самопроверки из статьи понравились, вот куда идти за третьей тысячей подобных, с разбором уровней сложности и форматом задач.
Типизация и аннотации типов данных в Python — TypeError из-за сравнения числа со строкой в статье — частный случай того, что аннотации типов и mypy умеют ловить ещё до запуска кода.
Enumerate в Python: пишем экономные и читаемые циклы — соседняя по духу тема: как enumerate() экономит память и делает циклы по спискам читаемее, чем range(len()).
Бонус для читателей
В Практикуме есть курсы по Python, аналитике, нейросетям. Бесплатные можно начать в любой момент, карту привязывать не нужно. Для платных есть промокод KOD — он даст скидку при покупке. На курсе «Мидл Python-разработчик» разбирают именно такую специфику: не синтаксис с нуля, а то, как писать продакшен-код.