
Есть корпоративная база — тысячи документов, инструкций, регламентов и ответов на вопросы клиентов. Пользователь пишет в поиске: «как вернуть товар, если прошло две недели». Стандартный полнотекстовый поиск ищет совпадения по словам. Он найдёт документы, где есть слово «возврат», и пропустит те, где написано «обмен» или «отказ от покупки». Потому что буквально этих слов там нет. Смысл запроса для такого поиска не существует.
Так работают большинство внутренних поисковых систем. Они хороши для артикулов, номеров договоров и названий ошибок. Но беспомощны, когда вопрос сформулирован как у человека.
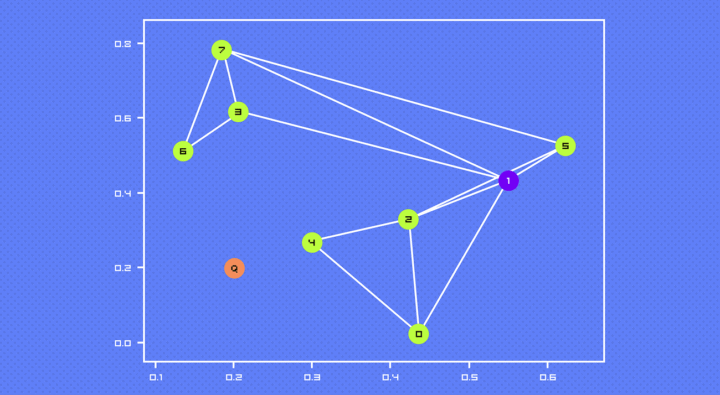
Векторная база данных решает эту задачу иначе. Она не ищет слова — она ищет смысл. Вместо того чтобы сравнивать строки, она превращает текст в набор чисел — вектор — и находит другие векторы, которые находятся рядом в пространстве. Чем ближе векторы друг к другу, тем ближе смысл исходных текстов.
Этот подход стал основой для RAG — retrieval-augmented generation. Система сначала находит в базе релевантные фрагменты, а потом передаёт их языковой модели, которая на их основе формирует ответ. Векторная база данных в этой схеме отвечает за хранение и поиск — это слой, который определяет, попадёт ли нужный кусок документа в ответ модели или нет.
ВАМ ПРИШЛО ПРИГЛАШЕНИЕ 💌
Приходите к нам в соцсети поделиться своим мнением и почитать, что пишут другие. А ещё там выходит дополнительный контент, которого нет на сайте — шпаргалки, опросы и разная дурка. В общем, вот тележка, вот ВК — велком!
Что хранит векторная база данных
Векторная база данных хранит эмбеддинги. Эмбеддинг — это числовое представление смысла. Любой текст, картинка или аудиофрагмент превращаются в массив чисел — вектор. Размерность этого массива зависит от модели, которая его создала.
Возьмём три фразы:
- «Доставка обычно занимает два дня»
- «Оплата проходит после получения заказа»
- «Возврат возможен в течение четырнадцати дней»
Модель эмбеддингов превратит каждую из них в вектор, скажем, из 768 чисел. Первая и третья фразы окажутся ближе друг к другу в пространстве, чем вторая, потому что обе касаются условий работы с заказом. При этом ни одно слово не совпадает — «доставка» и «возврат» вообще разные понятия. Но модель уловила, что они относятся к одной смысловой области.
Типичная размерность векторов сегодня — от 384 до 3072. Модели вроде text-embedding-3-small дают вектор из 1536 чисел, text-embedding-3-large — из 3072. Чем выше размерность, тем больше нюансов может уловить модель, но тем дороже хранение и поиск. Один вектор из 3072 чисел в формате с плавающей точкой занимает около 12 килобайт. На ста миллионах векторов это уже больше терабайта.
Когда мы говорим «поиск по смыслу», на практике это означает вычисление расстояния между векторами. Чаще всего используют косинусное сходство — меру, которая показывает угол между двумя векторами. Чем меньше угол, тем ближе смысл. Косинусное сходство игнорирует длину вектора и оценивает только направление — для текстов это важно, потому что один документ может быть длиннее другого, но нести ту же идею.
Векторная база данных не просто хранит эти массивы чисел. Она строит индексы, чтобы находить ближайшие векторы за миллисекунды, а не за минуты. Без индекса поиск среди миллионов векторов потребовал бы попарного сравнения каждого с каждым — полный перебор, который работает только на совсем маленьких объёмах.

Чем векторный поиск отличается от поиска по словам
Сравним три подхода на одном запросе: пользователь спрашивает «как исправить ошибку 503». В базе есть документы с фразами «сервер временно недоступен», «ошибка 503: Service Unavailable» и «рекомендации по увеличению таймаутов».
- Поиск точного совпадения через LIKE в SQL найдёт только документы, где есть строка «ошибка 503». Если в документе написано «сервер вернул 503-й код», совпадения не будет.
- Полнотекстовый индекс лучше: он найдёт «ошибка 503» и «503-й код», потому что разбирает слова на токены. Но он не поймёт, что «сервер временно недоступен» — это та же проблема, просто описанная другими словами.
- Векторный поиск превратит запрос в вектор и найдёт все три документа. Потому что в пространстве эмбеддингов фразы «ошибка 503» и «сервер временно недоступен» окажутся рядом.
При этом у лексического поиска есть сценарии, где он выигрывает. Если пользователь ищет артикул «TP-LINK-102» или номер договора «Д-23-4567», точное совпадение по строке даст результат мгновенно и безошибочно. Векторный поиск может найти что-то похожее по смыслу, но в данном случае это не нужно. Именно поэтому в серьёзных RAG-системах используют гибридный поиск — комбинируют оба подхода.
| Запрос | Точное совпадение | Полнотекстовый поиск | Векторный поиск |
| «ошибка 503» | найдёт точное вхождение | найдёт «503» и «ошибка» | найдёт всё про недоступность сервера |
| «TP-LINK-102» | найдёт идеально | найдёт идеально | может найти похожие артикулы — не нужно |
| «как ускорить загрузку сайта» | ничего не найдёт | найдёт по отдельным словам | найдёт все документы про производительность |
| «договор Д-23-4567» | найдёт точно | найдёт точно | найдёт похожие номера — скорее помеха |
Реляционные СУБД вроде PostgreSQL с самого начала проектировались для точных совпадений и диапазонных условий. Векторный поиск для них — надстройка. Специализированные векторные базы данных, напротив, оптимизированы для приближённого поиска в многомерном пространстве.
Как устроен поиск ближайших соседей
Задача векторного поиска формулируется просто: дай K векторов, наиболее близких к запросу. Решение — алгоритмы приближённого поиска ближайших соседей, ANN (Approximate Nearest Neighbor). Они жертвуют небольшой точностью ради скорости.
Полный перебор — точный результат и линейный рост времени
Самый простой способ — сравнить вектор запроса с каждым вектором в базе. Это даёт гарантированно точный результат: вы найдёте действительно ближайших соседей. Но время поиска растёт линейно с числом векторов. На миллионе векторов это ещё терпимо — миллион вычислений расстояния занимает доли секунды. На ста миллионах — уже секунды. На миллиарде — минуты.
Полный перебор используют только в двух случаях: объём данных совсем маленький, или точность критична и допустимая задержка позволяет. Во всех остальных ситуациях нужны индексы.
HNSW — многослойный граф
HNSW (Hierarchical Navigable Small World) — самый популярный индекс для векторного поиска в 2026 году. Он строит многослойную карту. Верхний слой разрежённый — поиск начинается с него и делает большие прыжки по пространству. На каждом следующем слое шаги становятся мельче. Это похоже на навигацию: сначала вы выбираете город, потом район, потом улицу, потом дом.
HNSW даёт высокую точность (часто выше 99% recall@10) при умеренной задержке. В бенчмарке на ста миллионах векторов Qdrant с HNSW показал 12 мс на запрос при recall@10 = 0.991. Weaviate на том же наборе данных — 9 мс и recall@10 = 0.989.
У индекса два ключевых параметра:
M— число связей каждого узла. Чем выше M, тем точнее поиск, но тем больше памяти потребляет индекс и тем дольше он строится. Типичное значение — 16.ef_search— размер динамического списка кандидатов во время поиска. Чем выше ef_search, тем точнее результат, но тем медленнее запрос. Обычно используют значения от 50 до 200.
HNSW — индекс in-memory: он должен полностью помещаться в оперативной памяти. Это ограничение становится проблемой на очень больших объёмах — миллиардах векторов.
IVF и квантование — разбиение на кластеры и сжатие
IVF (Inverted File Index) работает иначе: он разбивает всё пространство векторов на кластеры. При поиске алгоритм определяет, к какому кластеру относится запрос, и проверяет только векторы внутри него. Это похоже на библиотечный каталог: вместо того чтобы обходить все книги, вы идёте в нужный раздел.
IVF даёт огромный выигрыш в скорости ценой потери точности — если запрос попал не в тот кластер, нужный вектор может не найтись. Количество кластеров (nprobes) регулирует компромисс: чем больше кластеров проверяем, тем точнее, но медленнее.
Квантование добавляется поверх IVF для сжатия векторов. Вместо того чтобы хранить все 1536 чисел с полной точностью, алгоритм сжимает их до более компактного представления. Продуктовое квантование (Product Quantization, PQ) разбивает вектор на подвекторы и заменяет каждый из них ближайшим центром из заранее построенного словаря. Это сильно уменьшает размер индекса — иногда в 8–10 раз — но добавляет ошибку.
IVF с квантованием — выбор для очень больших баз, где память ограничена, а небольшая потеря точности допустима. Для баз до десятков миллионов векторов HNSW обычно даёт лучшее соотношение скорости и точности.
Фильтрация по метаданным
В реальных проектах никогда не ищут по всем документам сразу. Всегда есть фильтры: автор, дата, категория, права доступа.
Вопрос в том, когда применять фильтр — до поиска, после или во время:
- Пре-фильтрация сначала отсекает документы по метаданным, потом ищет векторы среди оставшихся. Если фильтр жёсткий, это работает быстро. Если фильтр пропускает почти всё, пре-фильтрация не даёт выигрыша, а только добавляет накладные расходы.
- Пост-фильтрация сначала ищет ближайшие векторы, потом отсекает те, что не прошли фильтр. Проблема: если в топ-20 попали документы, которые не подходят по фильтру, и ни одного подходящего, вы останетесь без результатов.
Современные векторные БД поддерживают фильтрацию во время поиска — алгоритм учитывает метаданные на этапе обхода индекса. Это сложнее в реализации, но даёт лучший результат. Qdrant, например, внедрил ACORN-1 — индекс, оптимизированный для фильтрованного поиска.
Как векторная БД работает внутри RAG
Посмотрим на весь конвейер от документа до ответа модели:
- Шаг 1. Разбиение на фрагменты. Исходный документ нарезается на куски — чанки. Способ нарезки определяет, что вообще попадёт в поиск.
- Шаг 2. Получение эмбеддингов. Каждый чанк пропускается через модель эмбеддингов. На выходе — вектор фиксированной размерности.
- Шаг 3. Запись в индекс. Вектор сохраняется в базе вместе с метаданными: ссылкой на исходный документ, номером фрагмента, автором, датой. База строит индекс для быстрого поиска — HNSW, IVF или другой.
- Шаг 4. Векторизация запроса. Пользовательский вопрос тоже превращается в вектор — той же моделью, что использовалась для чанков.
- Шаг 5. Отбор кандидатов. Вектор запроса ищет ближайших соседей в индексе. Обычно достают 20–50 кандидатов.
- Шаг 6. Переранжирование. Кандидаты проходят через модель-реранкер, которая оценивает каждый запрос/чанк более точно и выдаёт новый порядок. Из 20 кандидатов оставляют 5–10 лучших.
- Шаг 7. Сборка промпта. Отобранные фрагменты вставляются в промпт для языковой модели. Модель получает инструкцию, контекст из найденных документов и вопрос пользователя — и генерирует ответ.
Типичные пропорции для 2026 года: достать 20 кандидатов векторным поиском, переранжировать до 5, отправить в модель 3–5 фрагментов. Контекстное окно современных моделей позволяет передавать десятки тысяч токенов — но это не значит, что нужно передавать всё. Качество ответа падает, когда контекст переполнен нерелевантной информацией.
Полезный блок со скидкой
Чанкинг, выбор модели эмбеддингов, гибридный поиск, реранкер — это тот набор решений, который отличает RAG-прототип от системы, которая действительно работает. На курсе ML-инженер с опытом разбирают полный цикл — от подготовки данных до деплоя модели в продакшен, — а не один этап пайплайна.
Промокод: KOD (можно просто нажать) даст скидку при покупке любого курса.
Бесплатные вводные курсы в Практикуме тоже есть — по всем направлениям, от Python до аналитики.
Что настраивают, чтобы поиск попадал
Качество RAG-системы на 80% определяется тем, что попало в поиск, и только на 20% — самой языковой моделью. Изучим параметры, которые решают, попадёт ли нужный фрагмент в ответ.
Размер фрагмента и перекрытие
Чанкинг — первая критическая точка.
Слишком мелкие фрагменты (меньше 256 токенов) теряют контекст. Модель видит кусок текста, но не понимает, о чём он в целом. Слишком крупные (больше 2048 токенов) размывают смысл — внутри одного чанка может быть несколько разных тем, и эмбеддинг усредняет их в один вектор.
Безопасный дефолт для 2026 года: 512–1024 токена с перекрытием 15–20%. Перекрытие нужно, чтобы важная информация не оказалась ровно на границе двух чанков и не потерялась.
Исследование Vecta показало неожиданный результат: рекурсивная нарезка по 512 токенов дала точность 69%, а семантическая — только 54%. То есть иногда простые методы работают лучше сложных.
Другой важный вывод: существует «контекстный обрыв» — качество падает, когда фрагмент превышает примерно 2500 токенов.
Модель эмбеддингов и размерность
Модель эмбеддингов определяет, насколько хорошо ваши тексты превращаются в векторы. Сменить модель после того, как вы загрузили миллион векторов, — дорогое удовольствие: придётся переиндексировать всё с нуля.
Для русского языка в 2026 году работают несколько проверенных вариантов:
BAAI/bge-m3— мультиязычная модель, поддерживает 100+ языков, показывает топ-3 качество на русскоязычных бенчмарках. Размерность — 1024.intfloat/multilingual-e5-large— от Microsoft, 100+ языков, включая русский.Qwen/Qwen3-Embedding-4B— показывает высокие результаты, включая русский язык.sergeyzh/LaBSE-ru-turbo— специализированная модель для русского языка, размерность 768.
При выборе модели учитывайте качество, стоимость векторизации и размер получаемых векторов. Модель с размерностью 3072 даст более точные эмбеддинги, но каждый вектор будет весить в четыре раза больше, чем у модели с размерностью 768, и поиск по таким векторам будет медленнее.
Гибридный поиск
Чистый векторный поиск проигрывает лексическому на точных запросах — артикулах, номерах, названиях ошибок. Чистый лексический поиск проигрывает векторному на смысловых запросах.
Решение — гибридный поиск: объединяем результаты обоих подходов и ранжируем их вместе, например через Reciprocal Rank Fusion (RRF). Сейчас гибридный поиск стал стандартом для production-систем.
По данным из открытых бенчмарков, гибридный поиск последовательно улучшает качество ранжирования на 5–9 пунктов MRR по сравнению с поиском только по векторам. В некоторых конфигурациях прирост достигает 8,5% MRR (с 0,82 до 0,89). Этого достаточно, чтобы заметно улучшить качество ответов — особенно на запросах с редкими терминами и именами собственными, где чистая семантика проигрывает.
Переранжирование
Векторный поиск — это грубый фильтр. Он быстро отсеивает 99% документов, но оставшиеся кандидаты всё ещё могут быть не идеальны.
Реранкер — это модель, которая оценивает каждую пару (запрос, фрагмент) индивидуально. В отличие от эмбеддингов, которые превращают текст в вектор один раз, реранкер видит и запрос, и фрагмент одновременно и может уловить тонкие связи. Это дороже — каждый кандидат требует отдельного вычисления, — но точнее.
Сейчас наиболее востребован паттерн: BM25 + векторный поиск + кросс-энкодер реранкер. Из управляемых вариантов — Cohere Rerank 3. Из открытых — BGE-reranker-v2-m3 от BAAI, который на многих бенчмарках показывает результат, сравнимый с Cohere, но без оплаты за API.
Реранкер добавляет задержку — обычно 20–100 мс на пакет кандидатов, — но окупает её качеством. Если вы достаёте 20 кандидатов и оставляете 5, реранкер работает только на этих 20, а не на всей базе.
Обзор решений
Рынок векторных баз данных в 2026 году достаточно зрелый. Основные игроки:
- pgvector — расширение для PostgreSQL. Появилось в 2021 году. Не требует отдельной инфраструктуры, если Postgres уже в проде. Поддерживает HNSW и IVFFlat индексы. Ограничение: не более 2000 измерений для индексируемых векторов, максимум 16000 для хранения. Хорошо работает до 10 млн векторов.
- Qdrant — специализированная векторная БД на Rust, Apache 2.0. Сегментная архитектура, HNSW как основной индекс, поддержка квантизации. В бенчмарке на 100 млн векторов: 4200 QPS, 12 мс P99, recall@10 = 0.991. Один из самых быстрых open-source вариантов.
- Pinecone — полностью управляемый облачный сервис, проприетарный. Не требует управления инфраструктурой — самый простой старт. Но и самый дорогой. 3800 QPS, 14 мс P99 на 100 млн векторов.
- Weaviate — специализированная БД, BSD-3. Показывает высокий recall — больше 99% из коробки. 5100 QPS, 9 мс P99 на 100 млн.
- Milvus — распределённая векторная БД, Apache 2.0. Спроектирована для больших масштабов — от десятков миллионов до миллиардов векторов. Поддерживает HNSW, IVF, SCANN, DiskANN. Высокая пропускная способность на кластере.
- Chroma — встраиваемая БД для локальной разработки, Apache 2.0. Самая простая в использовании, но и самая медленная: 890 QPS, 67 мс P99 на 100 млн.
Сравнительная таблица (по данным бенчмарка на 100 млн векторов, 1536 измерений, HNSW)
| Решение | Recall@10 | QPS | P99 latency | Стоимость ориентировочно |
| pgvector | 0.987 | 1 800 | 28 мс | $0.08 за 1M запросов |
| Qdrant | 0.991 | 4 200 | 12 мс | $0.18 за 1M запросов |
| Weaviate | 0.989 | 5 100 | 9 мс | $0.24 за 1M запросов |
| Pinecone | 0.985 | 3 800 | 14 мс | $0.42 за 1M запросов |
| Milvus | 0.988 | 4 600 | 11 мс | $0.21 за 1M запросов |
| Chroma | 0.976 | 890 | 67 мс | $0.04 за 1M запросов |
Важное предупреждение: реальные расходы на облачные векторные хранилища часто выходят за план в 2,5–4 раза. Причины — хранение дублей (бэкапы, реплики), частая переиндексация при смене модели эмбеддингов, оплата простаивающих подов в кластере. Планируйте бюджет с запасом.
Как выбрать базу под свой проект
Выбор векторной БД сводится к четырём вопросам. Ответьте на них по порядку.
1. Сколько векторов будет через год?
До 1–2 млн — подойдёт pgvector, если Postgres уже есть. До 10 млн — pgvector ещё работает, но пора задуматься о специализированном решении. От 10 млн до сотен миллионов — Qdrant или Milvus. Сотни миллионов и выше — Milvus на кластере.
2. Есть ли уже Postgres в стеке?
Если да, и объём не превышает 1–2 млн векторов, pgvector — путь наименьшего сопротивления. Векторы лежат в той же транзакции, что и бизнес-данные, фильтры пишутся обычным SQL, бэкап и мониторинг уже настроены.
Если Postgres нет, или объём больше — смотрите в сторону специализированных БД.
3. Нужен ли закрытый контур?
Данные не должны покидать вашу инфраструктуру — выбирайте self-hosted решения. Qdrant, Milvus, Weaviate — все поддерживают локальный деплой. Pinecone — только облако, не подходит.
4. Какая допустимая задержка?
Менее 10 мс — Weaviate или Qdrant на быстром железе. 10–30 мс — pgvector или Milvus. Более 50 мс — Chroma подойдёт для разработки и прототипов.
Вывод по веткам:
- Postgres в проде, до 1–2 млн векторов, задержка не критична — pgvector
- Своё железо, высокая нагрузка, нужен контроль — Qdrant
- Управляемый сервис, низкая задержка, большие объёмы, бюджет позволяет — Pinecone
- Поиск по тексту и картинкам одновременно, сложные фильтры — Weaviate
- Масштаб миллиарды векторов, распределённая система — Milvus
- Прототип, локальная разработка, нулевой бюджет — Chroma
Когда обходятся без векторной базы
Векторная база данных — не универсальное решение. Бывают сценарии, где она избыточна:
- Корпус до нескольких сотен документов. Всё помещается в контекст модели. Можно просто загрузить все документы в промпт — никакого поиска не нужно.
- Точные факты в реляционной базе. Если пользователь всегда спрашивает «сколько стоит продукт Х» или «какой статус заказа Y», эти данные живут в обычной таблице. SQL-запрос даст ответ быстрее и точнее любого векторного поиска.
- Поиск по артикулам и идентификаторам. Полнотекстовый индекс справляется с этим лучше. Векторный поиск здесь только добавляет задержку и шум.
Часто приводимый довод: «У модели контекст на миллион токенов, можно не париться с RAG и векторной БД». На практике это работает плохо. Чем больше токенов в контексте, тем хуже модель удерживает внимание на нужной информации — качество ответа падает. Плюс стоимость: миллион токенов на каждый запрос — дорого. И задержка: обработать миллион токенов дольше, чем найти пять релевантных фрагментов и подать их в модель. Векторный поиск остаётся актуальным, даже когда контекстные окна растут.
Как измерять качество поиска
До того как выкатить RAG-систему в прод, нужно понять, работает ли она вообще. Без замеров вы не узнаете, улучшили вы что-то или ухудшили.
Минимальный набор замеров:
1. Соберите эталонный набор. Примерно 100 запросов, для каждого известны правильные фрагменты, которые должен найти поиск. Это золотой стандарт, без него все остальные замеры бессмысленны.
Пример строки эталонного набора:
{"query": "как вернуть товар в течение 14 дней", "relevant_chunks": ["doc_42_chunk_3", "doc_15_chunk_7"]}2. Измерьте recall@k. Доля запросов, где правильный фрагмент попал в топ-k результатов. Для RAG обычно смотрят recall@5 и recall@10.
3. Измерьте MRR (Mean Reciprocal Rank). Среднее значение, обратное рангу первого правильного результата. Показывает, насколько высоко в выдаче оказывается нужный документ.
4. Оцените ответы модели. Можно привлечь людей, можно использовать модель-судью (например, GPT-4 или другую LLM), которая оценивает ответ по шкале: релевантный / частично релевантный / нерелевантный.
5. Проверьте ссылки. Модель может дать правильный ответ, но сослаться на несуществующий документ. Это называется галлюцинация. Проверяйте, что каждая ссылка в ответе ведёт на реально найденный фрагмент.

Частые ошибки внедрения
Симптом: поиск находит странные фрагменты, не относящиеся к делу.
Причина: нарезка по фиксированному числу символов без учёта структуры документа. Предложение разрезано посередине, смысл потерян.
Правка: нарезайте по структурным границам — абзацам, предложениям, маркированным спискам.
Симптом: в топ-20 есть хорошие фрагменты, но они на низких позициях, а наверху — мусор.
Причина: нет реранкера. Векторный поиск нашёл 20 кандидатов, но не отсортировал их достаточно хорошо.
Правка: добавьте реранкер. Он дороже, но окупается качеством.
Симптом: после смены модели эмбеддингов поиск стал работать хуже.
Причина: старая и новая модели дают векторы в разных пространствах. Их нельзя смешивать.
Правка: переиндексируйте всю базу целиком при смене модели.
Симптом: пользователь спрашивает «документы Иванова за прошлый год», а поиск выдаёт документы Петрова за этот год.
Причина: метаданные записаны, но фильтры по ним не настроены. Поиск игнорирует автора и дату.
Правка: спроектируйте фильтры на этапе индексации, а не когда система уже работает.
Симптом: все замеры показывают отличный recall, но пользователи жалуются на качество ответов.
Причина: отсутствует эталонный набор, или он составлен неправильно. Вы меряете не то, что нужно.
Правка: соберите эталонный набор из реальных пользовательских запросов, а не из того, что кажется вам релевантным.
Симптом: в ответе модели есть цитата, но при переходе по ссылке — совсем другой текст.
Причина: вы храните полный текст документа, а не фрагмент. Или ссылка ведёт на документ, но модель использовала фрагмент из другого места.
Правка: храните в базе идентификатор фрагмента и исходный текст именно этого фрагмента. Ссылка должна вести на конкретное место в документе.
Симптом: пользователь не видит документы, к которым у него есть доступ, хотя поиск их нашёл.
Причина: права доступа не учитываются при выдаче фрагментов.
Правка: фильтруйте результаты по правам пользователя на этапе поиска, а не после.
Чек-лист запуска векторного поиска
Перед тем как выкатить систему в прод, проверьте эти восемь пунктов:
- Объём корпуса оценён на год вперёд. Вы знаете, сколько векторов будет через год, и выбранная БД выдержит эту нагрузку.
- Модель эмбеддингов зафиксирована и записана в конфиг. В коде нет «дефолтной модели», есть конкретное название и версия. Смена модели — осознанное решение, а не случайность.
- Стратегия нарезки описана. Вы знаете, какой размер чанка, какое перекрытие, по каким границам режете. Это записано в документации, а не только в голове.
- Метаданные и фильтры спроектированы. Вы знаете, по каким полям будете фильтровать, и индекс поддерживает эти фильтры.
- Гибридный поиск включён. Если есть точные запросы (артикулы, номера), лексический поиск работает параллельно с векторным.
- Реранкер подключён. Кандидаты проходят через реранкер, а не отправляются в модель как есть.
- Эталонный набор собран. У вас есть минимум 100 запросов с правильными ответами для замера качества.
- План переиндексации расписан. Вы знаете, сколько времени займёт переиндексация при смене модели, и у вас есть окно для этого.
Частые вопросы
Можно ли обойтись Postgres вместо отдельной векторной базы?
Да, если у вас уже есть Postgres в проде и объём корпуса не превышает 1–2 млн векторов. pgvector — полноценное расширение, которое добавляет векторный тип данных и индексы HNSW и IVFFlat. На больших объёмах pgvector начинает деградировать, потому что векторная нагрузка ложится на тот же кластер, который обслуживает транзакции.
Сколько стоит хранение миллиона векторов?
Зависит от размерности и выбранного решения. Один вектор размерности 1536 в полной точности — около 6 КБ. Миллион — примерно 6 ГБ. С учётом индексов и служебных данных — 10–15 ГБ. В облачных решениях это обойдётся в $50–150 в месяц за хранение плюс оплата запросов. pgvector на своём сервере — только стоимость дисков и памяти.
Заменяет ли длинный контекст модели векторный поиск?
Нет. Чем больше токенов в контексте, тем хуже модель удерживает внимание на нужной информации. Плюс стоимость токенов и задержка. Векторный поиск находит именно те фрагменты, которые нужны, и подаёт их в модель — это эффективнее, чем загружать всё подряд.
Какую модель эмбеддингов брать для русского языка?
Для русского языка в 2026 году хорошо работают BAAI/bge-m3 (1024 dims, мультиязычная, топ-3 на русских бенчмарках), intfloat/multilingual-e5-large (от Microsoft, 100+ языков) и sergeyzh/LaBSE-ru-turbo (специализированная, 768 dims). Выбор зависит от бюджета на векторизацию и требований к точности.
Что делать при смене модели эмбеддингов?
Переиндексировать всю базу целиком. Старые и новые векторы живут в разных пространствах, их нельзя смешивать. Запланируйте окно для переиндексации и учтите это в бюджете.
Векторная база данных — инструмент, у которого есть чёткие границы применимости. Выбор конкретного решения определяется объёмом корпуса и требованиями к задержке. Качество ответов RAG-системы держится на трёх факторах: правильной нарезке документов, гибридном поиске и регулярных замерах. Если эти три пункта настроены, остальное — вопрос инженерной реализации.
Советуем дополнительно почитать
Как создать AI-агента: пошаговое руководство — десять шагов от выбора архитектуры до безопасного деплоя; векторная БД в статье про агентов — один из «инструментов», которым агент пользуется.
Что такое база данных: зачем они нужны и какие БД бывают — если термины вроде «реляционная» и «документная» не самоочевидны, здесь база с нуля: реляционные, сетевые и иерархические БД на простых примерах.
Основные модели машинного обучения: виды и применение — модель эмбеддингов и реранкер из статьи тоже модели машинного обучения; здесь разбираются более широкие семейства — обучение с учителем, без учителя, классификация, регрессия.
Кто такой Data Scientist и чем он занимается — тюнинг чанкинга, выбор модели эмбеддингов и метрики recall/MRR из статьи — как раз то, чем на практике занимается Data Scientist; в материале — обязанности профессии и вилка зарплат.
Big data: гид по профессиям, связанным с данными — статья про векторные БД то и дело упоминает «сто миллионов векторов» и «миллиард»; здесь — о том, откуда берутся такие объёмы и какие профессии с ними работают.
Бонус для читателей
Если интересна часть про масштаб и то, что «сто миллионов векторов» не появляются сами по себе, — берите Инженер данных; хочется для начала увереннее писать сами SQL-запросы, прежде чем сравнивать их с векторным поиском, — SQL для работы с данными и аналитики; а если тема RAG и AI-агентов интересна не как один компонент, а целиком, — ИИ-инженер.
Промокод KOD — даст вам скидку при покупке любого курса на Яндекс Практикум.