
Представьте обычный рефакторинг с CLI-агентом. Сначала просим его пройтись по модулю, потом найти связанные тесты, исправить несколько файлов и проверить результат. Работа ещё идёт, а лимит подписки уже начинает напоминать о себе. В этот момент идея запустить Claude Code локально перестаёт выглядеть праздным экспериментом.
В августе 2026 года появился FreeToken, движок локального инференса LLM. В тестах из препринта FreeToken масштаб идёт от 35 млрд параметров на ноутбуке с RTX 4060 и 32 ГиБ RAM до 753 млрд на рабочей станции с RTX PRO 6000 и 512 ГиБ RAM. Между ними есть конфигурация с DeepSeek-V4-Flash на RTX 5090 и 192 ГиБ RAM.
Получается вариант того, что иногда ищут по запросу «бесплатный Claude Code»: сам агент работает с локальной моделью, поэтому запросы к ней не расходуют облачные токены. Локальный запуск переносит расходы на электричество, железо, место на диске и время на настройку.
Разберёмся, как устроен FreeToken, сколько видеопамяти нужно, какую модель выбрать и как подключить к локальному серверу Claude Code, Codex и OpenCode.
ВАМ ПРИШЛО ПРИГЛАШЕНИЕ 💌
Приходите к нам в соцсети поделиться своим мнением и почитать, что пишут другие. А ещё там выходит дополнительный контент, которого нет на сайте — шпаргалки, опросы и разная дурка. В общем, вот тележка, вот ВК — велком!
Что такое FreeToken
FreeToken — open-source-движок для локального инференса LLM, в первую очередь рассчитанный на большие MoE-модели. Его разработала команда с участием исследователей UC Berkeley и UT Austin. Исходный код опубликован под Apache 2.0 в репозитории FreeToken на GitHub, пакет freetoken доступен на PyPI, а на flashml.ai есть десктопная сборка.
Препринт FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution появился в arXiv 17 августа 2026 года; дальше для цифр будем опираться на него и актуальную документацию проекта.
Главная идея FreeToken связана с тем, как используются ресурсы обычного компьютера. Движок рассматривает GPU, CPU, оперативную память и PCIe как общую систему. Полный набор экспертов MoE-модели можно держать в RAM, а ограниченную видеопамять отдать тем весам, которые нужны прямо сейчас, KV-кэшу и остальным данным инференса.
Для приложений сверху FreeToken выглядит гораздо привычнее. В quick start FreeToken перечислены OpenAI-совместимые /v1/chat/completions, /v1/responses и /v1/models, а также Anthropic-совместимые /v1/messages и /v1/messages/count_tokens. Поэтому Claude Code, Codex или OpenCode можно подключить примерно так же, как к облачному провайдеру: меняется адрес API и модель, а привычный CLI-агент остаётся на месте.

Чем он отличается от Ollama и llama.cpp
Обычная локальная нейросеть для кода упирается прежде всего в размещение весов. llama.cpp умеет распределять слои между CPU и GPU, а Ollama использует стек локального инференса, где веса должны разместиться в доступной RAM и VRAM. Для плотной модели рост числа параметров быстро увеличивает требования к памяти. Если нужен обычный локальный запуск меньшего масштаба, можно использовать схему из инструкции как запустить нейросеть локально через Ollama. По устройству GPU-части FreeToken опирается на тот же класс GPU-centric рантаймов, что SGLang и vLLM; это сравнение приведено в препринте FreeToken.
FreeToken специально оптимизирован под Mixture of Experts. Полный пул экспертов остаётся в оперативной памяти, а свободная VRAM используется как общий LRU-кэш экспертов. По мере генерации движок меняет содержимое этого кэша и одновременно регулирует, сколько видеопамяти отдать экспертам, а сколько оставить под KV-кэш. На промахах кэша часть работы отправляется на GPU через PCIe, часть может выполняться прямо на CPU.
По замерам разработчиков FreeToken на RTX 5090 выдавал 77–83 tok/s с Qwen3.6-35B-A3B и 22–25 tok/s с DeepSeek-V4-Flash. В сравниваемых агентных сценариях преимущество по скорости декодирования доходило до 1,5–2,3 раза относительно llama.cpp, Ollama и KTransformers.
Почему MoE-модель на 753 млрд параметров работает на одной видеокарте
У плотной модели почти все параметры участвуют в вычислении каждого нового токена. У Mixture of Experts внутри некоторых слоёв находится много специализированных блоков, которые называют экспертами, а маршрутизатор выбирает только несколько из них.
Представьте огромную мастерскую со шкафами инструментов. Для хранения приходится найти место для всех шкафов, но конкретному мастеру в текущую минуту нужны только несколько инструментов. MoE работает похожим образом: объём памяти определяется полным набором весов, а объём вычислений на один токен зависит от активных параметров.
У DeepSeek-V4-Flash всего около 284 млрд параметров, но на каждом токене маршрутизатор выбирает 6 из 256 экспертов. В вычислении участвуют примерно 13 млрд параметров. У GLM-5.2 общий размер достигает 753 млрд параметров, активных на токен около 40 млрд. Именно разрыв между общим и активным объёмом даёт смысл офлоадингу экспертов.
FreeToken использует здесь несколько связанных механизмов.
Во время генерации часть нужных экспертов уже находится в VRAM благодаря LRU-кэшу. Если нужного эксперта там нет, движок может скопировать его через PCIe и выполнить на GPU либо оставить данные в оперативной памяти и выполнить соответствующую часть на CPU. Соотношение рассчитывается из фактически измеренной пропускной способности PCIe и памяти хоста, потому что ноутбук с RTX 4060 и настольная машина с RTX 5090 ведут себя здесь по-разному.
В статье разработчиков этот баланс описан формулой: q* ≈ m · B_P / B_H, где:
m — число промахов по кэшу экспертов на текущем шаге; B_P — измеренная пропускная способность передачи через PCIe; B_H — пропускная способность обработки весов со стороны оперативной памяти и CPU. q* показывает, сколько промахов выгоднее обслужить переносом эксперта на GPU. Остальные можно считать на CPU.
На стадии префилла ситуация меняется. Длинный промпт обычно затрагивает почти весь набор экспертов, поэтому FreeToken использует двойную буферизацию: пока GPU считает текущий слой, эксперты следующего слоя уже идут через PCIe. Для агентных сценариев движок также сохраняет состояние на семантических границах вроде tool call и конца сообщения, чтобы после изменения истории не пересчитывать лишний длинный префикс.
Наконец, размер экспертного кэша можно менять во время работы. Если растущий контекст требует больше места под KV-кэш, FreeToken сокращает пространство для экспертов и пересобирает кэш в новом бюджете VRAM без перезапуска всего движка и повторной загрузки полного пула из оперативной памяти. На домашнем компьютере это особенно полезно: видеопамять обычно делят модель, интерфейс системы, браузер и всё остальное, что пользователь успел открыть рядом.

Что нужно из железа для LLM на своей видеокарте
Если хочется понять, сколько видеопамяти нужно для локальной LLM, одной цифры недостаточно. VRAM хранит активный рабочий набор, а экспертный пул размещается в оперативной памяти. В аппаратных конфигурациях из препринта FreeToken есть и ноутбук с RTX 4060, и рабочая станция с RTX PRO 6000.
- Видеокарта NVIDIA. Авторы тестировали RTX 4060 Laptop, RTX 3090, RTX 4090, RTX 5090 и RTX PRO 6000. В README FreeToken актуальная ветка ориентирована на NVIDIA RTX 30/40/50 и CUDA.
- От 8 ГБ VRAM. Это нижняя подтверждённая точка в опубликованных тестах: в препринте FreeToken Qwen3.6-35B-A3B в официальном NVFP4-чекпоинте работала на ноутбучной RTX 4060 с 8 ГБ и выдавала 39,3 tok/s.
- Драйвер NVIDIA r580 или новее и CUDA 13. Эти версии указаны в актуальной инструкции по установке FreeToken. При первом запуске CUDA-ядра могут JIT-компилироваться, поэтому для CLI-сценария нужен toolkit с доступным nvcc.
- Linux x86_64 или Windows. Стабильный PyPI/CLI-путь документирован для Linux x86_64, а десктопная сборка доступна для Linux и Windows. Если полный пул экспертов нельзя закрепить и зарегистрировать для DMA, FreeToken переключает MoE-часть на CPU backend; этот fallback описан в препринте FreeToken.
- Оперативная память под веса и запас системе. В тестовых конфигурациях из препринта ноутбук с RTX 4060 имел 32 ГиБ RAM, десктоп с RTX 5090 имел 192 ГиБ, а станция с RTX PRO 6000 имела 512 ГиБ. Экспертный пул Qwen в BF16 занимает около 64,4 ГБ, пул DeepSeek в MXFP4 около 140 ГБ, чекпоинт GLM-5.2 около 433 ГБ. Объём RAM выбирают под конкретный чекпоинт и квант. Ноутбучный тест Qwen использовал официальный NVFP4; цифра 64,4 ГБ относится к BF16-пулу.
То есть LLM на своей видеокарте в случае FreeToken правильнее воспринимать как LLM на всём компьютере. GPU выполняет самую подходящую для него часть работы, но оперативная память остаётся полноценным участником схемы.
Что делать владельцам маков и AMD
Стабильный CLI-путь FreeToken сейчас рассчитан на NVIDIA и CUDA. Для AMD в документации есть ROCm-направление со статусом work in progress. На Mac с Apple Silicon CUDA нет; для него подходит другой локальный рантайм из инструкции как запустить нейронки на маке.
Ставим FreeToken
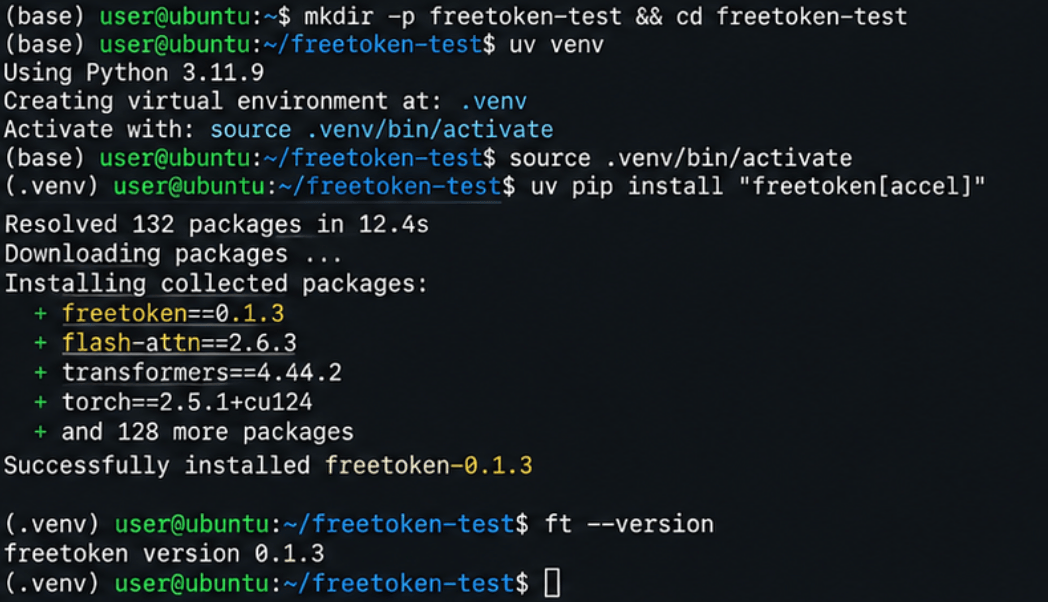
Ниже команды для стабильного FreeToken 0.1.3, опубликованного на PyPI 16 сентября 2026 года. Пакет требует Python 3.10 или новее.
1. Создаём окружение и ставим пакет через uv
uv venv
source .venv/bin/activate
uv pip install "freetoken[accel]"
uv создаст виртуальное окружение, после чего установит FreeToken и набор ускоренных зависимостей. Это основной путь из актуальной документации.
Проверяем версию:
ft –version
Для описанного ниже сценария команда должна показать версию 0.1.3.

2. При необходимости ставим FreeToken из исходников
Такой вариант удобен, если нужно работать с кодом проекта или проверять изменения до следующего стабильного релиза:
git clone https://github.com/FlashML-org/FreeToken.git && cd FreeTokenКоманда скачает репозиторий и перейдёт в его каталог.
uv venv
source .venv/bin/activate
Получим отдельное окружение для исходной версии.
uv pip install -e ".[accel]"FreeToken установится в editable-режиме: изменения в клонированном репозитории будут доступны без полной переустановки.
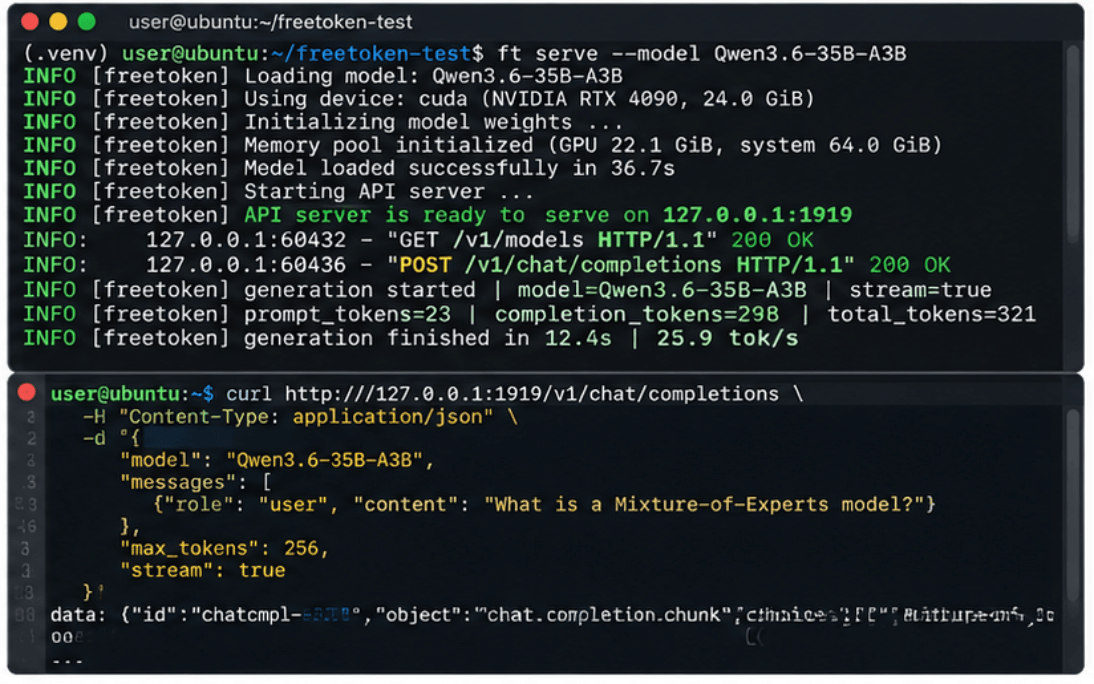
3. Запускаем модель
Путь можно заменить каталогом с уже скачанной моделью или совместимым Hugging Face ID:
ft serve --model ~/models/Qwen3.6-35B-A3BКогда всё загрузится, в терминале появится строка:
API server is ready to serve on 127.0.0.1:1919Порт 1919 используется в актуальном quick start FreeToken.
4. Проверяем API
В новом окне терминала запрашиваем список доступных моделей:
curl http://127.0.0.1:1919/v1/modelsЕсли сервер работает, он вернёт описание загруженной модели. После этого можно проверить обычный OpenAI-совместимый запрос:
curl http://127.0.0.1:1919/v1/chat/completions \
   -H 'Content-Type: application/json' \
   -d '{
     "model": "Qwen3.6-35B-A3B",
     "messages": [
       {
         "role": "user",
         "content": "Explain what this Python function does."
       }
     ]
   }'
В ответ придёт JSON с сообщением модели. Значит, сервер уже можно отдавать агенту. FreeToken также предоставляет /v1/responses для клиентов, которые работают через Responses API, и Anthropic-совместимый /v1/messages.

Для тех, кому терминал нужен только затем, чтобы поскорее его закрыть, на flashml.ai есть десктопное приложение. Оно устанавливает движок, позволяет запускать модели через интерфейс и доступно для Windows и Linux.
Полезный блок со скидкой
По промокоду: KOD (можно просто нажать) — вы получите скидку на все курсы Практикума.
Если конфиги и переменные окружения всё ещё выглядят непонятно, начните с курса Python-разработчик. Если хочется, чтобы агент писал код вместе с вами, а не вместо вас, посмотрите Вайбкодинг.
Бесплатные вводные курсы в Практикуме тоже есть — по всем направлениям, от Python до аналитики.
Какую модель выбрать под кодинг
FreeToken поддерживает больше двух десятков MoE-моделей. Для статьи разработчики подробно сравнивали несколько конфигураций на реальных агентных сценариях.
| Модель | Параметры всего / активных | Железо и скорость | Под что подходит |
| Qwen3.6-35B-A3B | 35B / 3B | RTX 4060 8 ГБ — 39,3 tok/s; RTX 5090 — 77–83 tok/s | Повседневные правки, автодополнение, рефакторинг одного файла |
| DeepSeek-V4-Flash | 284B / ≈13B, 6 экспертов из 256 | RTX 5090, MXFP4 — 22–25 tok/s | Многошаговые задачи и работа с несколькими файлами |
| GLM-5.2 | 753B / 40B | RTX PRO 6000 — 14,9 tok/s | Разбор чужой кодовой базы и архитектурные вопросы |
По замерам разработчиков FreeToken Qwen3.6-35B локально на RTX 4060 показывает 39,3 tok/s; авторы также приводят медианные 33 tok/s для облачного Codex по производственным трассам.
Сравнивать модели только по количеству параметров здесь довольно бесполезно. Qwen3.6-35B-A3B удобна, когда важнее скорость каждого короткого хода агента. DeepSeek-V4-Flash можно рассматривать для более длинных цепочек действий и изменений по нескольким файлам. GLM-5.2 требует рабочей станции с большим объёмом памяти, зато позволяет работать с классом моделей, который ещё недавно трудно было представить на одной пользовательской GPU.
Выбор модели зависит от рабочего процесса агента. Модель можно заменить за одну строку конфигурации, а лишние вызовы инструментов будут тратить вычисления при любом количестве параметров. Если такой процесс нужно спроектировать с нуля, этому посвящена программа Практикума «ИИ-агенты и автоматизация».
Есть ещё квантизация. FreeToken работает с MXFP4, NVFP4, FP8 и BF16, поэтому сравнивать замеры нужно вместе с форматом весов. В исходной статье разные модели и конфигурации используют BF16, MXFP4 или NVFP4. Таблица выше показывает результаты конкретных тестов; другой квант и другое железо дадут другую скорость. Для моделей меньшего масштаба можно свериться с подборкой локальных нейросетей для ПК.
Как запустить Claude Code локально через FreeToken
Теперь подключим агента. У FreeToken уже есть команда ft launch claude, которая сама определяет модель через /v1/models, готовит конфигурацию Claude Code и запускает клиент. Она также убирает облачные API-ключи из дочернего окружения, чтобы клиент случайно не переключился на платный endpoint.
Ручной вариант всё равно полезно понимать. Тогда вы точно знаете, куда Claude Code отправляет запросы и какие настройки отвечают за маршрутизацию.
1. Поднимаем локальный сервер
Если он ещё не запущен:
ft serve --model ~/models/Qwen3.6-35B-A3BДожидаемся:
API server is ready to serve on 127.0.0.1:1919Проверяем модель:
curl http://127.0.0.1:1919/v1/modelsДля Claude Code нам понадобится Anthropic-совместимый /v1/messages, который FreeToken предоставляет из коробки.
2. Переопределяем адрес Anthropic API
В той же shell-сессии, из которой запустим Claude Code, задаём адрес, локальный токен и имя модели:
export ANTHROPIC_BASE_URL="http://127.0.0.1:1919"
export ANTHROPIC_AUTH_TOKEN="local-freetoken"
export ANTHROPIC_MODEL="Qwen3.6-35B-A3B"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="Qwen3.6-35B-A3B"
ANTHROPIC_BASE_URL перенаправляет запросы Claude Code на локальный endpoint, ANTHROPIC_AUTH_TOKEN задаёт значение заголовка Authorization, а ANTHROPIC_MODEL выбирает основную модель. ANTHROPIC_DEFAULT_HAIKU_MODEL задаёт модель для alias haiku, который Claude Code использует в фоновой функциональности. Здесь оба имени модели указывают на тот же локальный Qwen. Имена переменных сверены с документацией Claude Code по переменным окружения и настройке моделей.
Если в shell остался настоящий Anthropic API key, лучше убрать его:
unset ANTHROPIC_API_KEYТак мы уменьшаем шанс случайного обращения к облачному API из этой сессии.
3. При желании переносим настройки в settings.json
Чтобы не экспортировать переменные перед каждым запуском, их можно добавить в settings.json Claude Code:
{
   "env": {
     "ANTHROPIC_BASE_URL": "http://127.0.0.1:1919",
     "ANTHROPIC_AUTH_TOKEN": "local-freetoken",
     "ANTHROPIC_MODEL": "Qwen3.6-35B-A3B",
     "ANTHROPIC_DEFAULT_HAIKU_MODEL": "Qwen3.6-35B-A3B"
   }
 }
Claude Code разрешает задавать поддерживаемые переменные через секцию env в settings.json. Формат описан в официальной документации настроек Claude Code. Если с самим агентом вы раньше почти не работали, рядом пригодится полный гайд по Claude Code.
4. Запускаем Claude Code
Теперь обычная команда:
claude
Для проверки можно дать задачу, которая заставит модель прочитать файл, например:
Read app.py and explain which function validates the uploaded file.
Do not change anything yet.
В окне FreeToken должны появиться запросы. Если агент отвечает и локальный сервер принимает их, Claude Code уже работает поверх вашей модели.
5. Используем автоматическую настройку FreeToken
Тот же сценарий можно сократить до:
ft launch claudeFreeToken найдёт работающий сервер, запросит модель через /v1/models, настроит провайдера и запустит агент. Перед изменением конфигов удобно посмотреть будущие действия:
ft launch claude --dry-run
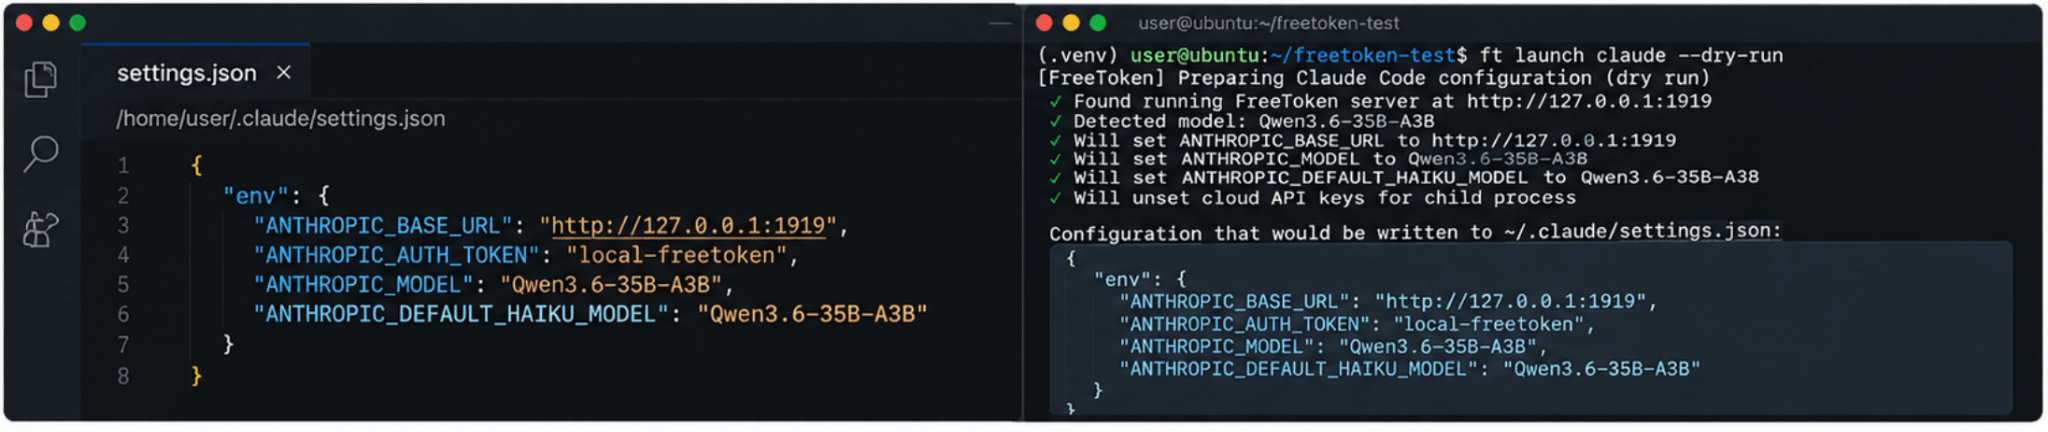
А если конфиг нужно только создать, без запуска клиента:
ft launch claude --configЭто особенно полезно после обновления Claude Code: вместо того чтобы помнить, какой параметр переехал в очередной версии, можно сначала посмотреть, что собирается записать актуальный FreeToken.
Понять, что удалось запустить Claude Code локально, можно по нескольким признакам одновременно: агент отвечает на запрос, в терминале ft serve появляются обращения к /v1/messages, адрес указывает на 127.0.0.1:1919, а счётчик облачных токенов подписки во время этих запросов не растёт. Последнее имеет смысл проверять именно вместе с логом локального сервера: одно отсутствие списаний ещё не доказывает, куда ушёл конкретный запрос.
Codex локально и OpenCode с локальной моделью
Общая схема та же: FreeToken уже работает как локальный сервер, поэтому агенту остаётся указать другой base URL и модель. Повторно ставить движок или загружать веса для каждого CLI-клиента не требуется. Отличия самих клиентов собраны в разборе, какой ИИ-агент выбрать.
Codex локально
Codex хранит пользовательский конфиг в $CODEX_HOME/config.toml; по умолчанию CODEX_HOME равен ~/.codex. Пользовательские провайдеры задаются через секции model_providers. Для FreeToken используем Responses API, потому что локальный сервер предоставляет /v1/responses. Формат параметров сверяем с официальным справочником config.toml Codex.
Добавляем в ~/.codex/config.toml:
model = "Qwen3.6-35B-A3B"
model_provider = "freetoken"

[model_providers.freetoken]
name = "FreeToken"
base_url = "http://127.0.0.1:1919/v1"
wire_api = "responses"
requires_openai_auth = false
Поле wire_api = “responses” направляет Codex на Responses API FreeToken. requires_openai_auth = false отключает требование авторизации OpenAI для этого пользовательского провайдера.
Проще дать настройку самому FreeToken:
ft launch codex --dry-run
ft launch codex
Первая команда покажет изменения, вторая применит конфиг и запустит агент.
OpenCode и локальная модель
Локального OpenAI-совместимого провайдера OpenCode можно описать в opencode.json проекта. Для /v1/chat/completions используется @ai-sdk/openai-compatible, а baseURL указывает на FreeToken. Такой формат приведён в официальной документации OpenCode по провайдерам:
{
   "$schema": "https://opencode.ai/config.json",
   "provider": {
     "freetoken": {
       "npm": "@ai-sdk/openai-compatible",
       "name": "FreeToken local",
       "options": {
         "baseURL": "http://127.0.0.1:1919/v1"
       },
       "models": {
         "Qwen3.6-35B-A3B": {
           "name": "Qwen3.6-35B-A3B local"
         }
       }
     }
   }
 }
Идентификатор в models должен совпадать с тем, что возвращает локальный /v1/models. После запуска OpenCode модель можно выбрать через /models.
У FreeToken есть и автоматический вариант:
ft launch opencode --dry-run
ft launch opencode
Здесь полезно сначала использовать –dry-run: экосистема OpenCode сейчас развивается быстро, поэтому конфиг, который пишет свежая версия FreeToken, надёжнее копии из старого гайда.
Сколько FreeToken выдаёт на практике
Скорость локальной LLM удобно измерять в tok/s, но одна цифра плохо описывает работу агента. Для Qwen3.6-35B-A3B авторы получили 39,3 tok/s на ноутбучной RTX 4060 с 8 ГБ VRAM. В той же статье пунктиром отмечена медианная скорость облачного Codex из производственных трасс: 33 tok/s.
На RTX 5090 Qwen3.6-35B-A3B показывала 77–83 tok/s, а скорость DeepSeek-V4-Flash составляла 22–25 tok/s. GLM-5.2 с 753 млрд параметров на одной RTX PRO 6000 достигала 14,9 tok/s. Эти числа относятся к конкретным моделям, железу, форматам весов и тестовым сценариям из публикации разработчиков, поэтому переносить их один к одному на другую машину не стоит.
Сравнение времени до первого токена
В агентных тестах FreeToken удерживал худший TTFT ниже 44 секунд. В отдельных сопоставимых сценариях показатель llama.cpp доходил примерно до 232 секунд, у Ollama доходил до 179 секунд, у KTransformers до 946 секунд. Эти значения приведены в экспериментальной части публикации FreeToken.
Для обычного чата можно сильнее замечать скорость уже начавшейся генерации. Кодовый агент ведёт себя иначе. Он получает контекст проекта, делает небольшой ход, вызывает инструмент, получает результат и снова отправляет расширенную историю модели. Каждый новый запрос начинается со стадии префилла.
Поэтому время до первого токена для агента иногда важнее красивого максимального tok/s. Если одна операция чтения файла добавила две минуты ожидания перед следующим коротким ответом, высокая скорость последующих двадцати строк ситуацию уже не спасёт. FreeToken как раз оптимизирует повторный префилл, перенос экспертов и повторное использование состояния между ходами.
Где FreeToken ломается
Локальный инференс снимает плату за облачную генерацию, но добавляет несколько ограничений, которые стоит учитывать до скачивания сотен гигабайт весов.
- Конфигурация с 16 ГБ VRAM отсутствует в основных исходных замерах статьи. Авторы показывают 8, 24, 32 и 96 ГБ на разных машинах. Поэтому точную скорость популярной карты с 16 ГБ из этой таблицы вывести нельзя: результат зависит от модели, кванта, RAM и пропускной способности системы.
- Регистрация памяти для DMA может быть недоступна на отдельных конфигурациях ОС и драйвера. В препринте FreeToken авторы описывают fallback: MoE-часть переключается на pure-CPU backend, экспертные веса остаются в pageable host memory, а неэкспертные слои продолжают работать на GPU.
- Формат весов меняет картину производительности. В экспериментах встречаются BF16, MXFP4 и NVFP4, а домашний запуск часто выбирает квант исходя из доступной RAM и VRAM. Поэтому замер одной точности нельзя автоматически переносить на другую.
- Семантическое повторное использование состояния зависит от поведения агента. FreeToken ставит якоря на границах сообщений, thinking-блоков и tool calls. Если другой harness редактирует историю иначе, доля повторно используемого префикса и выигрыш по TTFT тоже изменятся.
Есть ещё электричество. Формула простая: P × H × T. Здесь P означает среднюю мощность всей системы в киловаттах, H показывает часы работы агента, T означает тариф за кВт⋅ч. Например, система со средней мощностью 0,5 кВт за 60 часов работы потребит 30 кВт⋅ч. При условном тарифе 8 ₽/кВт⋅ч это 240 ₽ в месяц. К этой сумме стоит добавить время на установку CUDA, загрузку моделей, подбор кванта и обновления.
Кому выгодна локальная нейросеть для кода, а кому проще платить
Первый сценарий: агент работает часами, запускается по расписанию, разбирает большую кодовую базу, а исходники хочется держать внутри своего контура. Видеокарта уже куплена для игр, ML или разработки. Тогда локальный сервер особенно полезен для стабильного процесса: например, регулярно разбирать issues, готовить изменения и прогонять проверки. Разобрать такие постоянные сценарии можно на программе «ИИ-агенты и автоматизация» от Практикума. Перед переездом на локальную модель полезно также проверить, как снизить расход токенов в текущем облачном сценарии. Для оценки окупаемости разделите ежемесячные расходы на число часов работы агента и сравните стоимость часа с локальным электричеством и обслуживанием.
Второй сценарий: агент открывается пару раз в неделю примерно на полчаса. За месяц набирается четыре-пять часов работы, а локальная схема всё равно требует CUDA, драйвера NVIDIA, места под веса, квантизации и обновлений. Для такой нагрузки сравните месячную подписку со стоимостью электричества и временем на обслуживание. Локальная нейросеть для кода обычно даёт больше экономии при регулярной загрузке; редкие короткие сессии оставляют меньше часов, на которых эта экономия может накопиться.
Частые вопросы
Хватит ли 8 ГБ видеопамяти для локального Claude Code?
Для FreeToken подтверждён запуск Qwen3.6-35B-A3B на ноутбучной RTX 4060 с 8 ГБ VRAM и 32 ГиБ RAM; в этом тесте использовался официальный NVFP4-чекпоинт. Модель показала 39,3 tok/s. Если вопрос стоит как «сколько видеопамяти нужно для локальной LLM», 8 ГБ можно считать подтверждённой нижней точкой именно для этой конфигурации.
Можно ли запустить FreeToken на AMD или на встроенной графике?
Основной стабильный путь FreeToken сейчас использует NVIDIA и CUDA 13. Направление AMD ROCm в документации помечено как work in progress, а встроенная графика не входит в опубликованные тестовые конфигурации. Для Apple Silicon и других архитектур нужен рантайм с нативной поддержкой соответствующего железа.
Сильно ли локальная модель уступает Sonnet и GPT в качестве кода?
Единой цифры качества нет. Публикация FreeToken посвящена системной производительности инференса, TTFT и tok/s; полного сравнительного бенчмарка качества Qwen3.6, DeepSeek-V4-Flash и GLM-5.2 против актуальных Sonnet или GPT в ней нет. Для своего проекта качество лучше проверить на типичных задачах: исправлении багов, тестах, навигации по репозиторию и многофайловых изменениях.
Что будет с лимитами и подпиской, если полностью уйти на локальную модель?
Запросы, которые уходят на 127.0.0.1:1919, обслуживает локальный FreeToken, поэтому они не расходуют облачные токены модели. Команда ft launch дополнительно очищает облачные API-ключи в дочернем окружении, чтобы агент не переключился на платный endpoint. Оформленная подписка при этом продолжает действовать, пока вы сами её не измените или не отмените.
Нужен ли интернет после того, как модель скачана?
После установки зависимостей и загрузки весов самому локальному инференсу внешний API модели не нужен. Агенту интернет может понадобиться для его инструментов: скачивания пакетов, обращения к GitHub, документации или обновлениям. Полностью офлайн-режим определяется задачей агента и набором разрешённых инструментов.
Заключение
На выходе у нас есть понятная схема: ставим FreeToken, поднимаем локальный API и подключаем к нему Claude Code, Codex или OpenCode. Перед выбором модели сверяем VRAM, RAM, квант и реальную нагрузку агента.
Когда железо уже настроено, следующий предел задаёт сценарий агента: контекст, инструменты и число ходов. Проектирование таких процессов входит в обучение Практикума по ИИ-агентам и автоматизации. Если видеокарта уже есть, агент работает регулярно, а код хочется держать локально, FreeToken даёт практический способ запустить Claude Code локально и заменить расход облачных токенов собственными вычислениями.
Советуем дополнительно почитать
GitHub-репозитории про ИИ 2026 — подборка живых open-source-проектов вокруг ИИ, где можно подсмотреть, как устроены инструменты вроде FreeToken.
ИИкономика: рынок ИИ, токены и инфраструктура — откуда берётся цена токена и почему железо и облака стоят столько, сколько стоят.
Что такое MLOps — как модели доезжают до продакшена и кто их там сопровождает; продолжение темы «поднял локальный сервер».
Подписка на ИИ-инструменты за счёт компании — как убедить работодателя оплатить облачные лимиты, если локальный запуск вам не подходит.
ИИ-навыки разработчика 2026 — что из работы с агентами и моделями действительно нужно уметь программисту в этом году.
Бонус для читателей
Если вам интересно погрузиться в мир IT и при этом немного сэкономить, держите наш промокод на курсы Практикума. Он даст вам скидку при оплате, поможет с льготной ипотекой или безлимитом на маркетплейсах. Ладно, окей, это просто скидка, без остального, но хорошая.