За последний год моделей с открытыми весами вышло столько, что выбор между ними стал отдельной задачей, ничуть не проще выбора фреймворка для нового проекта. При этом «открытые» почти никогда не значит «делайте с ними что хотите»: у каждой модели своя лицензия, и часть из них накладывает ограничения, о которых узнают уже после запуска продукта.
А размер модели в названии вообще ничего не говорит о том, запустится ли она на вашей машине: две модели на 27 миллиардов параметров могут различаться по требованиям к памяти в разы, в зависимости от квантизации.
В этой статье разбираемся, чем открытые веса отличаются от полноценного открытого исходного кода, как быстро прочитать лицензию и не наступить на грабли и, самое практичное, как посчитать, влезет ли конкретная модель в вашу видеокарту. Отдельно — подборка моделей с открытыми весами из России и расчёт, когда локальный запуск дешевле облачного API, а когда нет.
ВАМ ПРИШЛО ПРИГЛАШЕНИЕ 💌
Приходите к нам в соцсети поделиться своим мнением и почитать, что пишут другие. А ещё там выходит дополнительный контент, которого нет на сайте — шпаргалки, опросы и разная дурка. В общем, вот тележка, вот ВК — велком!
Чем открытые веса отличаются от открытого кода
Путаница между открытыми весами и открытым исходным кодом мешает почти всем, кто впервые сталкивается с темой. Термин «нейросети с открытым исходным кодом» здесь неточен: чтобы модель была открытой в том же смысле, что и открытое ПО, вместе с весами должны публиковаться код обучения, скрипты подготовки данных и подробное описание датасета. На практике это редкость.
Что вы получаете вместе с весами
Скачивая модель с открытыми весами, вы получаете файлы в формате safetensors или GGUF (это способы хранить обученные веса на диске, от «сырого» формата для GPU до сжатого для CPU-инференса), конфиг архитектуры, токенизатор и карточку модели с описанием. Сами веса — это миллиарды чисел, подобранных так, чтобы модель предсказывала следующий токен по обучающим данным.
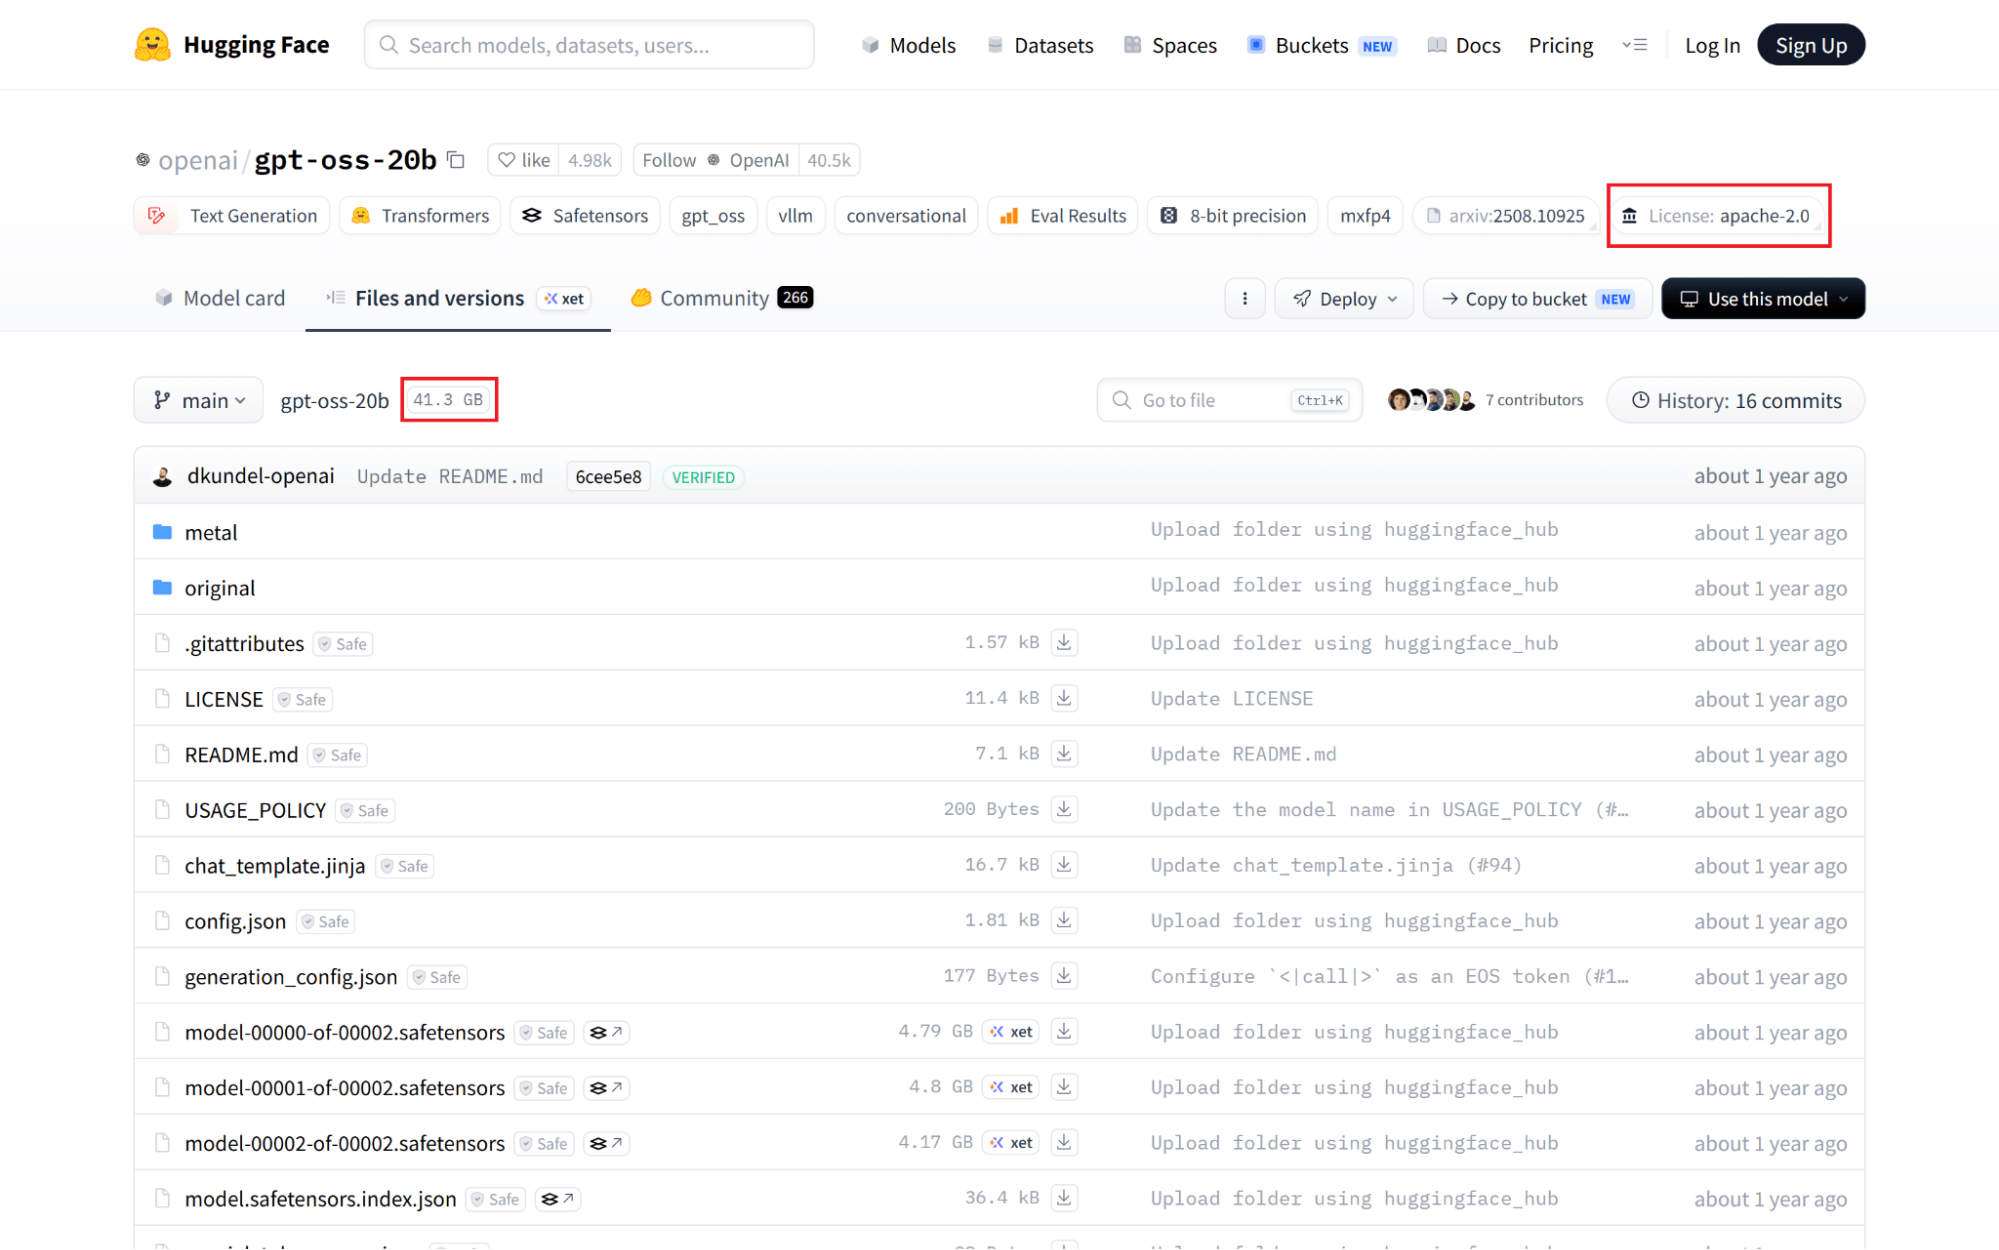
Какие именно данные это были и как их отбирали, вам, как правило, не покажут. Если ещё не работали с платформой, где лежит почти всё перечисленное, почитайте, как устроен Hugging Face.
Почему OSI не считает такие модели открытыми
Open Source Initiative в своём Open Source AI Definition (OSAID) описывает четыре свободы, нужные, чтобы называть систему по-настоящему открытой: использовать её для любой цели, изучать, как она работает, изменять и распространять, в том числе изменённой. Модели с открытыми весами закрывают первую и четвёртую свободы, но не вторую.
Без кода обучения и данных вы не можете полноценно изучить, как модель пришла к своим весам. Сама OSI формулирует это так: «freedom to use the system for any purpose without seeking additional permission» описывает лишь часть картины. Подробности — в самой OSAID.
Зачем запускать модель у себя
Запустить LLM у себя имеет смысл в четырёх случаях. Данные не покидают вашу инфраструктуру, что критично для медицины, финансов и вообще всего, что нельзя отправлять в чужое облако. Модель работает без интернета, что полезно на изолированных стендах и в полевых условиях.
Нет лимитов и модерации провайдера, так что сами решаете, сколько запросов в секунду отправлять и какие темы обсуждать. И наконец, модель можно дообучить под свою узкую задачу, а не подбирать промпт под чужую.
И о минусах, без прикрас: топовые закрытые модели пока обгоняют открытые по качеству на сложных задачах, слабое железо ощутимо режет скорость, а настройка стенда с нуля съедает не один вечер. Если нужно просто быстро закрыть задачу без своего сервера, посмотрите, чем заменить ChatGPT среди облачных сервисов: иногда это быстрее, чем поднимать что-то локально.
Как читать лицензию перед скачиванием
Это самая недооценённая часть темы. Разработчики сравнивают модели по бенчмаркам и почти никогда по лицензиям, а зря: именно лицензия отвечает на вопрос, какие модели можно использовать коммерчески без риска получить письмо от юристов вендора.
Apache 2.0 и MIT
Лицензия Apache 2.0 для нейросетей и лицензия MIT — самые разрешительные варианты на рынке. Обе позволяют коммерческое использование, изменение и распространение производных моделей, требуя лишь сохранить уведомление об авторстве.
Под Apache 2.0 выходят gpt-oss-120b и gpt-oss-20b от OpenAI (117 и 21 млрд параметров, релиз в августе 2025 года), Qwen3.6, Gemma 4 и большая часть открытых моделей Mistral, включая Mistral 7B, Mixtral и Mistral Small.
Google перешла на Apache 2.0 для Gemma только в апреле 2026 года, до этого у неё была отдельная лицензия с ограничениями. А под MIT выходят DeepSeek-V4 и GigaChat3, о которой чуть ниже будет отдельный раздел.
Условные лицензии вендоров
Llama Community License от Meta формально разрешает коммерческое использование, но с условиями: если у вашего продукта больше 700 миллионов активных пользователей в месяц, нужна отдельная лицензия напрямую от Meta, а в интерфейсе продукта требуется указать «Built with Llama».
Modified MIT у Kimi K2 устроена мягче: это обычная лицензия MIT с одним дополнением. При обороте выше 100 млн активных пользователей в месяц или 20 млн долларов месячной выручки нужно заметно показать название модели в интерфейсе. Почитайте, как веса Kimi выложили бесплатно, если хотите разобраться в подробностях.
Собственная лицензия MiniMax хорошо показывает, как условия могут меняться от версии к версии. Модели M2 и M2.5 распространяются под обычной MIT, а вот более новая M2.7 вышла под лицензией, которую компания сама называет Modified-MIT, хотя по сути это некоммерческая лицензия: для любого коммерческого использования нужно письменное разрешение MiniMax.
Сообщество раскритиковало такое название за вводящую в заблуждение формулировку, поэтому при работе с M2.7 читайте текст лицензии целиком, а не полагайтесь на название.
Большая скидка — 16% на все курсы Практикума
Если вы читаете эту статью, тогда вы точно разбираетесь в технологиях. Стать лучше и зарабатывать больше можно после курсов Практикума — по программированию, анализу данных и искусственному интеллекту.
До 30 сентября на все курсы действует скидка 16%, она применится автоматически при оплате. Потом цены станут выше, поэтому не откладывайте!
Ещё нет своего сервиса поверх API модели и не хватает уверенности в асинхронном Python — берите «Мидл Python-разработчик»; уже собрали RAG и агента, но пока не считали качество ответов и бюджет — «ИИ-инженер»; вывели сервис в прод и хотите забрать себе эксплуатацию и мониторинг — «MLOps для разработки и мониторинга моделей».
Что проверить перед коммерческим использованием
Пять пунктов, с которыми стоит свериться перед тем, как строить продукт на открытой модели:
- тип лицензии: Apache 2.0, MIT или лицензия конкретного вендора со своими условиями;
- ограничение по числу активных пользователей или выручке, после которого нужна отдельная договорённость;
- требования к атрибуции, нужно ли показывать название модели в интерфейсе продукта;
- условия по дообучению и распространению производных моделей, можно ли обучать на выходах модели свою собственную;
- отдельная лицензия на датасет, если он опубликован отдельно от весов.
| Модель | Лицензия | Разрешено | Запрещено / условие |
| gpt-oss-120b / gpt-oss-20b | Apache 2.0 | коммерческое использование, изменение, файнтюн | действует отдельная usage policy OpenAI |
| Qwen3.6-27B | Apache 2.0 | коммерческое использование, дообучение, распространение | нет |
| Gemma 4 | Apache 2.0 | коммерческое использование без ограничений | нет |
| DeepSeek-V4 | MIT | коммерческое использование, модификация | нет |
| GigaChat3 | MIT | коммерческое использование, модификация | нет |
| Llama (3.x/4) | Llama Community License | коммерческое использование, дообучение | лицензия у Meta при 700 млн+ MAU, атрибуция «Built with Llama», запрет обучать конкурирующие модели на выходах |
| Kimi K2 | Modified MIT | коммерческое использование | атрибуция в интерфейсе при 100 млн+ MAU или 20 млн USD выручки в месяц |
| MiniMax M2 / M2.5 | MIT | коммерческое использование без ограничений | нет |
| MiniMax M2.7 | Modified-MIT (некоммерческая) | некоммерческое использование, локальный запуск, исследования | коммерческое использование только с письменного разрешения MiniMax |
Таблица — это срез на конкретный момент, а не гарантия на будущее: у MiniMax, как уже говорили, лицензия успела измениться между версиями M2.5 и M2.7. Прежде чем закладывать модель в архитектуру продукта, стоит открыть её карточку на Hugging Face и прочитать лицензию в оригинале, а не полагаться на пересказ, благо это обычно буквально пара абзацев текста.
Как понять, влезет ли модель в ваше железо
Здесь начинается практика, ради которой все читают эту статью.
Формула расчёта видеопамяти
Нужная видеопамять примерно равна числу параметров модели, умноженному на количество байт на параметр, плюс 10–20% сверху на контекст и KV-кэш: это буфер, где модель хранит промежуточные вычисления по уже сгенерированному тексту, чтобы не пересчитывать их заново на каждом токене.
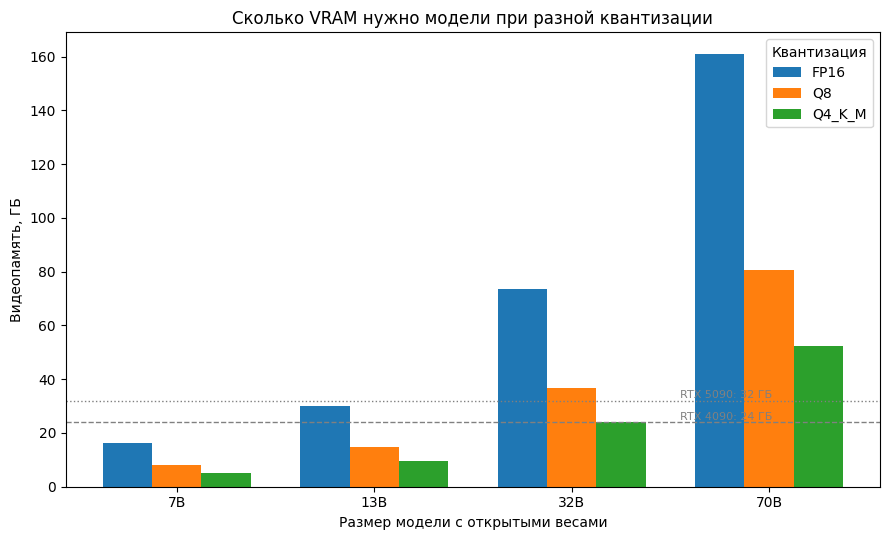
Разберём на T-Pro 2.0, открытой модели Т-Банка на 32 млрд параметров под Apache 2.0. В FP16 (около 2 байт на параметр) вес потребует 32 × 2 × 1,15 ≈ 73,6 ГБ, это уровень серверных карт.
В Q8 (около 1 байта на параметр) получится 32 × 1 × 1,15 ≈ 36,8 ГБ, впритык не влезет даже в RTX 5090 с её 32 ГБ.
А вот в Q4_K_M (0,5–0,7 байта на параметр) модель займёт 32 × 0,65 × 1,15 ≈ 23,9 ГБ, и это уже укладывается в RTX 4090 или RTX 5090.
Что делает квантизация
Квантизация — это сжатие весов модели до меньшей точности хранения чисел, чтобы модель занимала меньше памяти ценой небольшой потери качества. FP16 даёт примерно 2 байта на параметр и эталонное качество, Q8 — около 1 байта с почти незаметной потерей, Q4 — 0,5–0,7 байта с заметной, но обычно приемлемой просадкой.
Q4_K_M стал стандартным компромиссом для локального запуска именно потому, что на большинстве задач разница с Q8 на глаз не ощущается, а разница в памяти почти двукратная.
Активные параметры у MoE-моделей
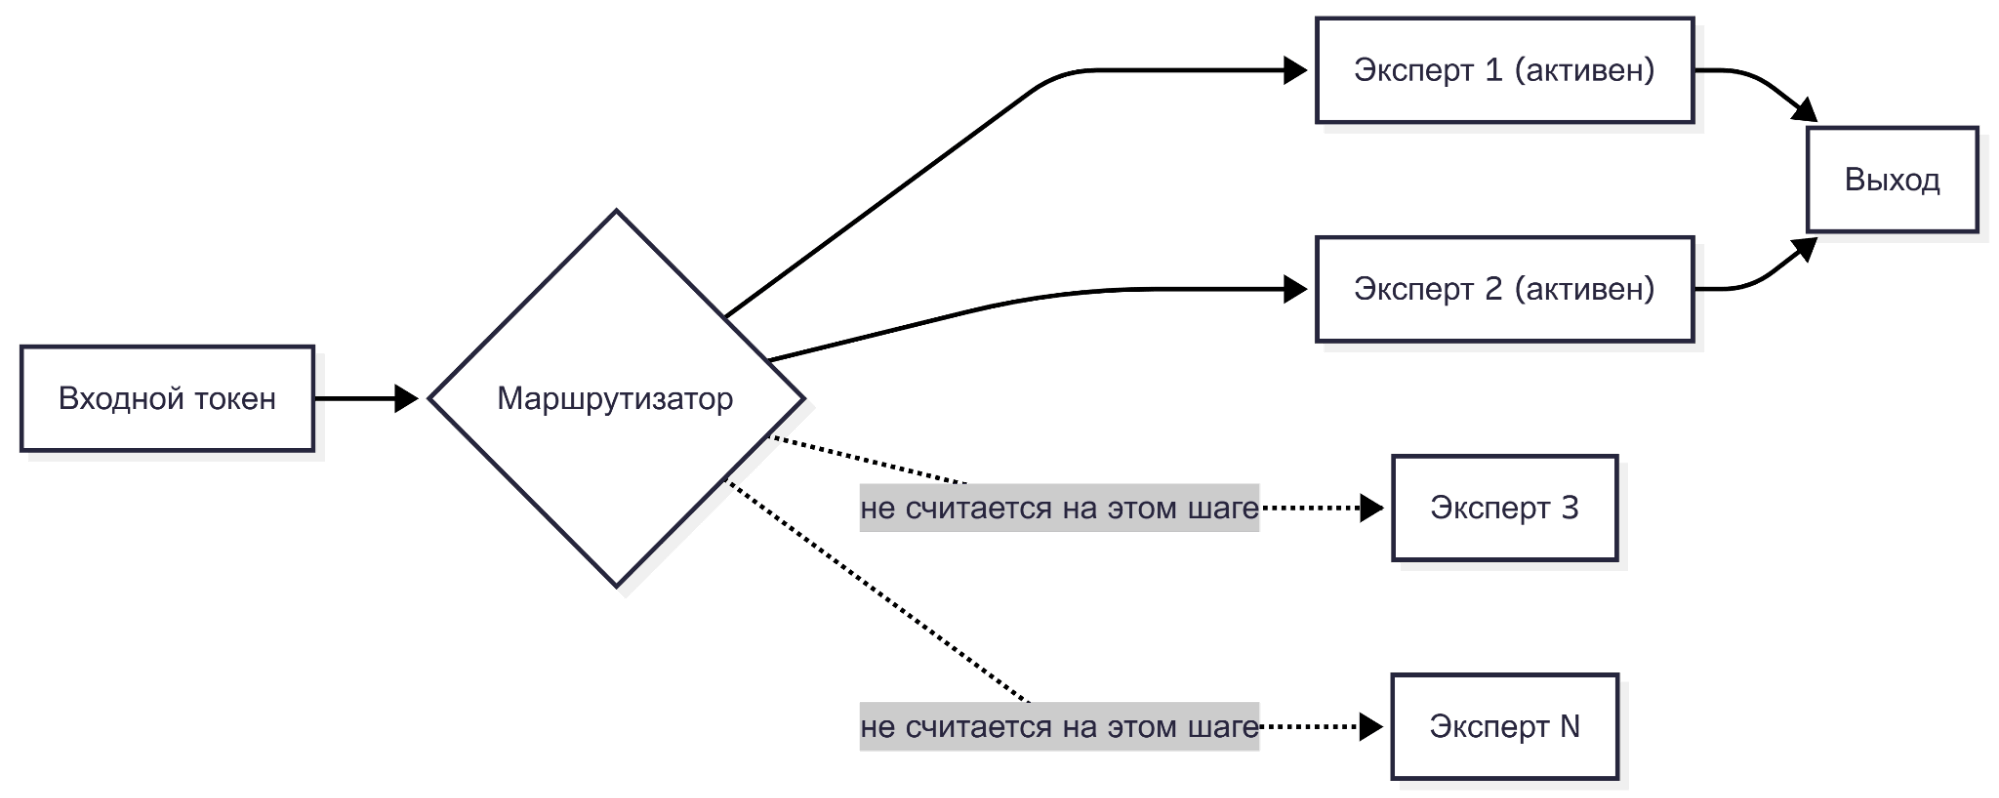
Здесь чаще всего путаются новички. MoE (Mixture-of-Experts, «смесь экспертов») — архитектура, где на каждый токен работает не вся модель целиком, а только часть «экспертов», которых выбирает отдельный маршрутизатор.
В названии GigaChat3-702B-A36B первое число — это общий размер модели, все веса вместе, а второе (A36B) обозначает активные параметры, то есть сколько из них реально считается на каждом шаге генерации. Память нужна под все 702 млрд параметров сразу, потому что заранее неизвестно, какие эксперты понадобятся на следующем токене.
А вот скорость генерации определяется активными 36 миллиардами, отсюда и разрыв между требованиями к памяти и реальной скоростью у MoE-моделей.
Оперативная память и unified memory на Mac
Если модель не влезает в видеопамять целиком, часть слоёв можно выгрузить в обычную оперативную память. Это работает, но скорость падает в несколько раз, потому что обмен данными между CPU и GPU намного медленнее, чем между GPU и его собственной памятью.
У Mac на Apple Silicon память общая для CPU и GPU (unified memory), поэтому там нет жёсткой границы между VRAM и RAM. Если в системе 64 или 128 ГБ, модель может использовать почти весь этот объём напрямую, без выгрузки.
Какие модели запускаются на разном железе
Это смысловое ядро статьи, поэтому сразу сводная таблица, а дальше разбор по классам железа. Опорные цифры для Q4-квантизации: 7–8B требуют 6–8 ГБ, 13–14B требуют 8–12 ГБ, 32B требуют 20–24 ГБ, а 70B — от 40 ГБ.
| Конфигурация | Размер модели | Примеры | Скорость (ток/с, ориентировочно) |
| Ноутбук без дискретной GPU | до 8B, Q4 | Qwen3.6 8B, T-Lite | 3–10 |
| GPU 8–12 ГБ (RTX 3060 и похожие) | 7–14B, Q4–Q5 | T-Lite, дистилляты 14B, Qwen3.6-27B в агрессивной квантизации | 15–30 |
| GPU 16–24 ГБ (RTX 4090) | до 32B | T-Pro 2.0, Qwen3.6-27B, gpt-oss-20b | 100+ на 7B, 30–50 на 32B |
| GPU 32 ГБ (RTX 5090) | 32B в Q8 или 70B в Q4 | T-Pro 2.0 в Q8, Llama 70B в Q4 | 25–45 на 32B |
| Mac, unified memory 64–128 ГБ (M4/M5 Max) | до 70B | Llama 3.3 70B, дистилляты DeepSeek | 20–30 |
| Рабочая станция/сервер, несколько H100 | 100B+ | GigaChat3-702B-A36B, DeepSeek-V4-Pro (1,6 трлн параметров, 49 млрд активных), gpt-oss-120b | зависит от конфигурации |
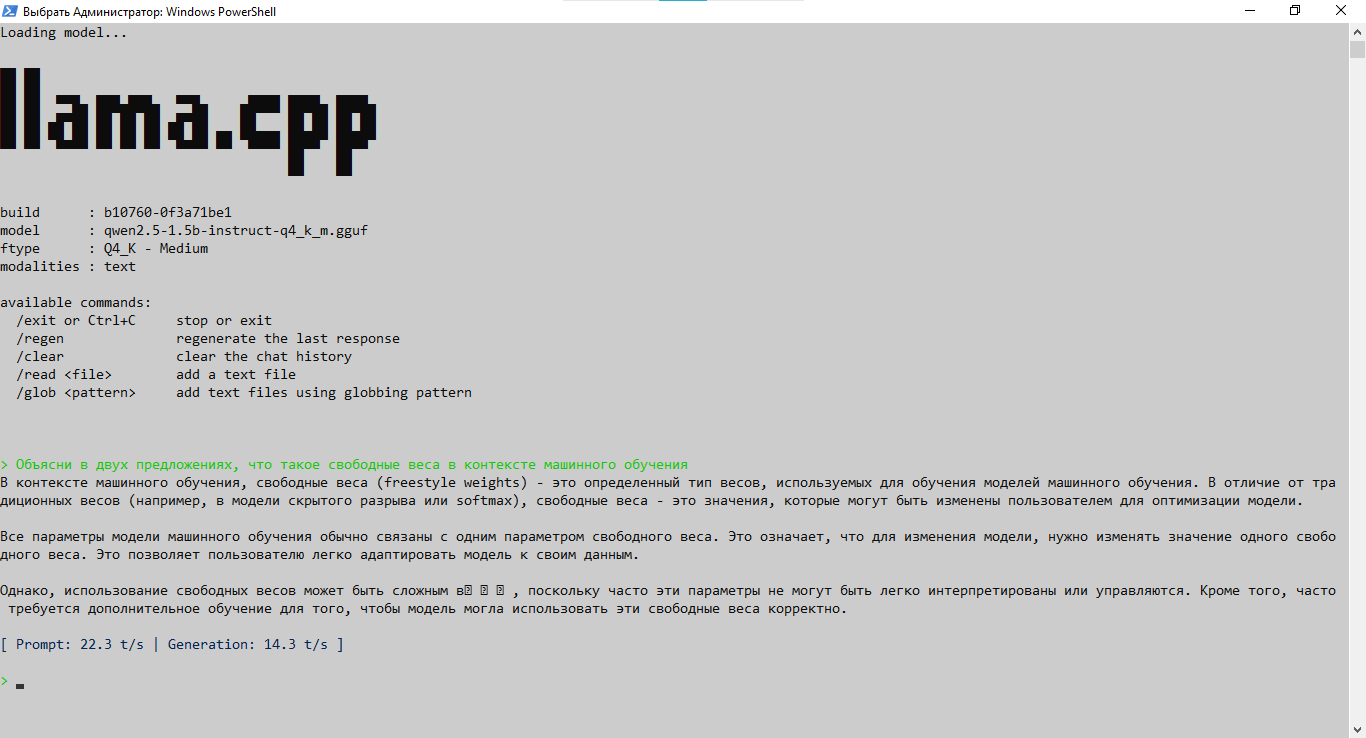
Ноутбук без дискретной видеокарты
На процессоре и встроенной графике реалистично рассчитывать на модели до 8 млрд параметров в Q4: это Qwen3.6 8B или похожие по размеру инструктивные модели. Скорость будет на уровне «текст появляется заметно медленнее, чем вы читаете», единицы токенов в секунду, и это нормально для черновых экспериментов, а не для продакшена.
Видеокарта на 8–12 ГБ
RTX 3060 и аналоги — рабочая лошадка для диапазона 7–14B в Q4–Q5. Модель Qwen3.6-27B (Apache 2.0, полный вес 55,6 ГБ) в агрессивной квантизации формально помещается в 12 ГБ, но уже на грани возможностей. Ответ на вопрос, какая модель влезет в 12 ГБ видеопамяти, здесь звучит так: влезет, но с оговорками по скорости и качеству.
Видеокарта на 16–32 ГБ
RTX 4090 с 24 ГБ тянет модели до 32B и выдаёт свыше 100 токенов в секунду на 7B, этого достаточно для комфортного продакшен-инференса небольшого сервиса. RTX 5090 с 32 ГБ (GDDR7, 575 Вт) добавляет запас под Q8-квантизацию тех же 32B-моделей или под 70B в Q4, хотя для полноценного FP16-инференса 70B всё равно понадобится несколько карт.
Мак с большой унифицированной памятью
M4 и M5 Max с 64–128 ГБ unified memory запускают модели класса 70B на скорости 20–30 токенов в секунду. Это медленнее топовой дискретной видеокарты, зато без нужды выгружать слои и с ощутимо меньшим энергопотреблением.
Рабочая станция и сервер
Флагманские MoE-модели вроде GigaChat3-702B-A36B и DeepSeek-V4-Pro (1,6 трлн параметров всего, 49 млрд активных, лицензия MIT) требуют нескольких карт H100 даже в квантизации. Для домашнего запуска это нереалистично, да и незачем: их выкладывают не для локального инференса на ноутбуке, а как эталон качества, который может себе позволить прогнать облачный провайдер, и как базу для дистилляции меньших моделей.
gpt-oss-120b здесь исключение: она уместилась в единственную карту на 80 ГБ. На вопрос, какая самая мощная бесплатная нейросеть для локального запуска, у железа находится один прямой ответ: та, что реально влезает в вашу конфигурацию, а не та, что выше в рейтинге.
Если интересно, как устроены китайские открытые модели этого класса, у «Кода» есть отдельный разбор, а также материал про Kimi K2-Thinking как конкурента GPT-5.
За общей картиной по железу, включая то, что нужно для облачных сервисов вроде ChatGPT, можно заглянуть в материал о том, как выбрать свою LLM.


Российские модели с открытыми весами
20 ноября 2025 года на конференции AI Journey Сбер выложил в открытый доступ под лицензией MIT сразу несколько семейств моделей: самый крупный подобный релиз среди российских компаний. В линейку GigaChat3 вошли флагманская GigaChat3-702B-A36B-preview (MoE, 702 млрд параметров всего и 36 млрд активных, доступна в fp8 и bf16) и компактная GigaChat3-10B-A1.8B.
Тогда же вышел Kandinsky 5.0, генератор изображений и видео, где версия Video Lite (2 млрд параметров, Apache 2.0) рассчитана на видеокарты от 12 ГБ, а Image Lite на 6 млрд параметров работает и на более скромном железе.
Отдельно Сбер обновил линейку моделей распознавания речи GigaAM-v3: в неё вошли самообучающийся кодировщик и по две модели распознавания на декодерах CTC и RNN-T с нормализацией пунктуации, пять моделей в сумме, все под MIT.
Т-Банк открыл свои модели раньше и по частям. T-Lite на 7–8 млрд параметров вышел в июле 2024 года, а T-Pro 2.0 на 32 млрд параметров — в июле 2025-го, обе под Apache 2.0 и обе на Hugging Face в организации t-tech.
Сообщество Vikhr с 2023 года дообучивает под русский язык модели на архитектурах Mistral и Nemo, среди них Vikhr-Nemo-12B и Vistral-24B, тоже преимущественно под Apache 2.0, и делится результатами на Hugging Face открыто, вместе с датасетами и кодом обучения.
| Модель | Размер | Лицензия | Где лежит |
| GigaChat3-702B-A36B-preview | 702B, 36B активных | MIT | Hugging Face, организация ai-sage |
| GigaChat3-10B-A1.8B | 10B, 1,8B активных | MIT | Hugging Face, организация ai-sage |
| Kandinsky 5.0 Video Lite | 2B | Apache 2.0 | Hugging Face, организация kandinskylab |
| GigaAM-v3 (5 моделей) | компактные акустические модели | MIT | Hugging Face / GitHub, salute-developers |
| T-Lite | 7–8B | Apache 2.0 | Hugging Face, организация t-tech |
| T-Pro 2.0 | 32B | Apache 2.0 | Hugging Face, организация t-tech |
| Vikhr (Nemo, Vistral и другие) | 7–24B | Apache 2.0 | Hugging Face, организация Vikhrmodels |
Модели для картинок, видео, речи и кода
Открытые модели ИИ существуют далеко за пределами текстовых LLM. Тема открытых весов на них не заканчивается. Для генерации изображений, кроме уже упомянутого Kandinsky 5.0, стоит посмотреть на модели линейки Stable Diffusion: компактные версии запускаются на 8 ГБ VRAM. Для видео Kandinsky 5.0 Video Lite и Video Pro (19 млрд параметров, нужно от 24 ГБ) конкурируют с открытыми моделями линейки Wan и обгоняют их по качеству понимания русскоязычных запросов.
В распознавании и синтезе речи открытые веса есть и у GigaAM-v3, и у моделей семейства Whisper, разница в основном в качестве на русском языке не в пользу Whisper. Для кода отдельного внимания заслуживают инструктивные версии Qwen и DeepSeek: они обучены на большом объёме исходного кода и хорошо справляются с автодополнением и код-ревью.
Про генерацию изображений отдельно можно почитать в материале про нейросети для улучшения изображений, а про игровые сценарии в подборке ИИ-инструментов для создания игр.
Чем запускать модель
Бесплатные LLM для локального запуска не работают сами по себе, им нужна программа-обвязка. Ollama удобна для терминала и локального API, LM Studio подходит тем, кому нужен интерфейс без консоли, llama.cpp хорош для тонкой настройки под конкретное железо, а vLLM — для сервера под нагрузкой. Инференс — это процесс генерации ответа уже обученной моделью, в отличие от обучения.
Подробный разбор интерфейсов и системных требований каждого инструмента есть в материале про топ-10 инструментов для локального запуска, здесь эту тему дублировать не будем.
Отдельно про то, как скачать модель с Hugging Face: на странице модели ищите файлы с суффиксом -Instruct или -it, это инструктивная версия, обученная выполнять команды и вести диалог, а не просто продолжать текст. Базовая версия без такого суффикса для обычного использования не годится. Больше готовых репозиториев и обвязок в подборке AI-репозиториев на GitHub.
Сколько на самом деле стоит бесплатная модель
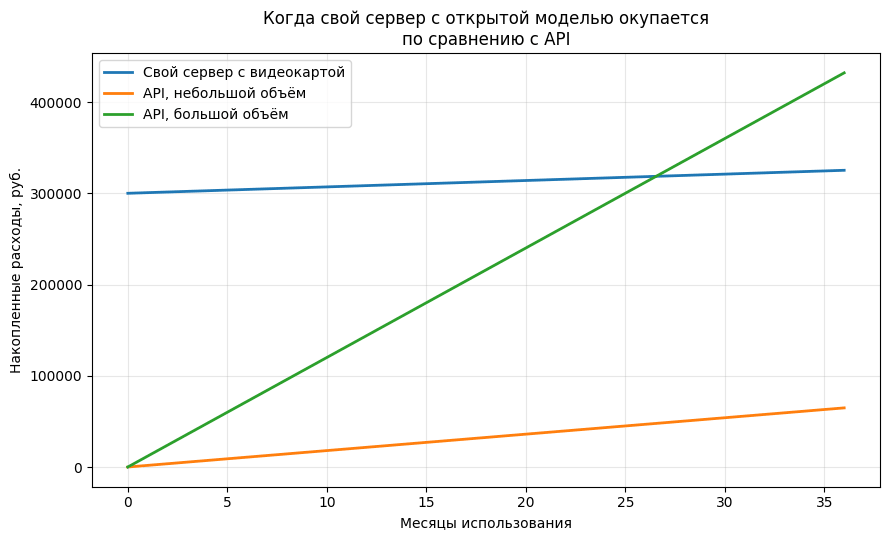
Бесплатные веса не значат бесплатный запуск. Возьмём пример: видеокарта нужного класса стоит около 300 000 рублей по ценам розницы, а электричество при постоянной нагрузке около 350 Вт по 8 часов в день обходится в порядка 700 рублей в месяц по актуальному московскому тарифу.
При амортизации карты на 3 года получаем примерно 8300 рублей в месяц только на железо плюс 700 рублей на электричество, итого около 9000 рублей в месяц без учёта времени на настройку и обновления. Для сравнения, при небольшом объёме запросов счёт за облачное API может составлять 1500–2000 рублей в месяц, так что свой сервер отобьётся, только если вы обрабатываете десятки миллионов токенов ежемесячно.
Вывод простой: для небольшой команды с умеренным трафиком открытые нейросети на своём железе почти всегда дороже API в моменте, а окупаемость наступает при действительно большом объёме запросов.
Но есть сценарии, где локальный запуск оправдан независимо от денег: работа с чувствительными данными, которые нельзя отправлять наружу, необходимость работать офлайн и разработка, где важна предсказуемость задержки, а не экономия на токенах.
Ошибки при выборе открытой модели
Открытые веса (open weights модели) заманчивы своей бесплатностью, и именно поэтому с ними чаще совершают одни и те же ошибки.
- Ориентироваться на общее число параметров вместо активных у MoE: сравнивайте активные параметры, память всё равно считается по полному размеру.
- Скачивать базовую модель вместо инструктивной: без суффикса
-Instruct/-itмодель не годится для диалога. - Брать максимальный размер, который влезает в железо, а не тот, что нужен под задачу: лишние параметры почти всегда означают лишнюю задержку.
- Игнорировать лицензию до релиза продукта: читайте условия сразу, а не когда продукт уже написан под конкретную модель.
- Забывать про KV-кэш при длинном контексте: закладывайте дополнительные 15–20% видеопамяти под долгие диалоги и RAG.
- Оценивать модель по бенчмаркам вместо своих задач: высокий результат в рейтинге не гарантирует качество на вашем конкретном промпте.
- Не проверять дату релиза и версию модели: рынок обновляется каждые несколько недель, и вчерашний лидер рейтинга уже может уступать свежей версии.
Если модель нужна для код-ревью, взгляните на подборку промптов для код-ревью с ИИ: часть советов оттуда применима и к локальным моделям.
С чего начать
Короткий план, если вы дочитали до сюда и хотите наконец что-то запустить.
- Посмотрите объём видеопамяти своей карты (или объём unified memory, если у вас Mac).
- Выберите размер модели по таблице из раздела про железо.
- Поставьте один инструмент: Ollama или LM Studio достаточно для старта.
- Пора скачать модель с Hugging Face, обязательно инструктивную версию в Q4-квантизации.
- Прогоните модель на своих реальных задачах, а не на чужих бенчмарках.
- Меняйте модель или железо только после этого шага и только если результата действительно не хватает.
Модели с открытыми весами хороши именно тем, что этот план можно повторить за вечер и почти бесплатно. Дальше решать вам, что делать с результатом.
Частые вопросы
Открытые веса и открытый исходный код — это одно и то же? Нет. Открытые веса дают файлы модели, конфиг и токенизатор, но обычно не дают код обучения и данные. Полноценный открытый исходный код по определению OSI требует ещё и того, и другого.
Можно ли использовать модель с открытыми весами в коммерческом продукте? Смотря по лицензии. Apache 2.0 и MIT разрешают это без ограничений, а вендорские лицензии вроде Llama Community License или Modified MIT у Kimi K2 вводят пороги по числу пользователей или выручке, после которых нужна отдельная договорённость.
Какая модель запустится на видеокарте с 8 ГБ памяти? Модели на 7–8 млрд параметров в Q4-квантизации, например компактные версии Qwen или T-Lite. Более крупные модели в 8 ГБ поместятся только в самой агрессивной квантизации с заметной потерей качества.
Насколько локальная модель уступает облачным сервисам по качеству? На сложных задачах, вроде рассуждения или длинных агентных сценариев, топовые закрытые модели пока обгоняют открытые. На типовых задачах вроде суммаризации или базового код-ревью разница часто незаметна.
Есть ли российские модели с открытыми весами? Да: GigaChat3 и Kandinsky 5.0 от Сбера, T-Lite и T-Pro 2.0 от Т-Банка, а также модели сообщества Vikhr, дообученные под русский язык.
Нужна ли видеокарта или хватит процессора? Для моделей до 8 млрд параметров в Q4 хватит и процессора, хоть и на скорости в единицы токенов в секунду. Для комфортной работы с более крупными моделями видеокарта нужна.
Советуем дополнительно почитать
Аналоги ChatGPT в 2026 году: 20 нейросетей — честное сравнение — облачные альтернативы на случай, когда своя видеокарта не тянет, а задачу нужно закрыть здесь и сейчас.
11 топовых китайских нейросетей: дешевле ChatGPT и Claude в 20 раз — GLM, DeepSeek, Qwen и Kimi K2.5 со сравнением цен API и запуска через Ollama, шире, чем лицензионный разбор из этой статьи.
6 нейросетей и ИИ-инструментов, чтобы создать свою игру — открытые и закрытые модели для геймдева, включая генерацию графики и код по Model Context Protocol.
20 AI GitHub-репозиториев для разработчика в 2026 году — Ollama, llama.cpp, Whisper и Stable Diffusion WebUI в связке с фреймворками и агентными оркестраторами, если одного запуска модели мало.
Как выбрать LLM для кода: почему дешёвая модель обойдется дороже — расчёт реальной стоимости решённой задачи, а не цены за токен, применимо и к выбору между локальным железом и облачным API.
Бонус для читателей
Если вам интересно погрузиться в мир IT и при этом немного сэкономить, держите наш промокод на курсы Практикума. Он даст вам скидку при оплате, поможет с льготной ипотекой или безлимитом на маркетплейсах. Ладно, окей, это просто скидка, без остального, но хорошая.