Когда вам срочно нужны данные с сайта, вы пишете простой скрипт на requests и BeautifulSoup, ждете результат и вместо ожидаемых таблиц получаете пустой HTML. Это типичная история: контент на современных сайтах рисует JavaScript, и обычные HTTP-клиенты просто не видят данных, которые подгружаются после загрузки скелета страницы.
В этой статье разберем библиотеку Playwright, которая решает эту проблему. Она умеет открывать настоящий браузер, исполнять JS, кликать по кнопкам и собирать нужную информацию. К концу статьи у вас будет готовый и рабочий скрипт. А если вы хотите узнать про другие инструменты, почитайте наш гайд «Как спарсить что угодно с любого сайта».
ВАМ ПРИШЛО ПРИГЛАШЕНИЕ 💌
Приходите к нам в соцсети поделиться своим мнением и почитать, что пишут другие. А ещё там выходит дополнительный контент, которого нет на сайте — шпаргалки, опросы и разная дурка. В общем, вот тележка, вот ВК — велком!
Что такое Playwright и зачем он нужен
Playwright — это открытая библиотека от Microsoft для управления браузерами прямо из кода. Она предоставляет единый API для Chromium, Firefox и WebKit, и поддерживает языки Python, JavaScript/TypeScript, Java и C#. Выпуск первой версии состоялся в январе 2020 года под лицензией Apache 2.0.
Библиотеку используют для двух основных задач: написание автоматизированных тестов интерфейса (E2E) и сбор данных с сайтов (парсинг), где контент генерируется динамически с помощью JavaScript.
Playwright, Selenium или Puppeteer: что выбрать
Playwright — не единственный инструмент для автоматизации браузера. До него и параллельно с ним для тех же задач используют Selenium и Puppeteer. Все три библиотеки позволяют управлять браузером из кода, но отличаются поддерживаемыми браузерами, языками, подходом к ожиданию элементов и набором возможностей.
Если вы только начинаете работать с браузерной автоматизацией на Python, полезно сначала понять, чем Playwright отличается от основных альтернатив и в каких случаях имеет смысл выбрать именно его.
| Инструмент | Браузеры | Языки | Когда брать |
| Playwright | Chromium, Firefox, WebKit | Python, JS/TS, Java, C# | Нужны автоожидания из коробки, высокая скорость старта и кроссбраузерность |
| Selenium | Практически все | Java, Python, C#, Ruby, JS | Проект завязан на старом легаси-стеке или требуются редкие браузеры (IE) |
| Puppeteer | Chromium, Firefox | JS/TS | Команда пишет исключительно на Node.js и вам хватает движка Chromium |
Selenium — самый старый и распространённый вариант из этой тройки: у него большая экосистема и широкая поддержка браузеров. Puppeteer тесно связан с экосистемой Node.js и хорошо подходит для задач, где достаточно Chromium. Playwright объединяет поддержку нескольких браузерных движков, автоматические ожидания и параллельный запуск тестов, поэтому его часто выбирают для новых проектов.
Устанавливаем Playwright и запускаем первый скрипт
С теорией разобрались — теперь можно запустить Playwright вручную. Для Python установка состоит из двух шагов: сначала ставим саму библиотеку, затем загружаем браузеры, которыми она будет управлять.
На сентябрь 2026 года актуальная версия библиотеки — 1.63. Вместе с ней устанавливаются Chromium 151, Firefox 153 и WebKit 26.6.
Установка для Python
Создайте виртуальное окружение, активируйте его и установите Playwright:
pip install playwright
После этого обязательно скачайте браузеры:
playwright install
Это отдельный шаг, который легко пропустить: пакет Python сам по себе не содержит исполняемые файлы браузеров. Команда playwright install загружает их в окружение Playwright.
Установка для Node.js
В Node.js можно сразу запустить мастер установки Playwright:
npm init playwright@latest
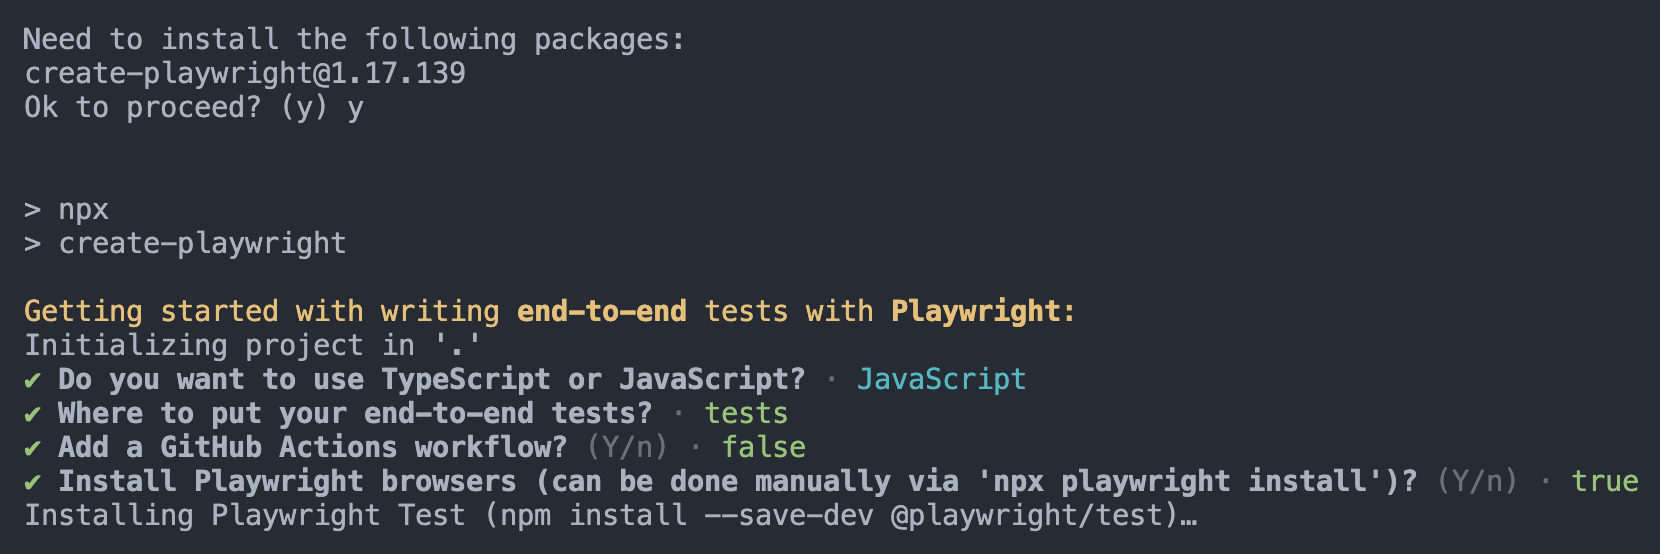
Он создаст базовую структуру проекта и установит необходимые зависимости, включая браузеры.
Первый скрипт
Проверим установку на простом примере. Скрипт откроет браузер, перейдёт на страницу, выведет её заголовок в консоль и сохранит скриншот.
На Python:
from playwright.sync_api import sync_playwright
with sync_playwright() as p:
    # Запускаем Chromium
    browser = p.chromium.launch()
    # Создаём новую вкладку
    page = browser.new_page()
    # Переходим на страницу и ждём её загрузки
    page.goto("https://example.com")
    # Получаем заголовок страницы
    print(page.title())
    # Сохраняем скриншот в файл
    page.screenshot(path="example.png")
    # Закрываем браузер
    browser.close()
На JavaScript:
const { chromium } = require('playwright');
(async () => {
  // Запускаем Chromium
  const browser = await chromium.launch();
  // Создаём новую вкладку
  const page = await browser.newPage();
  // Переходим на страницу и ждём её загрузки
  await page.goto('https://example.com');
  // Получаем заголовок страницы
  console.log(await page.title());
  // Сохраняем скриншот в файл
  await page.screenshot({ path: 'example.png' });
  // Закрываем браузер
  await browser.close();
})();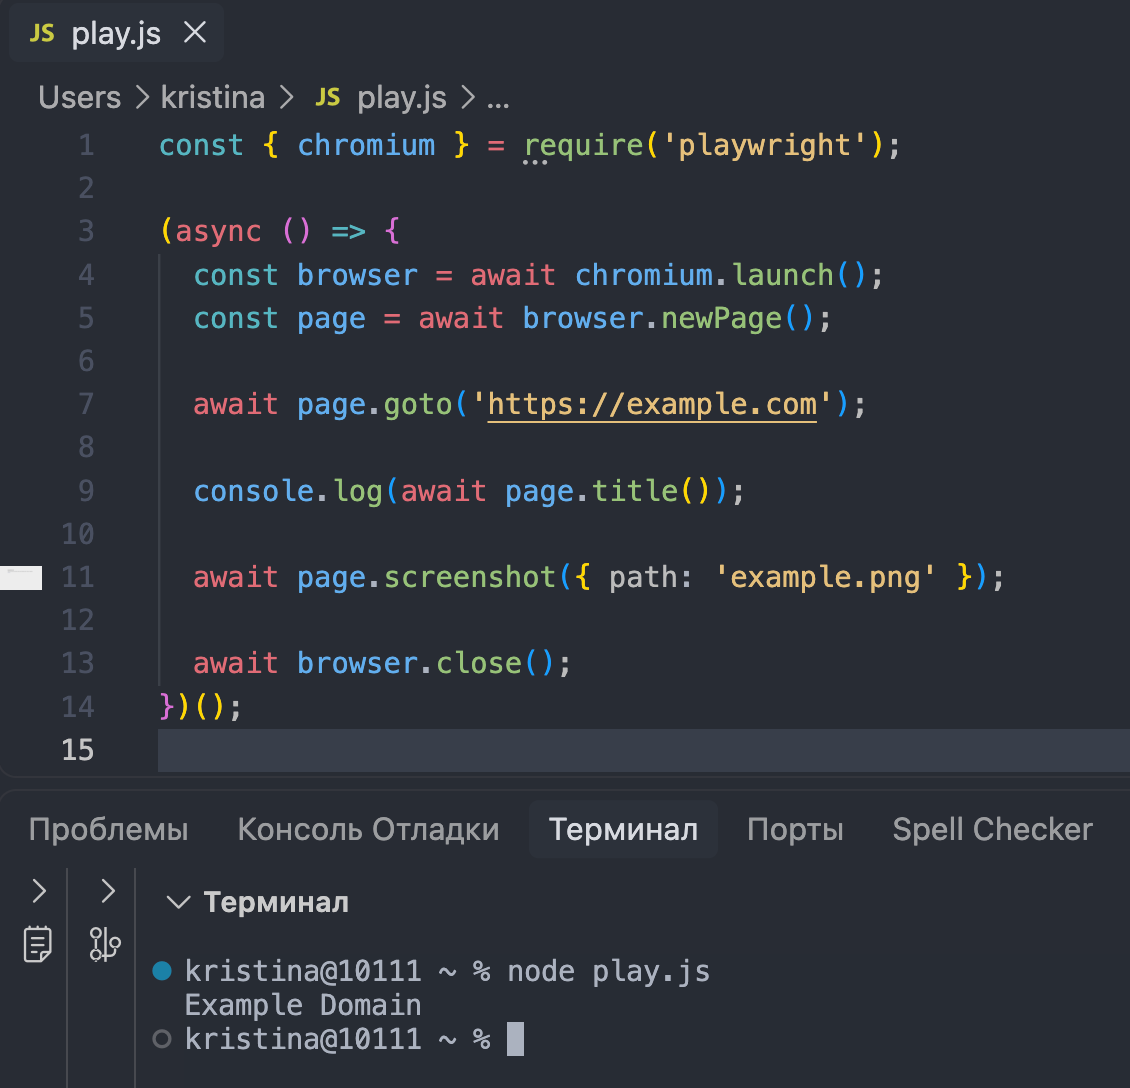
Здесь цепочка действий максимально простая: запустили браузер → открыли вкладку → перешли на страницу → получили данные → сделали скриншот → закрыли браузер. Дальше на этой основе можно добавлять поиск элементов, клики, заполнение форм и другие действия.
Как устроен скрипт: браузер, контекст и страница
В Playwright есть три основных объекта, с которыми вы будете работать почти постоянно: браузер, контекст и страница. Проще всего представить их как уровни вложенности: браузер → контекст → страница.
Сначала запускаем браузер, а внутри него создаём browser context — изолированную сессию браузера. По смыслу это похоже на отдельное окно в режиме инкогнито: у контекста свои куки, хранилища, настройки и данные сессии.
Например, в одном запущенном браузере можно создать два контекста для разных пользователей. Один будет авторизован под аккаунтом А, другой — под аккаунтом Б, и их сессии не будут смешиваться. При этом не нужно запускать два отдельных процесса браузера, поэтому такой подход позволяет экономнее расходовать ресурсы.
Внутри контекста создаётся page — отдельная вкладка, с которой непосредственно работает скрипт: переходит по URL, ищет элементы, кликает по кнопкам, заполняет формы и получает данные.
browser = p.chromium.launch()
# Создаём изолированную сессию
context = browser.new_context()
# Открываем вкладку внутри этой сессии
page = context.new_page()
page.goto("https://example.com")
По умолчанию Playwright запускает браузер в режиме headless: графического окна нет, а браузер работает в фоне. Для серверов и CI это удобно — тестам не нужен подключённый монитор.
Во время разработки, наоборот, полезно видеть браузер своими глазами. Для этого отключаем headless-режим. Параметр slow_mo дополнительно замедляет действия Playwright, чтобы можно было наблюдать за ними:
# Показываем окно браузера и замедляем действия на 50 мс
browser = p.chromium.launch(
    headless=False,
    slow_mo=50
)
В результате при запуске скрипта вы увидите обычное окно Chromium, в котором Playwright сам будет выполнять команды.
Локаторы: как найти нужный элемент
Чтобы кликнуть по кнопке, заполнить поле или прочитать текст, скрипту сначала нужно найти нужный элемент на странице. В Playwright для этого используются локаторы (locator). Они описывают, какой именно элемент нужно найти, а уже потом к нему можно применять действия: click(), fill(), text_content() и другие.
Пользовательские локаторы
Вместо привязки к конкретной структуре DOM Playwright позволяет искать элементы по признакам, которые видны пользователю: роли элемента, тексту, подписи поля или placeholder. Такие локаторы обычно меньше зависят от изменений в вёрстке.
Например:
page.get_by_role(“button”, name=”Отправить”)— найдет кнопку по ее роли и тексту.page.get_by_text(“Добро пожаловать”)— найдет блок с конкретным текстом.page.get_by_label(“Пароль”)— найдёт поле, связанное с подписью «Пароль».page.get_by_placeholder(“Введите email”)— поиск по плейсхолдеру.
Это один из важных принципов Playwright: если элемент можно однозначно найти по его роли или другому понятному пользователю признаку, такой локатор обычно предпочтительнее привязки к классам и структуре HTML.
CSS и XPath
Иногда таких признаков нет или их недостаточно. Например, нужный элемент может быть декоративным блоком без текста или семантической роли. В таких случаях можно использовать обычные CSS-селекторы и XPath через locator().
page.locator(“.card-title > a”)— CSS-селекторpage.locator(“//button[contains(@class, ‘submit’)]”)— XPath
CSS и XPath дают больше контроля над поиском, но сильнее привязывают тест к HTML-коду страницы. Если разработчик поменяет классы или структуру DOM, такой локатор может перестать работать. Подробно о том, как их строить, мы рассказывали в статье «Продвинутый CSS».
Множественные элементы
Локатор может соответствовать не одному элементу, а целому набору — например, карточкам товаров или строкам таблицы. В этом случае можно узнать количество найденных элементов, выбрать конкретный элемент или получить их все для перебора:
locator.count()— сколько элементов найдено.locator.nth(2)— обратиться к третьему элементу в списке (индексация с нуля).locator.all()— возвращает список всех элементов для перебора в цикле.
| Задача | Рекомендуемый локатор |
| Найти кнопку «Войти» | page.get_by_role(“button”, name=”Войти”) |
| Найти поле для ввода email | page.get_by_placeholder(“Email”) |
| Найти чекбокс «Согласен» | page.get_by_label(“Согласен”) |
| Найти третий товар в списке | page.locator(“.product”).nth(2) |
| Подсчитать количество строк | page.locator(“table tr”).count() |
| Найти элемент по атрибуту | page.locator(“[data-testid=’submit’]”) |
Автоожидания: почему в Playwright не нужен sleep
Одна из самых удобных возможностей Playwright — автоматическое ожидание готовности элементов. Если перед каждым кликом писать time.sleep(5), код будет ждать фиксированные пять секунд независимо от того, загрузилась страница уже или ещё нет. В итоге тесты становятся и медленнее, и менее надёжными.
Перед выполнением действия Playwright сам проверяет, можно ли его выполнить. Например, перед кликом библиотека ждёт, пока элемент появится в DOM, станет видимым, перестанет двигаться из-за анимации, перестанет быть перекрыт другим элементом и станет доступен для взаимодействия.
Если элемент пока не готов, Playwright продолжает ждать. Поэтому в большинстве случаев отдельный sleep() вообще не нужен.
# Плохо: ждать фиксированное время
import time
time.sleep(5)
page.get_by_role("button").click()
# Лучше: автоожидание из коробки
page.get_by_role("button").click()
В первом варианте скрипт потратит пять секунд даже на страницу, которая загрузилась за полсекунды. А если кнопка станет доступна только через шесть секунд, sleep(5) всё равно не поможет.
Иногда нужно дождаться определённого состояния, но не выполнять над элементом действие. Например, можно дождаться исчезновения лоадера page.wait_for_selector(“.loader”, state=”hidden”) или page.wait_for_load_state(“networkidle”).
networkidle означает, что сетевой активности некоторое время практически нет. Такой подход может быть полезен в отдельных сценариях, но для тестов Playwright рекомендует по возможности ждать конкретного состояния или элемента, а не всей сети: современные приложения могут постоянно выполнять фоновые запросы.
У ожиданий есть таймаут. По умолчанию Playwright ждёт до 30 секунд, после чего, если условие так и не выполнилось, выбрасывает ошибку. Для проверок используется expect. Например, можно проверить, что после отправки формы появился текст:
from playwright.sync_api import expect
message = page.get_by_text("Заявка отправлена")
expect(message).to_be_visible()
Парсинг на Playwright: собираем каталог в CSV
Переходим к практике. Напишем Python-скрипт, который соберёт названия и цены книг из открытого демо-каталога книг. Заодно разберёмся с пагинацией и сохраним собранные данные в CSV.
Разбираем страницу и находим карточки
Сначала открываем каталог и находим карточки книг. На странице каждая книга находится внутри элемента article.product_pod, поэтому используем этот селектор и перебираем найденные карточки в цикле.
page.goto("https://books.toscrape.com/")
# Ждём появления карточек на странице
page.wait_for_selector("article.product_pod")
# Получаем все карточки книг
cards = page.locator("article.product_pod").all()
for card in cards:
    # Здесь позже получим данные из каждой карточки
    pass
Вытаскиваем поля и складываем в словарь
Теперь из каждой карточки достанем два значения: название книги находится внутри h3 a, а цена — в p.price_color. Для каждой книги создаём словарь и добавляем его в общий список.
books_data = []
for card in cards:
    title = card.locator("h3 a").inner_text()
    price = card.locator("p.price_color").inner_text()
    books_data.append({
        "title": title,
        "price": price
    })
Проходим пагинацию
Одной страницы недостаточно: в каталоге несколько страниц с книгами. После обработки текущей страницы ищем ссылку Next. Если она есть, переходим на следующую страницу и снова собираем карточки. Когда ссылки больше нет, выходим из цикла.
while True:
    # Обрабатываем текущую страницу
    page.wait_for_selector("article.product_pod")
    cards = page.locator("article.product_pod").all()
    for card in cards:
        title = card.locator("h3 a").inner_text()
        price = card.locator("p.price_color").inner_text()
        books_data.append({
            "title": title,
            "price": price
        })
    # Проверяем, есть ли следующая страница
    next_button = page.locator("li.next a")
    if next_button.count() > 0:
        next_button.click()
    else:
        break
Пишем результат в CSV или JSON
После завершения парсинга все книги находятся в списке books_data. Остается сохранить наш словарь в файл. Как работать с JSON мы разбирали отдельно, а здесь сохраним всё в стандартный CSV.
with open("books.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(
        f,
        fieldnames=["title", "price"]
    )
    writer.writeheader()
    writer.writerows(books_data)
Полный скрипт
Теперь объединим все части в один рабочий скрипт:
import csv
from playwright.sync_api import sync_playwright

def scrape_books():
    books_data = []

    with sync_playwright() as p:
        browser = p.chromium.launch()
        page = browser.new_page()
        page.goto("https://books.toscrape.com/")

        while True:
            # Ждем загрузки карточек
            page.wait_for_selector("article.product_pod")
            cards = page.locator("article.product_pod").all()

            for card in cards:
                title = card.locator("h3 a").inner_text()
                price = card.locator("p.price_color").inner_text()
                books_data.append({"title": title, "price": price})

            # Ищем кнопку 'next'
            next_button = page.locator("li.next a")
            if next_button.count() > 0:
                next_button.click()
            else:
                break

        browser.close()

    # Сохраняем в CSV
    with open("books.csv", "w", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=["title", "price"])
        writer.writeheader()
        writer.writerows(books_data)

scrape_books()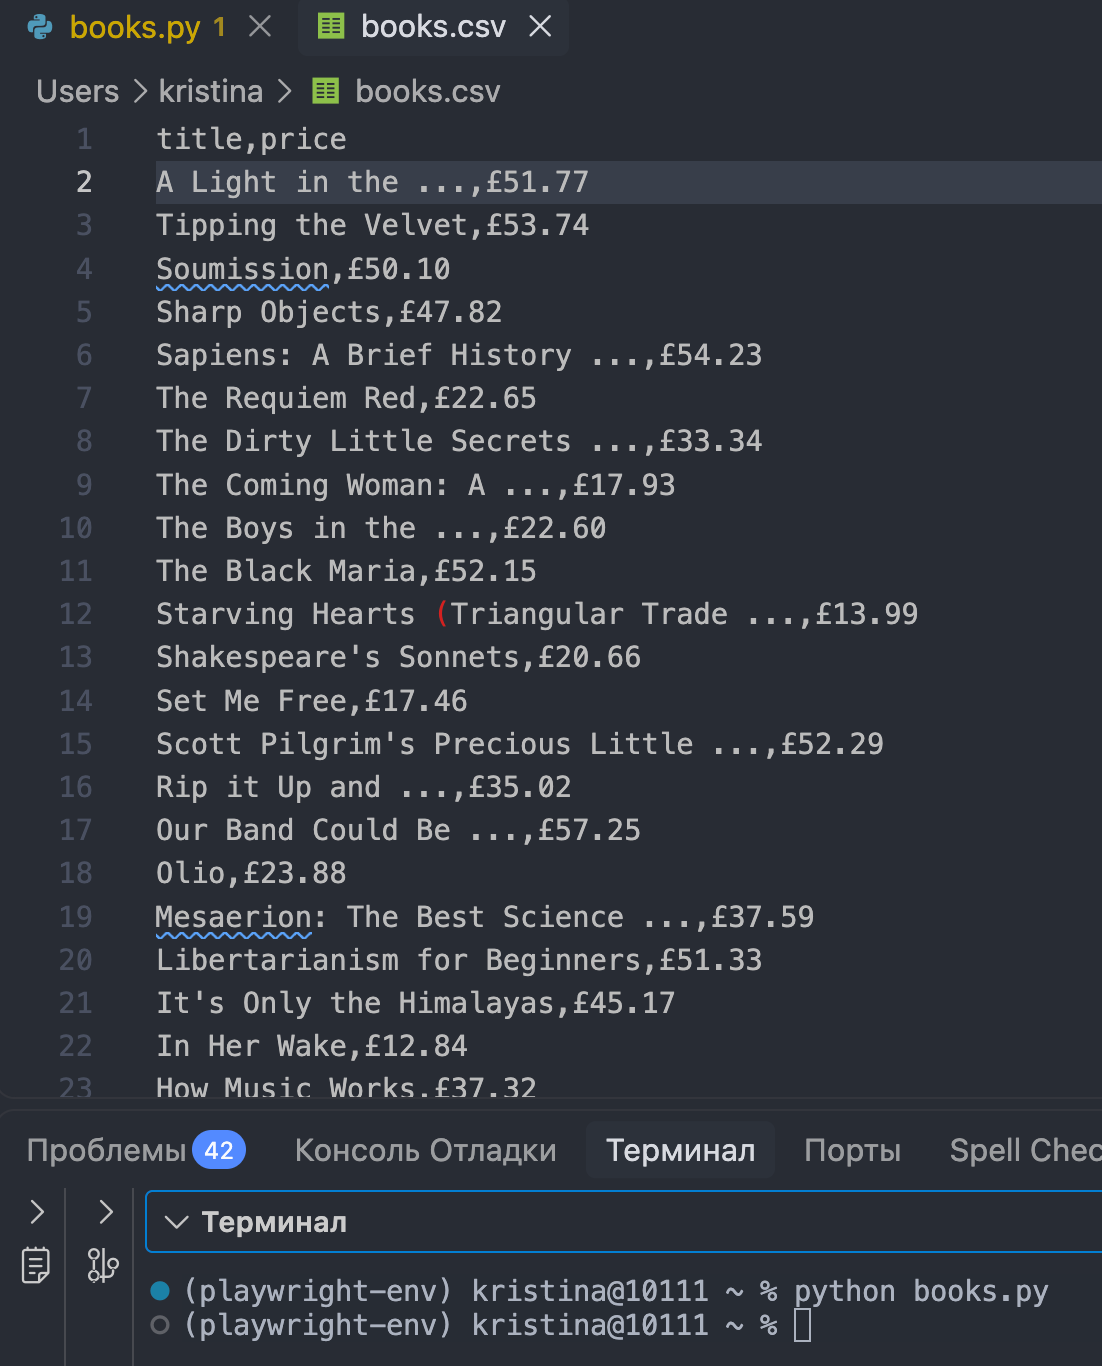
Клики, формы и авторизация
Playwright умеет эмулировать основные действия пользователя: кликать по элементам, заполнять формы, переключать чекбоксы и выбирать значения из выпадающих списков. Для заполнения поля используется метод fill(). Он сразу устанавливает нужное значение, тогда как type() вводит текст посимвольно.
page.get_by_label("Имя").fill("Ellie Williams")
page.get_by_label("Email").fill("user@example.com")
page.get_by_label("Согласен с условиями").check()
page.get_by_label("Страна").select_option("nl")
Для чекбоксов используются check() и uncheck(), а для <select> — select_option().
С авторизацией ситуация сложнее. Если парсеру нужен доступ к закрытой части сайта, вводить логин и пароль при каждом запуске неудобно. Кроме того, авторизацию могут прервать капча или двухфакторная аутентификация.
В таких случаях Playwright позволяет сохранить состояние авторизованной сессии через storage_state. Один раз выполняем вход, сохраняем куки и данные хранилища в файл, а при следующем запуске создаём контекст с этим состоянием:
# Используем ранее сохранённое состояние авторизации
context = browser.new_context(
    storage_state="auth.json"
)
После этого новая страница в контексте получит сохранённую сессию и сможет работать с сайтом так, будто пользователь уже вошёл в аккаунт.
Полезный блок со скидкой
По промокоду: KOD (можно просто нажать) — вы получите скидку на все курсы Практикума.
Если в полном скрипте вы узнали не все конструкции, а with, словари и цикл while пока читаются со словарём, загляните на курс Python-разработчик. Если интереснее, что делать с books.csv дальше, на курсе Аналитик данных учат собирать таблицы в выводы.
Бесплатные вводные курсы в Практикуме тоже есть — по всем направлениям, от Python до аналитики.
Динамический контент: прокрутка, ленивая загрузка и перехват запросов
Не весь контент есть в HTML сразу. Например, товары могут подгружаться только после прокрутки страницы. В таком случае нужно прокручивать страницу вниз и проверять, появились ли новые элементы.
Простейший вариант — прокручивать страницу на фиксированное расстояние и сравнивать высоту документа. Когда она перестаёт меняться, новые данные больше не подгружаются:
previous_height = 0
while True:
    current_height = page.evaluate("document.body.scrollHeight")
    if current_height == previous_height:
        break
    previous_height = current_height
    page.evaluate("window.scrollBy(0, 1000)")
Но есть трюк мощнее. Зачем парсить визуальную верстку, если можно перехватить внутренние сетевые запросы сайта и забрать чистый JSON? Playwright позволяет отслеживать ответы страницы и реагировать на нужные запросы.
Например, можно вывести данные из ответа API:
# Перехват чистого JSON без парсинга HTML
def handle_response(response):
    if "api/v1/products" in response.url and response.status == 200:
        print(response.json())
page.on("response", handle_response)
Для этого сначала можно открыть вкладку Network в инструментах разработчика браузера, найти запрос, который возвращает данные о товарах, и использовать его URL как условие для обработчика.
Через page.route() можно не только отслеживать запросы, но и управлять ими. Например, заблокировать загрузку изображений или шрифтов, если они не нужны парсеру. Это уменьшает объём трафика и может ускорить выполнение скрипта. О том, как устроены пакеты данных, мы писали в материале про HTTP-запросы на Python.
Codegen и Trace Viewer: пишем и чиним скрипты быстрее
В комплекте с библиотекой идут утилиты, кардинально упрощающие отладку Playwright.
playwright codegen умеет записывать действия в браузере и превращать их в код. Например, запустите в консоли playwright codegen thecode.media — и откроется браузер. Дальше можно кликать по ссылкам, заполнять поля и переходить между страницами, а Codegen будет генерировать соответствующие команды Playwright на Python.
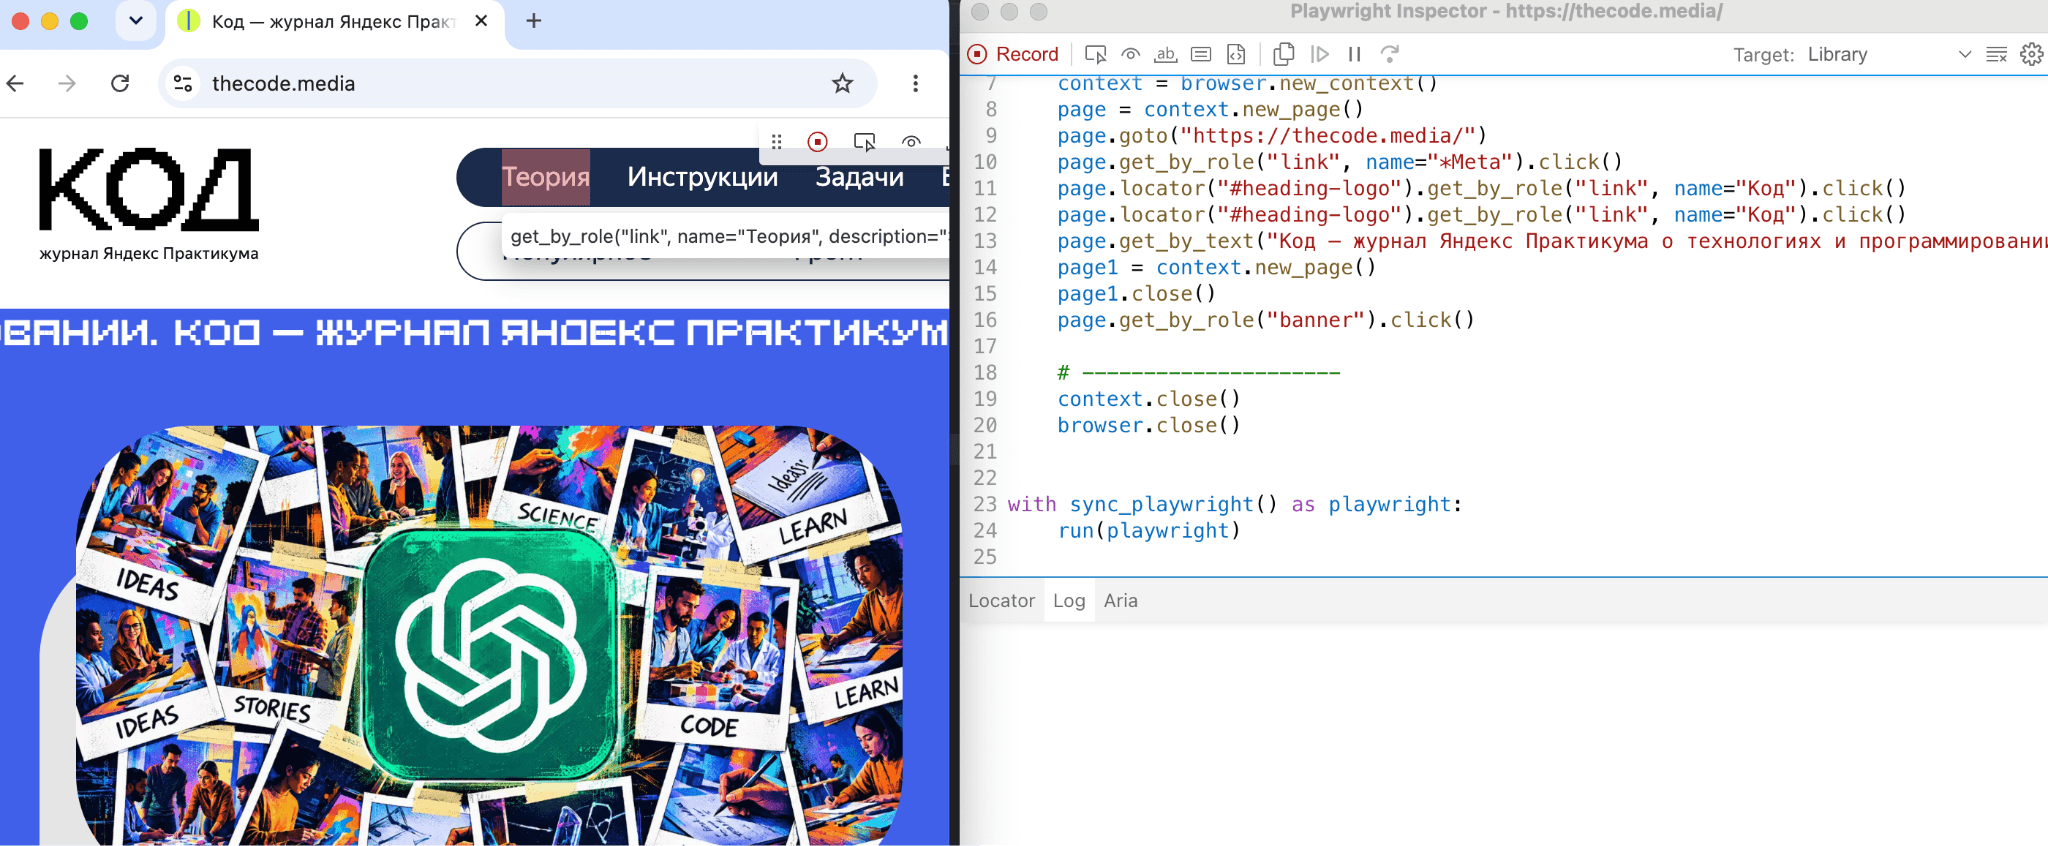
Получившийся код редко стоит сразу отправлять в продакшен: локаторы могут потребовать доработки, а лишние действия — удаления. Но как черновик для нового сценария Codegen очень удобен: не приходится с нуля вспоминать синтаксис API.
Для разбора ошибок пригодится Trace Viewer. Если скрипт упал, сохранённый trace-файл позволяет буквально пройти его выполнение по шагам: посмотреть состояние страницы, DOM-снапшоты, сетевые запросы, логи и время выполнения отдельных действий. Начиная с версии 1.62, MCP-сервер и CLI-утилиты поставляются вместе с базовой библиотекой, поэтому работать с инструментами Playwright стало удобнее. Для интерактивной отладки также можно запустить браузер в режиме инспектора с помощью переменной окружения PWDEBUG=1.
Что делать, когда сайт не отдаёт данные
Парсинг — это война брони и снаряда. Если сайт использует коммерческие антибот-системы (Cloudflare, DataDome), обычный браузер быстро заблокируют. Playwright сам по себе такие системы не обходит, а stealth-плагины могут ломаться после обновлений браузера.
Вы можете снизить вероятность блокировки, используя базовые методы:
- Подключайте Playwright прокси через параметр
proxy={“server”: “http://myproxy:8080”}при создании контекста. - Делайте паузы между запросами и устанавливайте разумные лимиты на частоту парсинга.
- Переиспользуйте сессии и куки.
- Запускайте браузер в headed-режиме (с графическим интерфейсом), так как headless-режим обнаруживается защитой гораздо быстрее.
Если этих мер недостаточно, придётся разбираться с конкретной антибот-защитой и её ограничениями. В ряде случаев разработчики переходят на AI-инструменты для умного парсинга.
Что можно парсить, а что нельзя
Законность парсинга зависит от того, какие данные вы собираете, откуда и как используете. Перед запуском парсера стоит проверить несколько вещей.
Во-первых, посмотрите robots.txt и пользовательское соглашение сайта: там могут быть ограничения на автоматизированный сбор данных. Во-вторых, при сборе персональных данных нужно учитывать требования 152-ФЗ и наличие соответствующих правовых оснований. В-третьих, авторское право может защищать оригинальные статьи, изображения и другие материалы, даже если технически они доступны без авторизации. Наконец, парсер не должен создавать чрезмерную нагрузку на сервер: большое количество запросов за короткое время может нарушить работу сайта и привести к юридическим последствиям.
Частые ошибки Playwright: timeout, Executable doesn’t exist, утечки памяти
В начале работы с Playwright можно столкнуться с несколькими типичными проблемами.
- Executable doesn’t exist. Вы забыли выполнить команду
playwright installдля скачивания бинарников браузеров после установки пакета. - Утечка оперативной памяти. Если вы не вызываете
browser.close()в конце скрипта или не используете менеджер контекстаwith, зомби-процессы Chromium быстро съедят всю память сервера. - playwright timeout error на существующем элементе. Вы пытаетесь кликнуть по кнопке, но получаете таймаут. Скорее всего, элемент находится внутри тега iframe, и искать его нужно через конструкцию
page.frame_locator(). - Скрипт падает на медленном интернете. Вы использовали
time.sleep(), и страница не успела загрузиться. Замените фиксированные паузы на встроенные автоожидания. - Парсинг тормозит. Сбор десяти тысяч страниц в цикле в одном потоке — неэффективно. Для ускорения необходимо переписать код на библиотеку asyncio и использовать асинхронный API (пакет
playwright.async_api). Подробнее об обработке ошибок можно прочесть в статье «Исключения в Python».
Частые вопросы про Playwright
Playwright бесплатный?
Да, это полностью бесплатный инструмент с открытым исходным кодом, который разрабатывается инженерами Microsoft и распространяется по лицензии Apache 2.0. Никаких скрытых платежей или коммерческих версий у самой библиотеки нет.
Чем Playwright лучше requests и BeautifulSoup?
requests получает только исходный HTML, а Playwright исполняет JavaScript и видит данные, которые подгружаются после загрузки страницы.
Нужно ли знать JavaScript, чтобы парсить на Python?
Нет, API на Python позволяет выполнять все необходимые действия без написания JS-кода. Знание JavaScript понадобится только в том случае, если вы захотите выполнить сложные манипуляции с DOM-деревом напрямую в браузере через метод page.evaluate().
Playwright быстрее Selenium?
Архитектура позволяет ему запускаться и выполнять клики быстрее, так как он общается с браузерами напрямую по протоколу Chrome DevTools (CDP), а не через сторонние драйверы. Кроме того, встроенная поддержка асинхронности позволяет выполнять десятки запросов параллельно.
Можно ли запускать его на сервере без графики?
По умолчанию браузеры стартуют в режиме headless (без отрисовки интерфейса). Это позволяет запускать скрипты на любых виртуальных серверах (Ubuntu, CentOS), в контейнерах Docker и CI/CD пайплайнах без необходимости устанавливать графическую оболочку X11.
Подойдёт ли Playwright для тестов, а не только для парсинга?
Изначально инструмент создавался именно для автоматизации тестирования интерфейсов. В связке с пакетом pytest-playwright он стал стандартом де-факто для написания быстрых, параллельных и надежных end-to-end тестов для современных веб-приложений.
Заключение
Теперь вы умеете запускать браузер из кода, находить элементы с помощью локаторов, работать с сетевыми запросами и сохранять собранные данные в файл. Playwright берёт на себя ожидание загрузки элементов и работу с JavaScript, поэтому не приходится вручную расставлять sleep() и придумывать обходы для динамических страниц. Дальше можно перейти к автоматизированным тестам, запускать парсер в Docker-контейнере или настроить его выполнение по расписанию. Какую бы задачу вы ни решали, Playwright остается удобным и сбалансированным инструментом для работы с вебом в 2026 году.
Советуем дополнительно почитать
Создание парсера для получения нужной информации с сайта — собираем тексты со всех страниц Кода на urllib и BeautifulSoup. Полезно для сравнения: где хватает простого HTTP, а где нужен Playwright.
AI-агент для парсинга вакансий: от идеи до рабочего бота — агент на Python ищет вакансии через открытое API «Работы России» и присылает их в Telegram. Показывает, когда вместо парсинга лучше взять API.
n8n автоматизация без кода: парсер Telegram за 10 минут — собираем RSS-парсер с фильтром и отправкой в Telegram из визуальных блоков. Альтернатива для задач, где браузер не нужен.
Пирамида тестирования: как сэкономить на багах — соотношение модульных, интеграционных и E2E-тестов и антипаттерн «рожок мороженого». Объясняет, почему тестов на Playwright в проекте должно быть немного.
Как настроить CI/CD в GitHub Actions с нуля — от минимального конфига до секретов и кэша (сентябрь 2026). Следующий шаг из заключения: запускать тесты и парсер автоматически.
Бонус для читателей
В Практикуме есть курсы по Python, аналитике, нейросетям. Бесплатные можно начать в любой момент, карту привязывать не нужно. Для платных есть промокод KOD — он даст скидку при покупке. На курсе «Мидл Python-разработчик» разбирают именно такую специфику: не синтаксис с нуля, а то, как писать продакшен-код.