Как стать AI-инженером, если вы уже несколько лет пишете бэкенд, проектируете API, работаете с очередями и знаете, как живут внешние зависимости? В прикладном ИИ старт знакомый: вы подключаете языковую модель через API и строите вокруг неё сервис. Но у модели есть особенность: на один и тот же запрос она может дать разные ответы, а качество результата приходится оценивать отдельно от доступности самого сервиса.
В этом роадмапе разберём переход от первого сервиса поверх LLM до продакшен-системы: сначала научимся получать управляемый ответ, затем подключим свои данные через RAG, добавим инструменты и агентный цикл, построим оценку качества и завершим всё трассировкой, бюджетом и защитой.
О том, какой инженерный багаж уже переносится из бэкенда и где находится следующая точка роста, можно почитать в материале о пути бэкенд-разработчика в ИИ.
ВАМ ПРИШЛО ПРИГЛАШЕНИЕ 💌
Приходите к нам в соцсети поделиться своим мнением и почитать, что пишут другие. А ещё там выходит дополнительный контент, которого нет на сайте — шпаргалки, опросы и разная дурка. В общем, вот тележка, вот ВК — велком!
Кто такой ИИ-инженер
Функционал ИИ-инженера сегодня покрывает сразу несколько задач. В одной компании от такого специалиста ожидают, что он собирает RAG и агентов из готовых моделей. В другой под этим же названием ищут ML-инженера, который обучает модели. На собеседовании эта разница внезапно становится ощутимой: меняются задачи, стек и требования к опыту.
| Роль | Что делает | Что нужно знать | Откуда приходят |
| Дата-сайентист | Исследует данные, проверяет гипотезы | Статистика, эксперименты | Аналитика, наука |
| ML-инженер | Обучает и дообучает модели | Математика, фреймворки обучения | Дата-сайенс, бэкенд |
| ИИ-инженер, LLM-разработчик | Встраивает готовые модели в продукт | API моделей, RAG, агенты, оценка качества | Бэкенд |
| MLOps-инженер | Держит инфраструктуру и выкатку | Kubernetes, пайплайны, мониторинг | DevOps |
Прикладной ИИ-инженер (он же — LLM-разработчик) берёт готовую модель и строит вокруг неё систему: контекст, инструменты, валидацию, наблюдаемость, ограничения и путь до продакшена. Обучение моделей остаётся отдельной специализацией. Для сравнения с ML-треком можно посмотреть наш материал «Роадмап ML-инженера».
В январе 2026 года LinkedIn включил AI Engineer в список самых быстрорастущих должностей в своём рейтинге Jobs on the Rise. Для прикладного инженера это полезный ориентир: роль становится самостоятельной специализацией, а не случайным названием внутри команды разработки.
Практический пример такого перехода описал Dozie Emodi, инженер в SaaS/web-разработке. В августе 2025 года он рассказал, как переносил опыт работы с API и сервисами в задачи прикладного AI и собрал собственный AI-поиск. Это хороший пример именно инженерного перехода: прежний опыт остаётся основой, а сверху добавляются работа с моделями, данными и оценкой результата.
Переход из бэкенда в ИИ
Переход из бэкенда в ИИ начните с проверки того, что уже умеете. В прикладных AI-системах значительная часть проблем выглядит знакомо: внешний сервис отвечает с задержкой, контракт иногда ломается, запрос надо повторить, результат нужно закэшировать, а расходы внезапно выросли после релиза. Примерный функционал может быть таким:
- Проектирование API и контрактов: AI-сервису тоже нужны понятные входы, выходы, версии и правила ошибок.
- Очереди и фоновые задачи: генерация, индексация документов и массовая оценка часто плохо помещаются в синхронный HTTP-запрос.
- Кэширование: одинаковые или почти одинаковые запросы можно не отправлять модели повторно, если бизнес-логика это допускает.
- Ретраи и таймауты: провайдер модели остаётся внешней зависимостью, а значит, его ошибки нужно обрабатывать как обычную распределённую систему.
- Наблюдаемость: latency, ошибки, токены, стоимость и конкретная версия промпта должны попадать в трассу запроса.
- Базы и хранилища: история диалога, документы, метаданные и эталонные наборы живут в обычной инфраструктуре.
- Контроль расходов: токены становятся ресурсом, который нужно бюджетировать так же, как CPU, память или внешние API.
По оценке FutureProofing.dev, в 2026 году на рынке фигурирует около 1,6 млн открытых AI-позиций против примерно 518 тыс. квалифицированных кандидатов, то есть около 3,2 вакансии на одного кандидата. Тот же обзор оценивает время закрытия senior AI Engineer примерно в 90–120 дней против около 25 дней для обычной software-роли. Это агрегированные оценки рынка, а не государственная статистика, поэтому их разумно воспринимать как индикатор дефицита, а не как точный счётчик.
Чего в бэкенд-опыте может не хватить
Главный сдвиг в мышлении AI-инженера связан с качеством. В классическом бэкенде тест обычно показывает: функция вернула 200 или нет, объект совпал или нет. В LLM-системе ответ может быть формально корректным и при этом бесполезным, неполным или убедительно неверным. К привычным метрикам сервиса добавляется отдельная проверка качества ответа модели: корректности, полноты и соответствия источнику.
- Нет единственного правильного ответа. Один и тот же вопрос может иметь несколько корректных формулировок, поэтому тест на точное равенство строк мало что даёт. Например, для внутреннего помощника вопрос «Какой лимит запросов у API?» может получить ответы «100 запросов в минуту» и «API принимает до 100 запросов в минуту» — смысл один, строки разные.
- Ответы модели меняются от запуска к запуску. Один и тот же промпт иногда выдаёт разные формулировки, а при смене модели они отличаются ещё сильнее. Regression поэтому удобнее считать по набору примеров и метрикам, а не по одному snapshot.
- Стоимость запроса становится проектным ограничением наравне с задержкой. Длинный контекст, несколько обращений к модели и агентный цикл напрямую увеличивают счёт. Нельзя оптимизировать latency, забыв про стоимость запроса.
- Отказ системы выглядит как правдоподобный, но неверный ответ. Галлюцинацию можно не заметить, потому что модель хорошо умеет звучать уверенно. Надёжность строится проверками, ссылками на источник, ограничением инструментов и оценкой качества.
- Границы возможностей модели выясняются замерами. Документация провайдера рассказывает, что модель поддерживает, но не сообщает, насколько хорошо ваша конкретная связка «промпт + данные + инструменты» решает вашу задачу.
Приведём пример задачи, где разница хорошо заметна. Допустим, сервис отвечает сотруднику, можно ли вернуть товар. Бэкендер привык проверить код ответа API каталога и корректность JSON. ИИ-инженер проверяет ещё четыре вещи: нашёлся ли нужный документ, попал ли он в контекст, не придумала ли модель лишнее и уложился ли запрос в допустимый бюджет. Такой сдвиг и отделяет работающую демонстрацию от системы, которую можно сопровождать. Вам нужно будет научиться смотреть на модель как на вероятностную зависимость и заранее встраивать измерение качества в архитектуру.
Стек AI-инженера
Стек лучше собирать снизу вверх. Сначала — программирование и прямой вызов модели. Затем появляются собственные данные, инструменты, оценка и эксплуатация. Так меньше шансов закопаться в зоопарке библиотек, прежде чем появится задача.
База
Для базы достаточно уверенного Python с асинхронным кодом, одного-двух SDK провайдеров моделей, Pydantic для схем, FastAPI для сервиса и понимания потоковой отдачи. Языковая модель здесь вызывается через обычный API, а токены и стоимость полезно считать с самого начала: так проще заранее избежать сюрпризов с платежами.
- Python 3.12 и asyncio — для сетевого I/O и параллельных запросов.
- OpenAI Responses API или аналогичный API другого провайдера — для вызова модели, streaming и tool calling.
- Pydantic 2.13.5 — для валидации структурированного ответа на границе сервиса.
- FastAPI 0.141.1 — для HTTP-обвязки и контрактов API.
Критерий освоения уровня: сервис выдерживает 100 тестовых запросов, не теряет обязательные поля ответа, а минимум 95% ответов проходят схему валидации без ручного парсинга строк.
Продакшен-уровень
Когда прямой вызов модели уже работает, добавляются RAG, оркестрация, протоколы подключения инструментов, трассировка и кэш. В этот момент архитектура начинает напоминать обычный распределённый сервис, только одна из его зависимостей отвечает вероятностно.
- RAG с гибридным поиском: семантический поиск + лексическое совпадение, затем переранжирование.
- Оркестрация многошаговых сценариев: очередь, workflow или граф там, где последовательность действий становится частью бизнес-логики.
- Протокол подключения инструментов к моделям: для новых интеграций в 2026 году стоит знать MCP; спецификация 2026-07-28 добавила статeless-ядро и усилила требования вокруг авторизации и маршрутизации.
- Трассировка и кэширование: один trace должен показывать промпт, вызов модели, инструмент, latency, токены и стоимость.
В 2026 году спецификация MCP закрепляет единый способ подключать инструменты и данные к агентным системам. Учить её стоит как сетевой контракт, а не как ещё один фреймворк.
Критерий освоения уровня: из одного trace можно восстановить весь путь запроса, а тестовый набор из 100 кейсов показывает повторяемое качество и стоимость в пределах заранее заданного бюджета.
Специализация
Специализацию имеет смысл выбирать после базового продакшен-цикла. Здесь появляются дообучение адаптерами, мультимодальные сценарии, локальный инференс и открытые модели. Если выбираете локальный инференс из-за ограничений по данным или стоимости, пригодится материал про локальные нейросети для ПК.
- Дообучение адаптерами — когда базовая модель уже умеет задачу, но нужен устойчивый стиль, формат или доменная специализация.
- Мультимодальные сценарии — когда в задаче участвуют изображения, аудио или видео вместе с текстом.
- Локальный инференс — когда важны стоимость, автономность или ограничения по данным и есть подходящее железо.
- Открытые модели — когда нужно управлять моделью и инфраструктурой глубже, чем позволяет API провайдера.
Критерий освоения уровня: один завершённый проект с 200+ эталонными примерами, сравнением с базовой версией и измерением latency, стоимости или потребления памяти — в зависимости от выбранного направления.
Что можно отложить
Для прикладной роли не нужно начинать с вывода формул обратного распространения, собственной архитектуры трансформера или соревновательного дата-сайенса. Эти темы полезны для отдельных карьерных треков. В прикладном AI сначала важнее научиться управлять готовой моделью и добиться того, чтобы система решала задачу.
- Вывод формул обратного распространения и глубокий разбор оптимизаторов — позже, когда появится задача вокруг обучения.
- Написание архитектуры модели с нуля — отдельная специализация исследовательского и ML-инженерного трека.
- Соревновательный дата-сайенс — хорошая школа для работы с данными, но слабая замена инженерной практике интеграции и эксплуатации.
Большая скидка — 16% на все курсы Практикума
Если вы читаете эту статью, тогда вы точно разбираетесь в технологиях. Стать лучше и зарабатывать больше можно после курсов Практикума — по программированию, анализу данных и искусственному интеллекту.
До 30 сентября на все курсы действует скидка 16%, она применится автоматически при оплате. Потом цены станут выше, поэтому не откладывайте!
Ещё нет своего сервиса поверх API модели и не хватает уверенности в асинхронном Python — берите «Мидл Python-разработчик»; уже собрали RAG и агента, но пока не считали качество ответов и бюджет — «ИИ-инженер»; вывели сервис в прод и хотите забрать себе эксплуатацию и мониторинг — «MLOps для разработки и мониторинга моделей».
Приложение поверх API модели
Если цель — стать AI-инженером, первым делом соберите простой сервис поверх API модели. Он принимает запрос пользователя, обращается к модели и возвращает данные в фиксированном формате. Здесь начинается интеграция LLM: держим prompt отдельно от бизнес-кода, используем структурированный вывод и валидируем результат до передачи клиенту или следующему сервису.
Для первого сервиса достаточно прямого API провайдера, Pydantic и обычной серверной обвязки. Общую карту инструментов можно посмотреть в AI-стеке для разработчика.
- Вынести системный промпт в отдельный файл или конфигурацию и добавить версию.
- Описать схему ответа и валидировать её через Pydantic.
- Подключить streaming для длинных ответов.
- Обработать таймауты, rate limit и временные ошибки провайдера.
- Добавить кэш для повторяющихся запросов там, где допустима повторная выдача.
- Логировать request_id, версию промпта, модель, latency, токены и стоимость.
# Версии: Python 3.12; pydantic 2.13.5; FastAPI 0.141.1; OpenAI Python SDK 2.x; Responses API
# Импортируем модуль для чтения переменных окружения.
import os
# Импортируем официальный клиент OpenAI.
from openai import OpenAI
# Импортируем базовый класс для схемы ответа.
from pydantic import BaseModel

# Описываем структуру ответа, которую приложение принимает от модели.
class SupportAnswer(BaseModel):
     # Ограничиваем тип поля с категорией обращения.
     category: str
     # Описываем текст, который вернём пользователю.
     answer: str
     # Сохраняем числовую оценку уверенности модели.
     confidence: float

# Создаём клиент и читаем API-ключ из переменной окружения.
client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])

# Отправляем запрос через Responses API и просим структурированный ответ.
response = client.responses.parse(
     # Берём название модели из переменной окружения.
     model=os.environ["OPENAI_MODEL"],
     # Передаём модели системную инструкцию и вопрос пользователя.
     input=[
         # Описываем системную роль для запроса.
         {
             # Указываем тип сообщения.
             "role": "system",
             # Фиксируем задачу модели.
             "content": "Классифицируй обращение и верни краткий ответ."
         },
         # Добавляем пользовательский запрос.
         {
             # Указываем тип сообщения.
             "role": "user",
             # Передаём пример вопроса клиента.
             "content": "Где мой заказ A-1002?"
         }
     ],
     # Передаём Pydantic-схему, которой должен соответствовать ответ.
     text_format=SupportAnswer,
)

# Получаем уже разобранный объект по заданной схеме.
answer = response.output_parsed
# Выводим словарь, который удобно проверить в тесте или логах.
print(answer.model_dump())
Здесь важна граница ответственности: модель формирует структуру, а приложение проверяет её до того, как отдаст данные клиенту или передаст их следующему компоненту. Документация OpenAI прямо рекомендует Structured Outputs на основе JSON Schema для случаев, когда ответ должен соответствовать заданной схеме.
Пока всё работает в одном запросе, этого достаточно. Как только ответ зависит от внутренних документов или внешних действий, пора переходить к следующему уровню.
Критерий готовности к переходу: сервис принимает 100 тестовых запросов подряд, минимум 95 из них дают валидный структурированный ответ, а для искусственно вызванного rate limit возвращается контролируемая ошибка без 5xx для клиента.
RAG и поиск по своим данным
RAG — retrieval-augmented generation — добавляет к запросу найденные фрагменты ваших документов. Это второй важный шаг, потому что модель сама по себе не знает свежие внутренние инструкции, базу знаний и правила конкретной компании.
Основы конвейера лучше один раз разобрать на отдельном примере: в материале о RAG-системах подробно показано, как связаны документы, поиск и генерация.
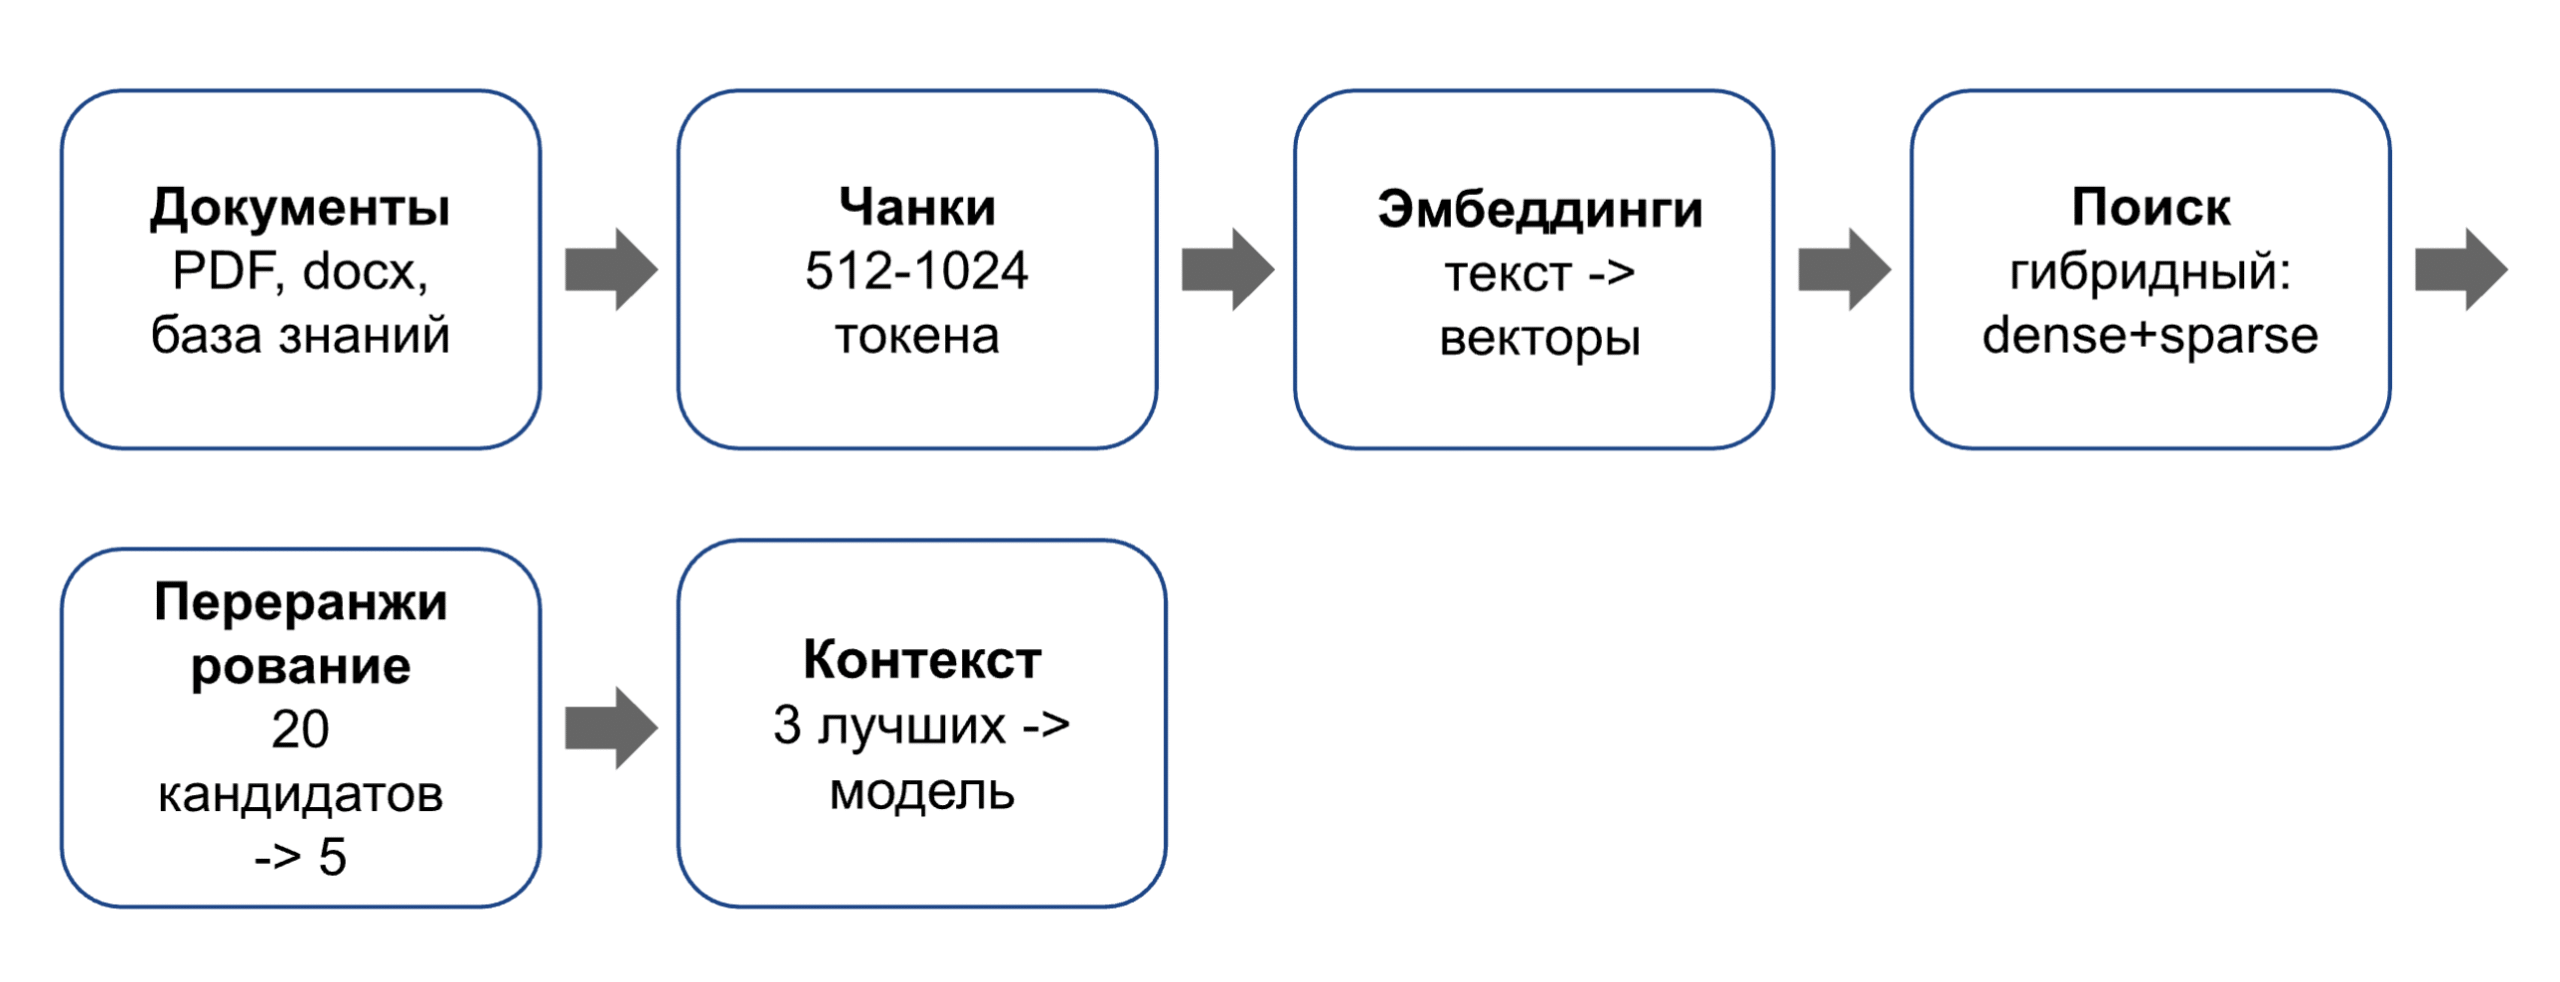
- Загрузить документы и сохранить источник каждого фрагмента.
- Разделить текст на чанки примерно по 512–1024 токена, сохраняя заголовки и другие структурные границы.
- Посчитать эмбеддинги и сохранить их в векторном хранилище.
- Искать гибридно: объединять семантическое сходство с обычным лексическим поиском.
- Переранжировать кандидатов отдельной моделью: практичный старт — 20 найденных фрагментов → 5 лучших.
- Передать в контекст модели 3 наиболее релевантных фрагмента вместе с вопросом и источниками.
У размеров чанков и количества найденных фрагментов нет универсального значения. Чанк в 512 токенов может быть удобен для FAQ и слишком мелким для договора. Контекстное окно модели тоже влияет на итоговый объём контекста, поэтому размер нужно проверять на своей задаче через recall нужного фрагмента.
При этом полезно знать базовую механику векторов и эмбеддингов. В отдельном материале про векторы, эмбеддинги и косинусное сходство она разобрана с нуля.
Для проекта достаточно начать с 50–200 документов, сделать разметку релевантных фрагментов и посчитать recall@20. После этого уже можно решать, нужен ли другой splitter, эмбеддинг, reranker или более глубокая индексация.
Критерий перехода к этосу уровню: на эталонном наборе минимум 90% вопросов получают релевантный фрагмент в первых 20 результатах, а средний запрос укладывается в установленный бюджет токенов.
AI-агенты и вызов инструментов
AI-агент появляется в тот момент, когда модель получает право выбирать следующий шаг. Она видит описания инструментов, решает, нужен ли вызов, формирует аргументы, получает результат и продолжает цикл. Для прикладного инженера это уже знакомая область: функции, права доступа, таймауты и состояние остаются обычным кодом.
Для первого практического примера можно взять пошаговое руководство по созданию AI-агента.
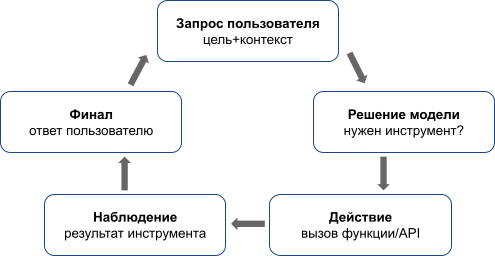
- Описание инструмента должно отвечать на два вопроса: что он делает и какие аргументы безопасно принимать.
- Число шагов задаётся заранее. Для большинства пользовательских сценариев нужен небольшой лимит, а не бесконечный цикл.
- Область действий ограничивается правами. Инструмент чтения и инструмент изменения данных должны иметь разные разрешения.
- Зацикливание обрабатывается отдельно: счётчик шагов, повторяемость вызовов, таймаут и аварийный финал.
- Внешние системы подключаются через единый контракт, например MCP, чтобы интеграции не превращались в коллекцию разрозненных адаптеров.
Стоимость здесь особенно легко потерять из виду. Один шаг цикла — это как минимум ещё один вызов модели, а иногда и дополнительный tool call с собственными затратами. Поэтому лимит шагов и бюджет задаются до запуска, а не после получения длинного счёта.
Когда несколько агентов делят работу, каждому лучше дать узкую роль и ограниченный набор инструментов. Агент-планировщик, который умеет всё, обычно быстро превращается в плохо тестируемый комбайн.
Критерий перехода на этот уровень: агент решает 90% сценариев из тестового набора в заданное число шагов, не превышает установленный лимит ни в одном тесте и корректно завершает работу после отказа инструмента.
Оценка качества LLM
Оценка качества LLM — главный дифференциатор прикладной роли. Без неё проект так и останется демо-версией: разработчик меняет промпт, смотрит десять чатов и решает, что стало лучше. Для продакшена нужен набор примеров, метрики и регрессионный прогон.
- Соберите эталонный набор из 50–1000 реальных или синтетических примеров с ожидаемым результатом. Для старта хватит 50–100 хороших кейсов, если они покрывают основные режимы и ошибки.
- Разделите метрики слоя извлечения и слоя ответа. Для RAG измеряйте recall@k, точность релевантности и долю ответов с найденным источником. Для генерации — корректность, полноту и соблюдение формата.
- Используйте модель-судью с качественно описанными критериями. LLM-as-judge удобен для масштаба, но его результаты тоже нужно сверять с ручной выборкой.
- Проверяйте ссылки и цитаты: каждая ссылка в ответе должна вести на реально найденный документ и подтверждать утверждение.
- Запускайте регрессионный прогон при каждом изменении промпта, модели, splitter, retriever или правил маршрутизации.
| Метрика | Что проверяет | Пример критерия |
| Recall@20 | Попал ли нужный фрагмент в 20 кандидатов | ≥ 0,90 |
| Precision@5 | Сколько верхних результатов действительно полезны | ≥ 0,80 |
| Answer correctness | Соответствует ли ответ эталону | ≥ 0,85 |
| Citation validity | Ссылается ли ответ на найденный источник | ≥ 0,95 |
| Schema pass rate | Проходит ли ответ формальную схему | ≥ 0,99 |
# Версии: формат примера эталонного набора
{"question": "Можно ли вернуть товар после 20 дней?",
 "expected_answer": "Нет, стандартный срок — 14 дней.",
 "expected_sources": ["returns.txt"],
 "tags": ["returns", "time-limit"]}
В исследовании DataRobot 2025 года 71% опрошенных AI-практиков сообщили, что не уверены в своих AI-решениях. Это не метрика качества конкретной системы, но показатель зрелости рынка: доверие к результату приходится подтверждать инженерными измерениями. В исследовании HiBob за 2026 год, основанном на опросе 1200 AI-руководителей, организации указали, что готовы платить минимум на 10% больше за специалистов с навыками оценки AI-выхода в 33% случаев. Для автоматизации и технической интеграции, а также AI safety, ethics и governance показатель составил 34%.
Соберите эталонный набор — таблицу из 50–1000 реальных или синтетических примеров, где для каждого запроса заранее указано, каким должен быть хороший результат. Для RAG это может быть правильный документ и релевантный фрагмент, для генерации — ожидаемый ответ или критерии его оценки. Для старта хватит 50–100 хороших кейсов, если они покрывают основные режимы и ошибки. Для бэкендера это знакомый приём: эталонный набор, тестовый прогон и пороги качества можно встроить в CI так же, как обычные интеграционные тесты.
Критерий перехода на этот уровень: есть минимум 100 эталонных примеров, прогон запускается автоматически, пороги заданы для retrieval и ответа, а изменение prompt или модели не может попасть в прод без сравнения с предыдущей версией.
LLMOps и вывод в продакшен
Пятая ступень превращает AI-функцию в сервис. Здесь важно держать в голове весь контур: запрос пользователя, бизнес-логика, модель, инструменты, кэш, логи, метрики, бюджет и аварийные сценарии. Модель может измениться у провайдера, сеть может упасть, а пользователь может прислать такой запрос, который заставит токены лететь со скоростью GPU.
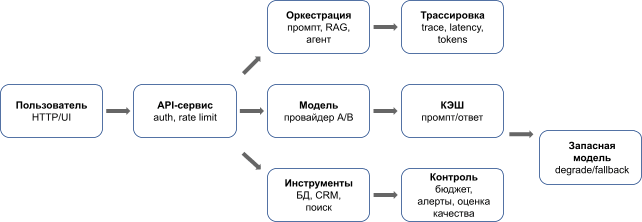
- Сквозная трассировка: связывайте пользовательский request_id с моделью, tool calls, latency, токенами и версией prompt.
- Кэш на двух уровнях: для повторяемых запросов и для промежуточных результатов там, где это безопасно.
- Бюджет и алерт: задайте дневной и месячный лимиты, а сигнализацию поставьте раньше финансового потолка.
- Деградация и fallback: при недоступности провайдера переключайтесь на запасную модель или понятный ограниченный сценарий.
- Rate limit и защита от дорогих запросов: ограничивайте длину входа, число вызовов и агентных шагов.
- Защита от prompt injection и утечки данных: разделяйте инструкции, данные и права инструмента; не отправляйте чувствительные поля внешнему сервису без необходимости.
- Версионирование промпта: храните промпт, схему и параметры модели как часть релиза, а не как текст в вики.
Стоимость запроса лучше считать на конкретном сценарии. Полезно учитывать входные и выходные токены, количество обращений к модели и процент кэш-хитов. Советуем освежить знания про токены и экономию в нейросетях.
Для трассировки и экспериментов подойдут OpenTelemetry-совместимые инструменты и специализированные платформы. Например, LangSmith умеет вести offline-evaluation по датасетам и online-evaluation на реальном трафике, связывая оценку с трассами.
Критерий готовности к выходу в прод: весь запрос имеет сквозной trace, бюджет на тестовом трафике укладывается в лимит, алерт срабатывает на искусственно завышенной нагрузке, а отказ основного провайдера приводит к fallback без потери пользовательского запроса.
Роадмап AI-инженера на шесть месяцев
Помесячный план
1. Первый месяц: Асинхронный Python, API моделей, structured output, streaming, rate limit, логирование и первый сервис. Результат: работающий API с валидируемым ответом и базовой обработкой ошибок.
2. Второй месяц: Собственные документы, chunking, embeddings, векторное хранилище и простой retrieval. Результат: RAG-прототип на собственных данных с источниками в ответе.
3. Третий месяц: Гибридный поиск, переранжирование и эталонный набор. Результат: измеренный recall@20 и сравнение хотя бы двух вариантов retrieval.
4. Четвёртый месяц: Агент с инструментами, ограничением шагов, правами и обработкой циклов. Результат: агент, который решает одну рабочую задачу и не выходит за лимит шагов.
5. Пятый месяц: Оценка качества и регрессии: 100+ эталонных примеров, LLM-as-judge, проверки цитат и CI-прогон. Результат: метрики и автоматическая защита от деградации.
6. Шестой месяц: Продакшен-контур: трассировка, кэш, бюджет, алерты, fallback, защита и релиз. Результат: доступный по ссылке сервис с измеренной стоимостью и качеством.
Такой путь позволяет стать ИИ-инженером через реальные задачи, а не через коллекцию учебных примеров.
Проекты для портфолио
Десять игрушечных ботов дают меньше доказательств навыка, чем два проекта, которые можно разобрать по инженерным решениям.
- Поиск по внутренней документации. Покажите корпус документов, архитектуру retrieval, recall@20, precision@5, пару примеров ошибок и стоимость запроса.
- Агент для рабочей задачи. Дайте ему ограниченный набор инструментов, лимит шагов, сценарий отказа и метрику успешного выполнения. Отдельно укажите среднюю и максимальную стоимость одной задачи.
В описании проекта скриншот чата играет второстепенную роль. Гораздо полезнее показать график метрик, trace одного неудачного запроса, версию промпта и число токенов. Это уже язык инженерного собеседования.
Зарплата AI-инженера и требования
Для денег лучше смотреть на опубликованные предложения, а не на универсальную «среднюю зарплату AI-инженера». Название роли широкое, а зарплата сильно меняется вместе с уровнем, географией и долей production-ответственности.
| Рынок | Ориентир | Что важно учесть |
| Россия | 250–350 тыс. ₽/мес. — встречающаяся вилка для Middle+/Senior AI Engineer; 350–400 тыс. ₽ — встречается в сильных middle-позициях | Это диапазоны конкретных вакансий 2026 года, а не средняя по всей стране. |
| США | примерно $145–310 тыс. базовой зарплаты как широкий 2026 диапазон | В Built In средняя база для AI Engineer — около $184,8 тыс., total compensation — около $211,2 тыс. |
Для России разумный ориентир лучше строить по нескольким источникам. В январе 2026 года «Ведомости» со ссылкой на hh.ru приводили медианную зарплату AI-инженера в размере 220 тысяч рублей. В срезе TalentScan от 23 мая 2026 года для Middle AI Engineer в Москве медиана составляла 260 130 ₽ на руки, а средний диапазон — 213 307–325 163 ₽. Для специалистов с опытом вывода AI-систем в продакшен ориентир 250–350 тысяч рублей выглядит реалистично, но конкретная вилка сильно зависит от грейда, ответственности и компании.
Для США Built In в сентябре 2026 года показывает среднюю базовую зарплату AI Engineer около $184 757 и общую компенсацию около $211 243; медианная база — $180 000. Широкий диапазон предложений на рынке другой источник, KORE1, оценивает примерно в $145–310 тыс. базовой зарплаты.
PwC в 2024 году оценивал премию за specialist AI skills примерно в 25%, а в отчёте 2025 года она выросла до 56%; в 2026-м PwC уже пишет о средней премии 62% для ролей с AI skills. Эти проценты относятся к AI-навыкам в целом, поэтому их нельзя механически прибавлять к зарплате конкретного AI Engineer.
На собеседовании обычно важнее всего четыре вещи: можете ли вы разобрать собственный проект по архитектуре, понимаете ли границы модели, умеете ли показать метрики качества и знаете ли стоимость типового запроса. Перечень библиотек сам по себе мало о чём говорит; цифры проекта показывают, как вы принимали инженерные решения.
Ошибки перехода
1. Копит курсы вместо проектов: Курсов становится много, доказательства навыка не появляются. Как сделать правильно: Соберите один сервис и доведите его до метрик, тестов и ссылки на работающий результат.
2. Показывает демо без замера качества: Непонятно, стало ли решение лучше после изменений. Как сделать правильно: Сделайте эталонный набор и храните результаты прогонов вместе с кодом.
3. Берётся дообучать модель там, где хватает поиска: Тратит время на обучение, хотя проблема лежит в данных и retrieval. Как сделать правильно: Сначала проверьте качество документов, chunking, recall и reranking.
4. Игнорирует стоимость запроса: После нагрузки счёт становится сюрпризом. Как сделать правильно: Задайте бюджет на сценарий и логируйте токены до публичного запуска.
5. Строит агента раньше простого конвейера: Многошаговый цикл усложняет поиск ошибок. Как сделать правильно: Сначала соберите прямой pipeline, затем добавьте решение модели о выборе следующего шага.
6. Выбирает фреймворк раньше задачи: Архитектура начинает подстраиваться под библиотеку. Как сделать правильно: Сначала опишите вход, выход, ограничения и метрики, потом выбирайте оркестрацию.
7. Пропускает защиту от инъекции в промпт (prompt injection): внешние данные могут подменить инструкции или заставить инструмент сделать лишнее. Как сделать правильно: Разделите инструкции и данные, ограничьте права инструментов и добавьте тесты атакующих входов.

Чек-лист как стать AI-инженером
Готовность к собеседованию проще всего проверять по артефактам. Пройдитесь по списку и откройте каждый пункт ссылкой, цифрой или рабочим сервисом.
- Собран рабочий сервис поверх модели и есть валидация структурированного ответа.
- Поднят RAG на собственных данных и сохранены источники найденных фрагментов.
- Качество извлечения измерено на эталонном наборе, минимум 100 примеров.
- Настроена сквозная трассировка запроса с моделью, инструментами и стоимостью.
- Посчитана стоимость типового запроса и задан бюджет.
- Есть агент с ограничением шагов и сценариями отказа.
- Промпты и схемы версионируются вместе с кодом.
- Проект выкачен и доступен по ссылке, которую можно открыть на собеседовании.
- Готов рассказ о проекте на пять минут с числами: качество, latency, стоимость и главный компромисс архитектуры.
Частые вопросы
Нужна ли математика прикладному ИИ-инженеру
Глубокая математика нужна для задач, связанных с обучением и оптимизацией моделей; для прикладного LLM-трека достаточно уверенно понимать embeddings, вероятностную природу ответа, базовые метрики и ограничения inference.
Обязательно ли уметь дообучать модели
Нет, дообучение становится обязательным только для ролей, где оно входит в задачу; в типовом прикладном треке сначала важнее API, RAG, агенты, оценка и продакшен.
Какой язык учить после Python
Отдельный язык обычно не нужен; лучше углубить Python, а второй язык добавлять под окружение компании или инфраструктурную задачу, где он действительно используется.
Что делать, если в компании нет ИИ-задач
Возьмите внутренний процесс с понятными данными и измеримым результатом: поиск по документации, классификацию обращений или агента с чтением внутренних систем.
Сколько времени занимает переход при работе на полную ставку
Шесть месяцев — реалистичный учебный горизонт для последовательного пет-проекта; срок зависит от бэкграунда, свободного времени и доступа к реальным AI-задачам.
Если вы — бэкендер и задумываетесь о том, как стать AI-инженером, то Ваш трек не такой заковыристый: половина инженерной работы уже знакома, потому что вы умеете строить сервис вокруг внешней зависимости, у которой бывают задержки, сбои и изменения поведения. Дальше добавляются навыки работы с вероятностными ответами, RAG, агентами и измерением качества. В этом дополнительно поможет наш материал про AI-навыки. Дерзайте!
Советуем дополнительно почитать
LangChain: что это такое и как построить на нём AI-агента — практический разбор фреймворка для сборки агентного цикла и RAG на Python: когда LangChain действительно экономит время, а когда усложняет задачу.
Микросервисы или монолит: когда что выбирать — пригодится на шестой ступени роадмапа, когда AI-сервис нужно вывести в продакшен: разбор того, что реально стоит каждая архитектура в деньгах и времени команды.
5 видов баз данных, которые подходят для разных задач — коротко о том, чем векторные и колоночные хранилища отличаются от привычной реляционной БД, если данные для RAG нужно где-то хранить помимо документов.
LLM для кода: как выбрать между ценой и качеством — бенчмарки и расчёт стоимости решённой задачи для разных моделей, полезно на этапе, где статья просит закладывать бюджет на токены заранее.
ИИкономика: токены, GPU и бигтех — кто реально контролирует ИИ — более широкий взгляд на то, почему токены и инфраструктура стали ресурсом, который приходится бюджетировать, как CPU или память.
Бонус для читателей
Если вам интересно погрузиться в мир IT и при этом немного сэкономить, держите наш промокод на курсы Практикума. Он даст вам скидку при оплате, поможет с льготной ипотекой или безлимитом на маркетплейсах. Ладно, окей, это просто скидка, без остального, но хорошая.