

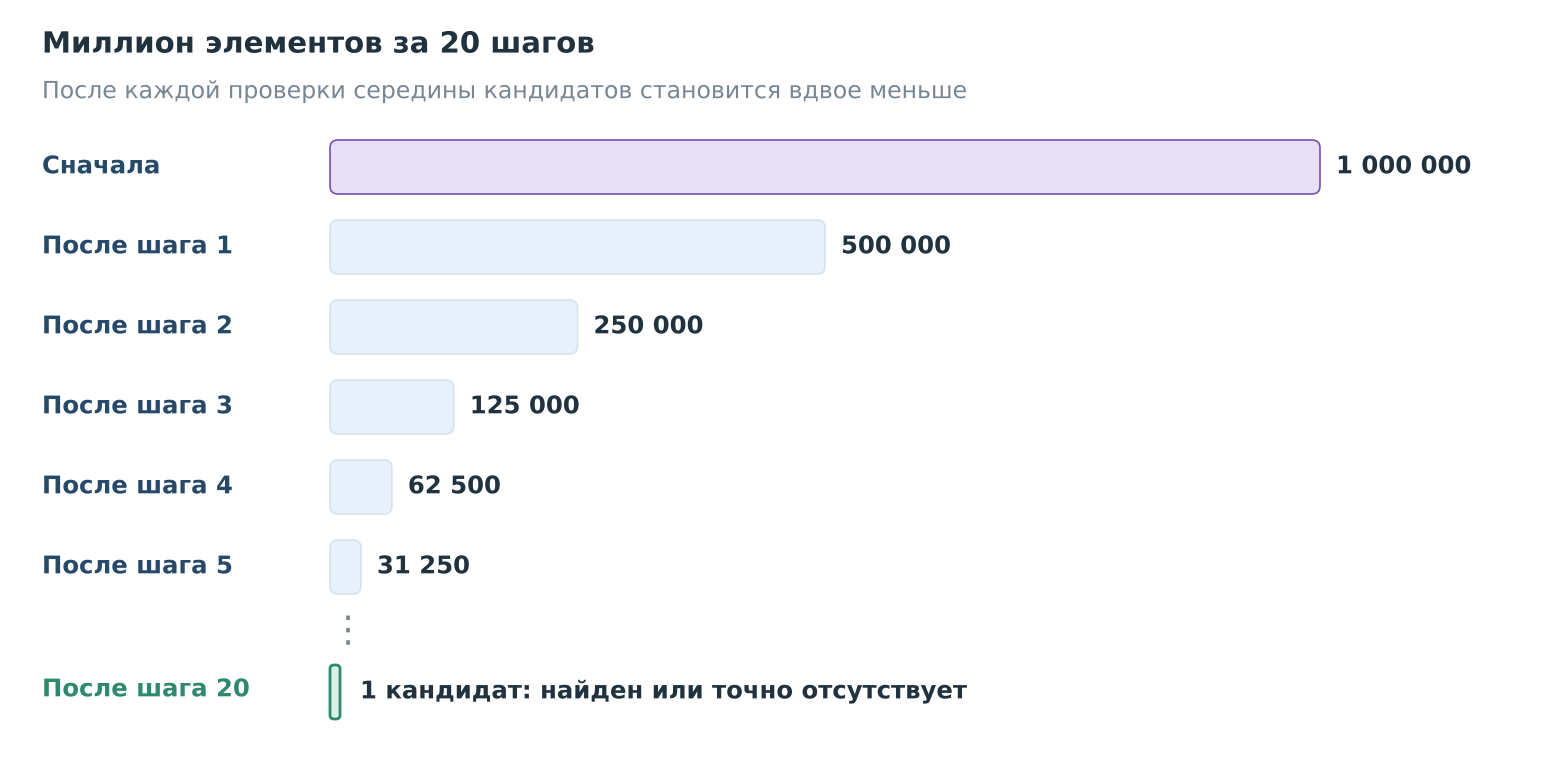
Бинарный поиск — это алгоритм, который находит элемент в отсортированном массиве, последовательно исключая примерно половину оставшихся кандидатов. На каждом шаге он сравнивает цель с серединой диапазона и сужает границы. Для массива из миллиона элементов в худшем случае понадобится не более 20 проверок середины.
Идея простая, а код коварный: стоит перепутать < и <=, и поиск зависнет или потеряет последний элемент. Даже в стандартной библиотеке Java ошибка в бинарном поиске прожила около девяти лет. Разберём, как писать его без ошибок, какой из трёх вариантов выбрать под задачу, и решим восемь задач с собеседований.
Коротко
- Бинарный поиск, он же двоичный, работает за O(log n), если доступ к элементу по индексу занимает O(1).
- Для обычного бинарного поиска данные должны быть отсортированы.
- В Python есть модуль
bisect. Он ищет позицию вставки, а наличие элемента проверяют отдельно. - Итеративной реализации достаточно O(1) дополнительной памяти.
- Чаще всего ошибаются в условии цикла, сдвиге границ и обработке повторов.
ВАМ ПРИШЛО ПРИГЛАШЕНИЕ 💌
Приходите к нам в соцсети поделиться своим мнением и почитать, что пишут другие. А ещё там выходит дополнительный контент, которого нет на сайте — шпаргалки, опросы и разная дурка. В общем, вот тележка, вот ВК — велком!
Как работает бинарный поиск
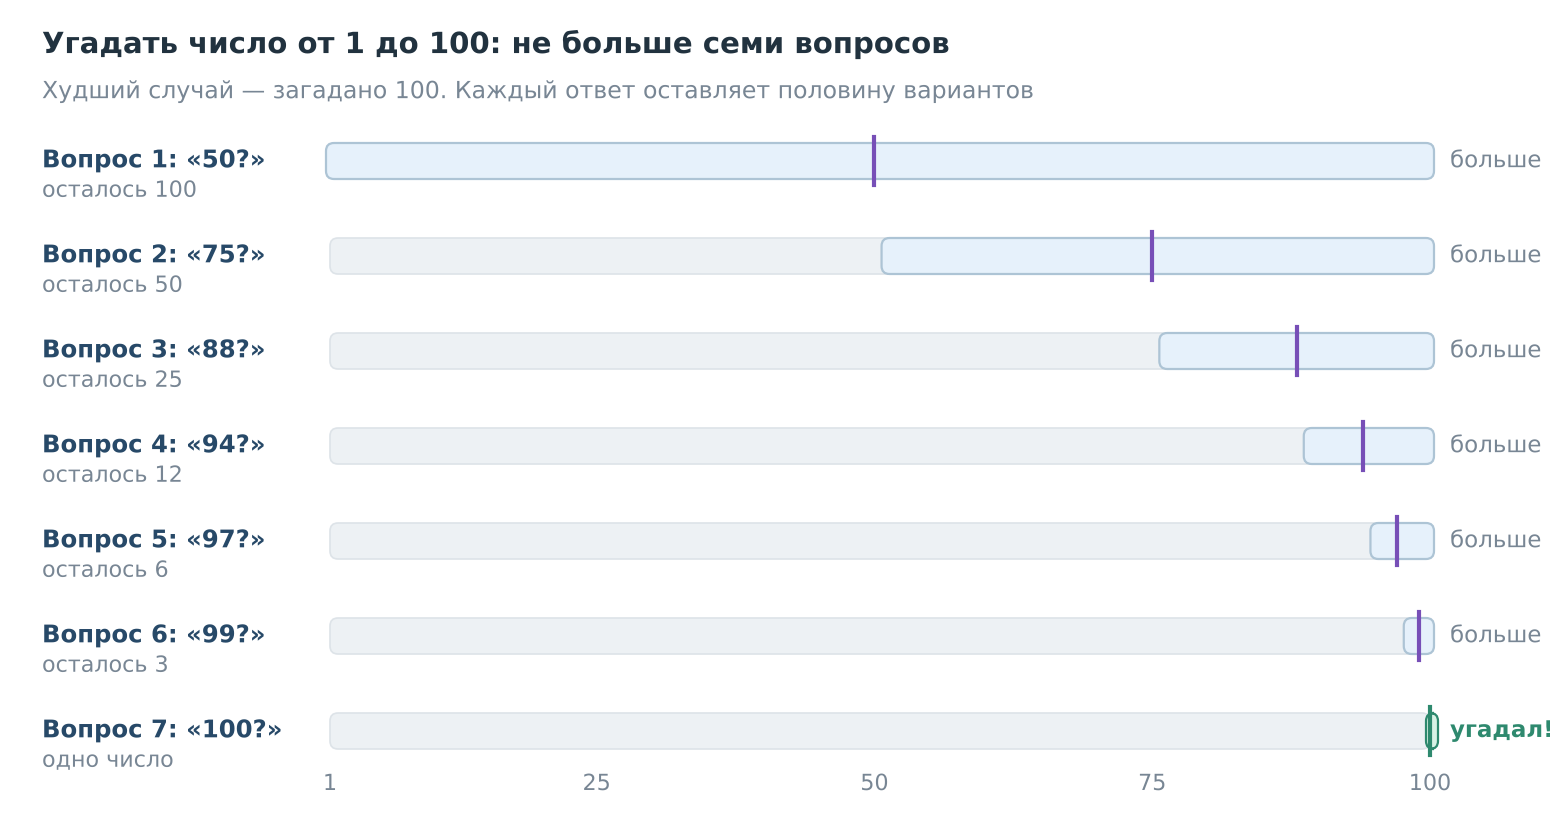
Вспомните игру «угадай число от 1 до 100», где ведущий отвечает только «больше» или «меньше». Можно перебирать подряд и потратить сто попыток. А можно начать с 50 и каждый раз называть середину оставшегося отрезка. Тогда каждый ответ отсекает половину вариантов, и хватит семи вопросов: 2⁷ = 128. Алгоритм бинарного поиска играет в ту же игру, только подсказки ему даёт сортировка.

Возьмём массив [2, 5, 8, 12, 16, 23, 38, 44, 57, 71, 90]. Границы lo = 0 и hi = 10 включены в поиск, середина mid = (lo + hi) // 2. Если значение в середине меньше цели, сдвигаем lo за mid, если больше, сдвигаем hi.

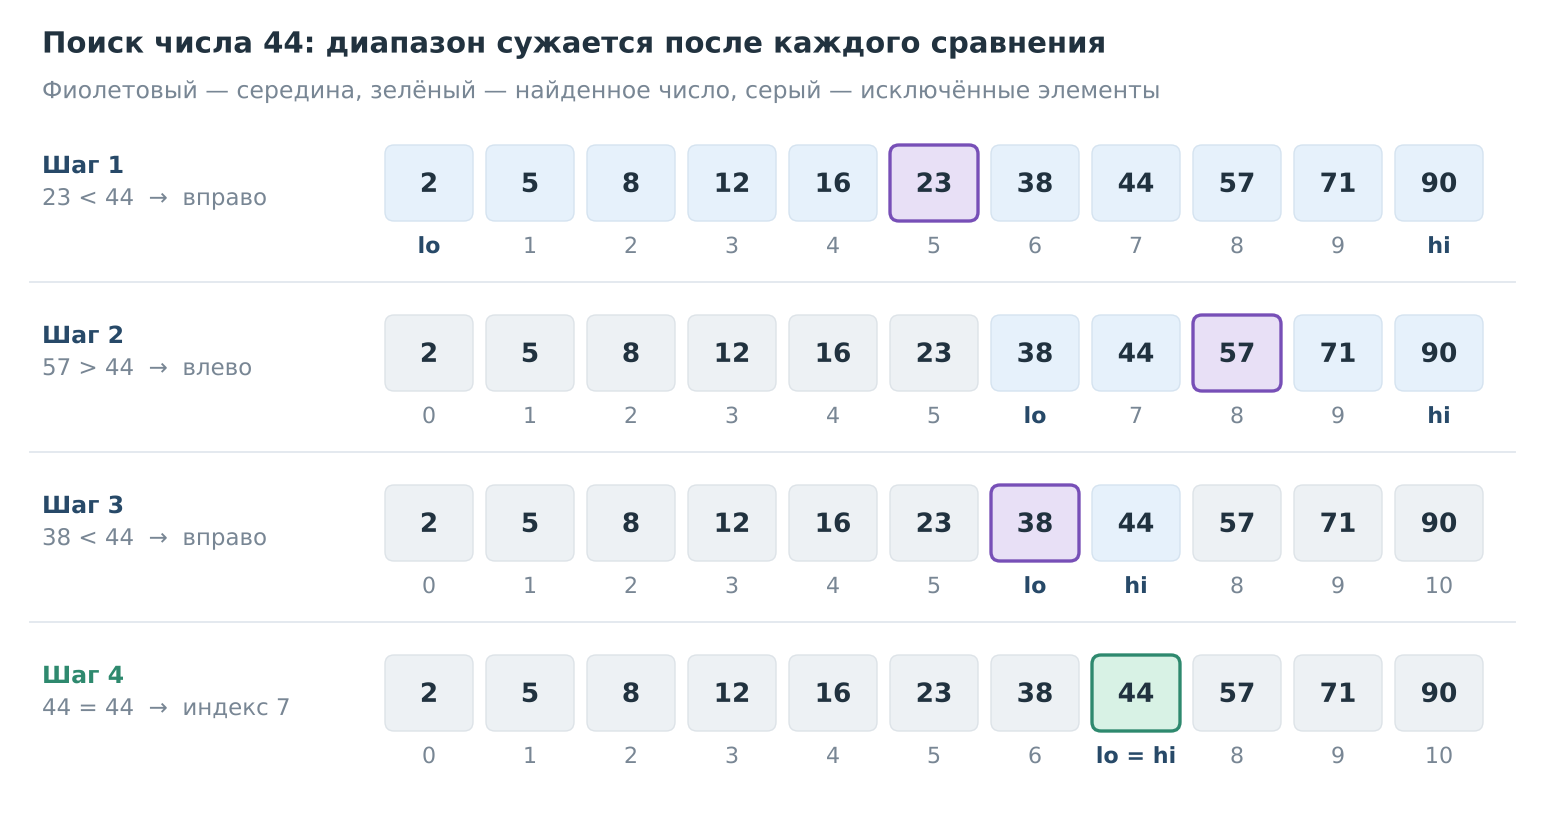
Ищем 44:
| Шаг | lo | hi | mid | Сравнение | Решение |
|---|---|---|---|---|---|
| 1 | 0 | 10 | 5 | 23 < 44 | lo = 6 |
| 2 | 6 | 10 | 8 | 57 > 44 | hi = 7 |
| 3 | 6 | 7 | 6 | 38 < 44 | lo = 7 |
| 4 | 7 | 7 | 7 | 44 = 44 | вернуть 7 |
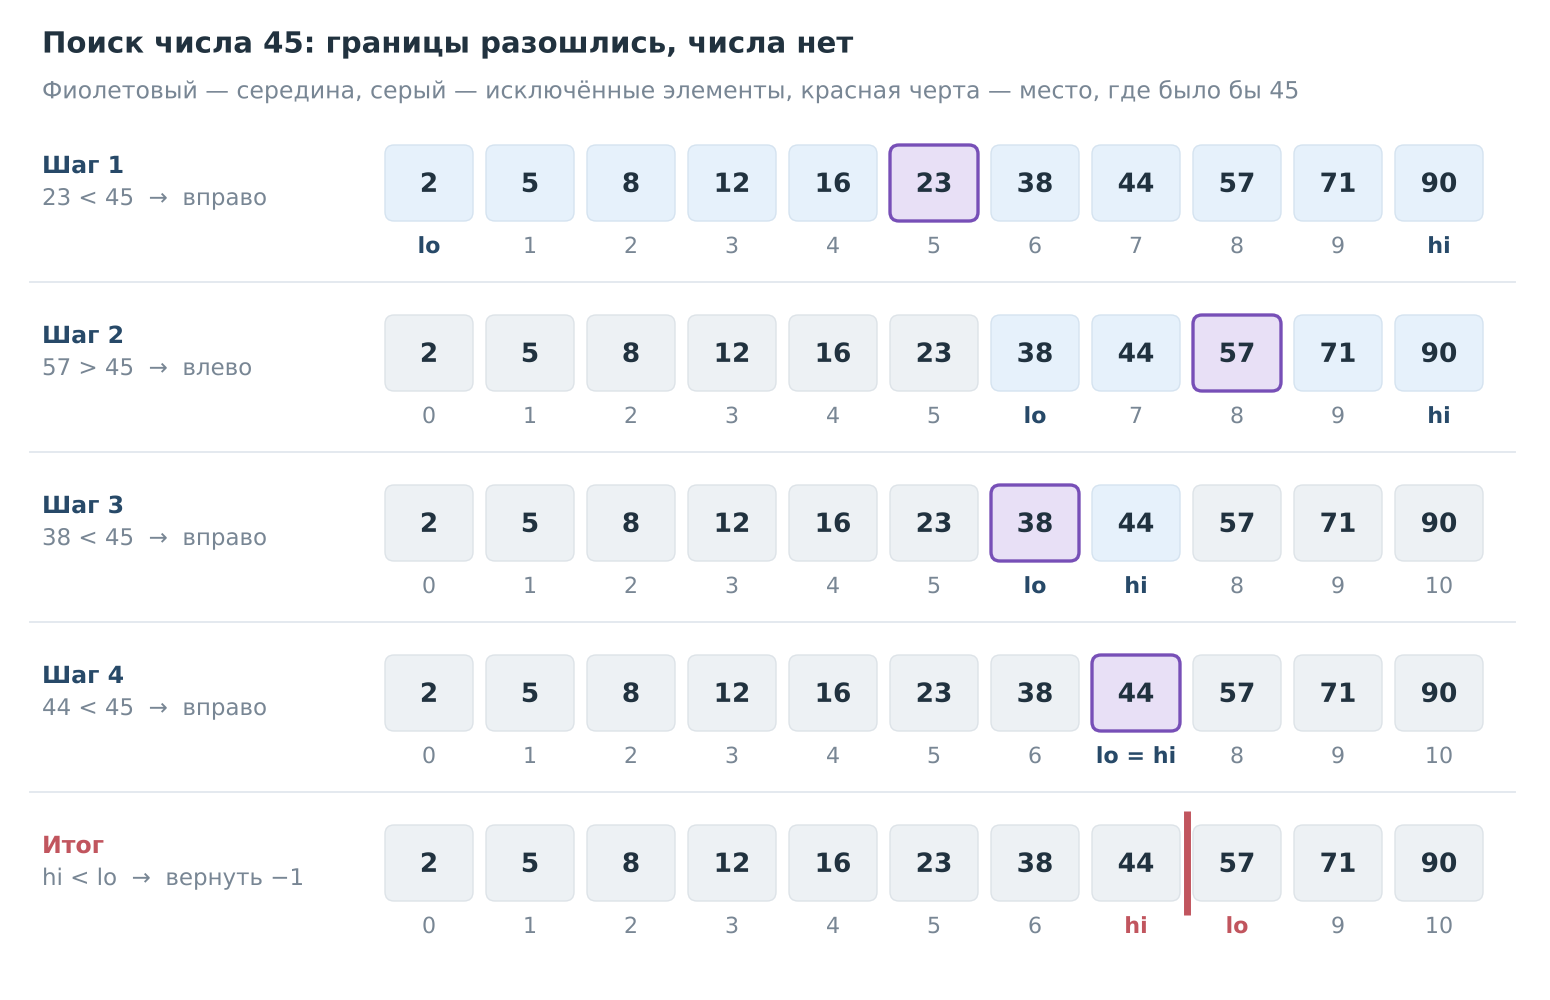
Теперь ищем 45, которого в массиве нет:
| Шаг | lo | hi | mid | Сравнение | Решение |
|---|---|---|---|---|---|
| 1 | 0 | 10 | 5 | 23 < 45 | lo = 6 |
| 2 | 6 | 10 | 8 | 57 > 45 | hi = 7 |
| 3 | 6 | 7 | 6 | 38 < 45 | lo = 7 |
| 4 | 7 | 7 | 7 | 44 < 45 | lo = 8, стоп |
Границы разошлись: lo = 8, hi = 7. Кандидатов нет, возвращаем −1.

Почему можно смело выбрасывать половину? Массив отсортирован, поэтому если середина меньше цели, всё левее неё тоже меньше. На этом держится инвариант, главное правило алгоритма: если цель есть в массиве, она лежит внутри [lo, hi]. Каждое сравнение сохраняет это правило и уменьшает число кандидатов, поэтому поиск не пропустит ответ и не зависнет.
Сложность бинарного поиска
Область поиска тает по схеме n → n/2 → n/4. Через k шагов остаётся примерно n/2ᵏ элементов, поэтому время составляет O(log n). На миллионе чисел бинарный поиск в худшем случае проверит середину 20 раз, а линейный переберёт миллион элементов. В таблице худшие случаи: n проверенных элементов у линейного поиска против ⌊log₂ n⌋ + 1 проверок середины у бинарного. Двадцати проверок хватает для любой цели, включая отсутствующие: 21-я понадобится, только когда элементов станет 2²⁰ = 1 048 576 или больше.
| Элементов n | Линейный поиск, проверок | Бинарный поиск, проверок середины |
|---|---|---|
| 10 | 10 | 4 |
| 1 000 | 1 000 | 10 |
| 1 000 000 | 1 000 000 | 20 |
| 1 000 000 000 | 1 000 000 000 | 30 |
Массив вырос в сто миллионов раз, а проверок прибавилось всего 26.

Итеративная версия расходует O(1) дополнительной памяти, рекурсивная O(log n) на стек вызовов. Оценки верны для отсортированного списка с доступом по индексу за O(1), время сортировки в них не входит.
Когда бинарный поиск не нужен
Если список не отсортирован и искать нужно один раз, пройдите по нему целиком: это O(n), а сортировка обойдётся в O(n log n). При большом числе запросов сортировка может окупиться, но точный порог зависит от данных.
Если порядок не важен, а проверять наличие ключа нужно часто, берите set или dict: там поиск в среднем O(1). На крошечном списке хватит обычного in.
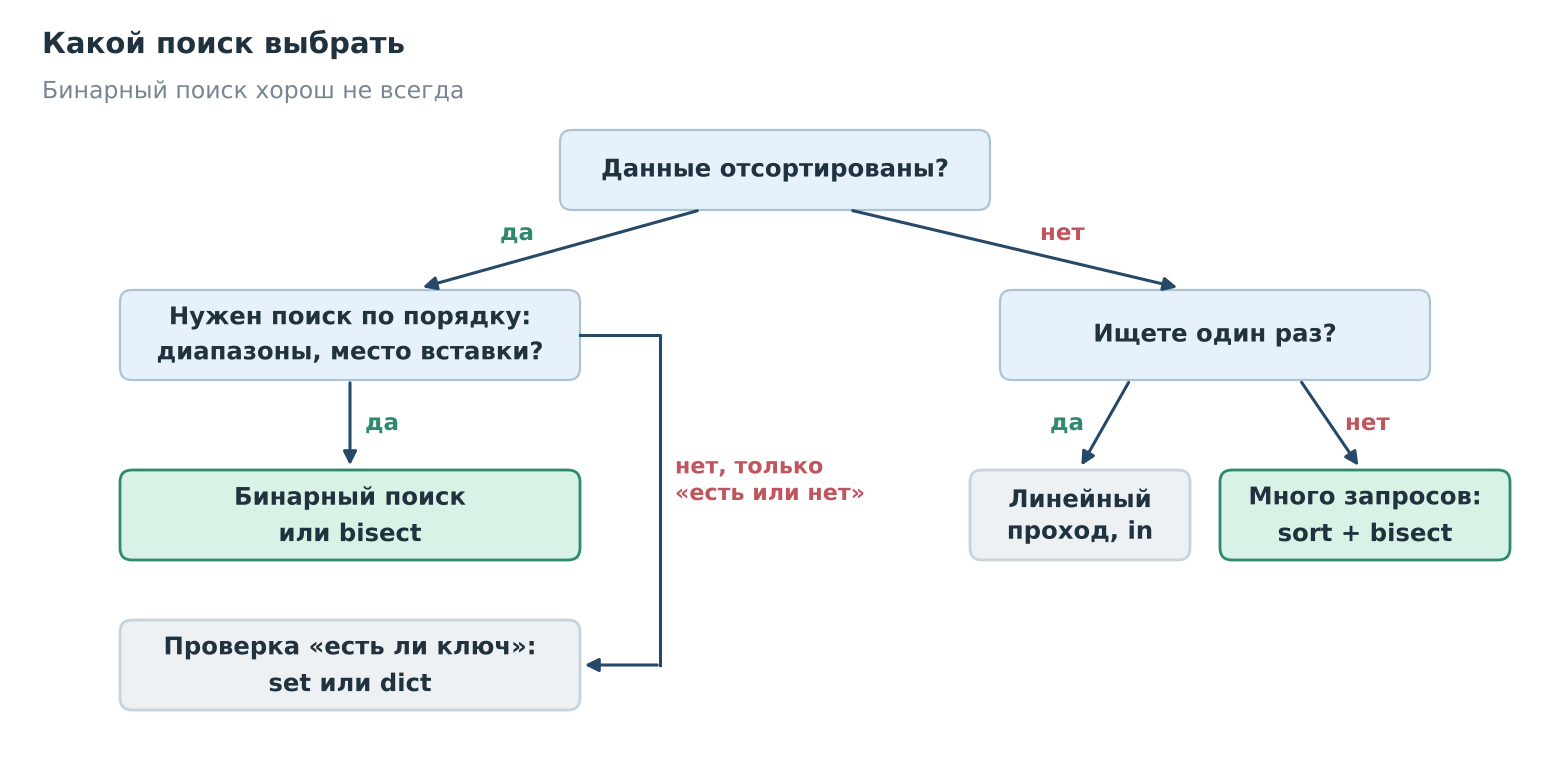
Зато в инструментах бинарный поиск встречается постоянно. git bisect находит коммит, после которого появилась ошибка, а модуль bisect ищет место в отсортированном списке. Сама вставка в середину списка при этом всё равно стоит O(n).


Бинарный поиск на Python
Итеративная реализация
Функция возвращает индекс цели или −1.
# индекс target в отсортированном списке a или -1
def binary_search(a: list[int], target: int) -> int:
    # обе границы входят в поиск
    lo, hi = 0, len(a) - 1
    # при lo > hi кандидатов нет
    while lo <= hi:
        # середина без переполнения в других языках
        mid = lo + (hi - lo) // 2
        if a[mid] == target:
            return mid
        # цель правее: отбрасываем mid и левую часть
        if a[mid] < target:
            lo = mid + 1
        # цель левее: отбрасываем mid и правую часть
        else:
            hi = mid - 1
    # кандидатов не осталось
    return -1


# выведет 7
print(binary_search([2, 5, 8, 12, 16, 23, 38, 44, 57, 71, 90], 44))
Условие lo <= hi гарантирует, что последний кандидат тоже будет проверен. Проверенный mid исключаем, поэтому границы сдвигаются на mid + 1 и mid – 1. Формула lo + (hi – lo) // 2 в Python необязательна, но пригодится в языках, где числа переполняются.
Корректный бинарный поиск держится на двух свойствах: ответ остаётся между lo и hi, а диапазон после каждого шага строго уменьшается. Первое отвечает за правильность, второе за то, что цикл закончится.
Рекурсивная реализация
Рекурсивная версия проверяет середину и вызывает себя для нужной половины.
def binary_search_recursive(a: list[int], target: int) -> int:
    # ищем target в a[lo..hi]
    def search(lo: int, hi: int) -> int:
        # диапазон пуст
        if lo > hi:
            return -1
        mid = lo + (hi - lo) // 2
        if a[mid] == target:
            return mid
        # mid проверен, поэтому в следующий вызов не входит
        if a[mid] < target:
            return search(mid + 1, hi)
        return search(lo, mid - 1)

    return search(0, len(a) - 1)


# выведет 3
print(binary_search_recursive([1, 4, 9, 16, 25], 16))
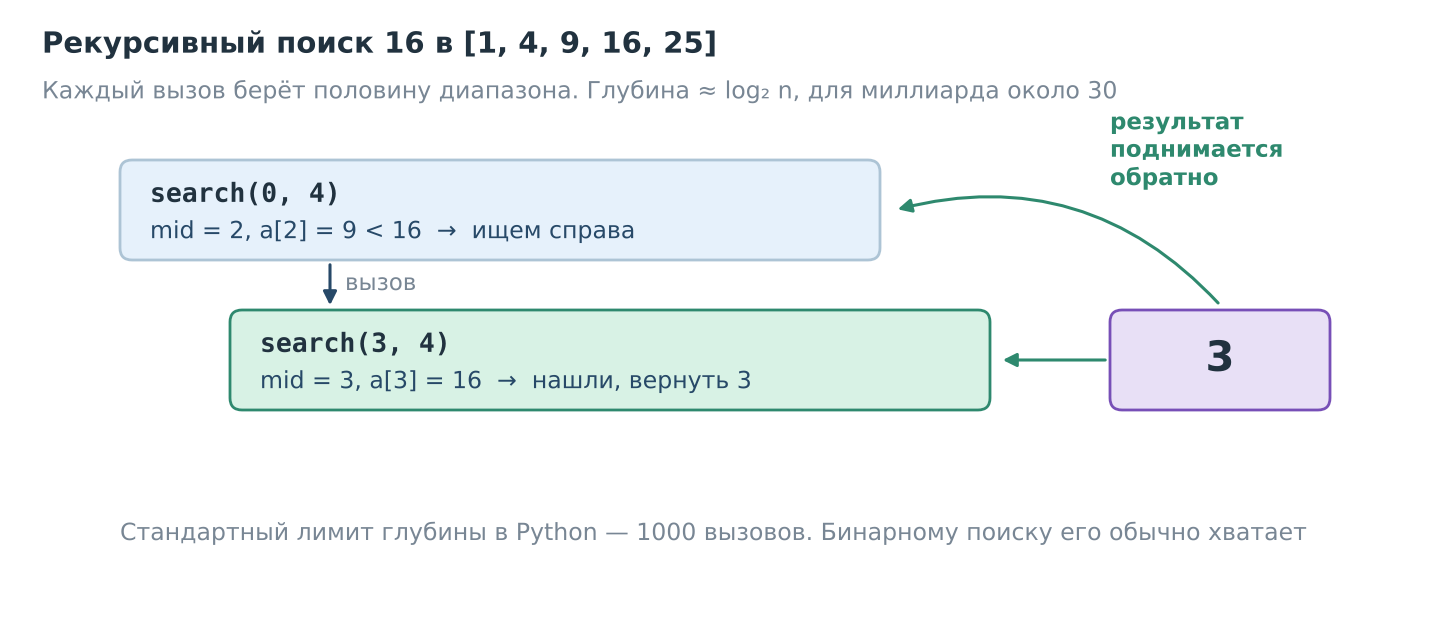
Глубина рекурсии здесь O(log n): даже для миллиарда элементов это около 30 вызовов. При стандартных настройках Python лимит рекурсии в 1000 вызовов такому поиску обычно не мешает, но он зависит от настроек интерпретатора и от того, насколько глубоко стек занят к моменту вызова. А если в границах ошибка, вместо зависания вы, скорее всего, увидите RecursionError. Цикл всё равно предпочитают: он проще, не требует вложенной функции и не тратит O(log n) памяти на стек.

Модуль bisect
В стандартной библиотеке бинарный поиск уже есть: модуль bisect. Он возвращает позицию, куда можно вставить значение без нарушения порядка.
from bisect import bisect_left, bisect_right, insort_left

a = [2, 5, 5, 5, 9]
# позиции перед пятёрками и после них, выведет 1 4
print(bisect_left(a, 5), bisect_right(a, 5))
# есть ли 5: позиция внутри списка и там именно 5
pos = bisect_left(a, 5)
# выведет True
print(pos < len(a) and a[pos] == 5)
# insort сдвигает хвост списка: вставка стоит O(n)
insort_left(a, 7)
# выведет [2, 5, 5, 5, 7, 9]
print(a)
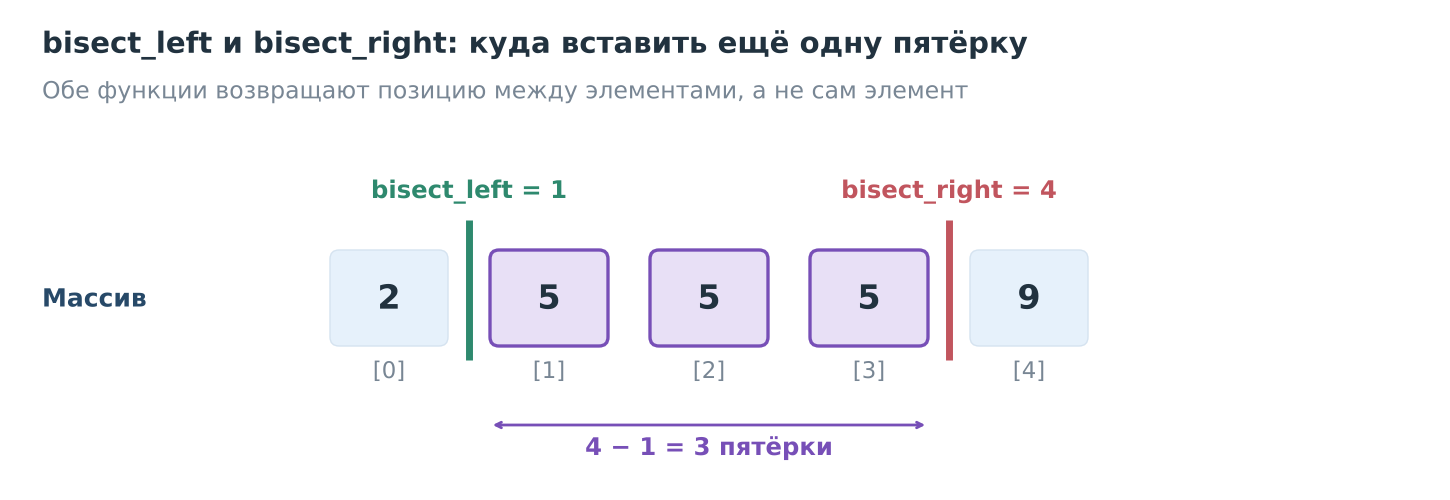
bisect_left указывает место перед дублями, bisect_right после них, разница равна числу повторов. Проверка pos < len(a) нужна, когда цель больше всех элементов. insort находит место за O(log n), но сдвиг элементов при вставке стоит O(n).
С Python 3.10 у функций есть параметр key. В bisect_left и bisect_right ключ применяется только к элементам списка, поэтому искать нужно по готовому ключу: bisect_left(rows, 15, key=lambda row: row[‘score’]). А insort_left извлекает ключ и из вставляемой записи, так что ему передают запись целиком. Дорогой ключ лучше посчитать заранее: при каждом поиске он вызывается заново.
Функции модуля не потокобезопасны: insort меняет список, а поиск в списке, который параллельно меняет другой поток, даёт неопределённый результат, так прямо сказано в документации Python. Поэтому блокировкой защищают всю работу с общим списком, а не только вызовы bisect.
Полезный блок со скидкой
Чтобы уверенно решать алгоритмические задачи с собеседований, посмотрите курс «Алгоритмы и структуры данных». Если код из статьи пока читается со словарём и хочется уверенно писать на Python с нуля, подойдёт курс «Python-разработчик». А тем, кто уже работает на Python и готовится к собеседованию, где после бинарного поиска спросят про архитектуру и асинхронность, стоит заглянуть на курс «Мидл Python-разработчик».
По промокоду: KOD (можно просто нажать) — вы получите скидку на все курсы Практикума.
В Практикуме есть и бесплатные вводные курсы по всем направлениям, от тестирования до аналитики.
Типичные ошибки в бинарном поиске
Границы перестали двигаться. Запись lo = mid вместо lo = mid + 1 создаёт вечный цикл: когда остаются два элемента, середина совпадает с lo. Поиск 3 в [1, 3] никогда не закончится.
# плохо: на двух элементах mid == lo
lo = mid
# хорошо: проверенную середину исключаем
lo = mid + 1
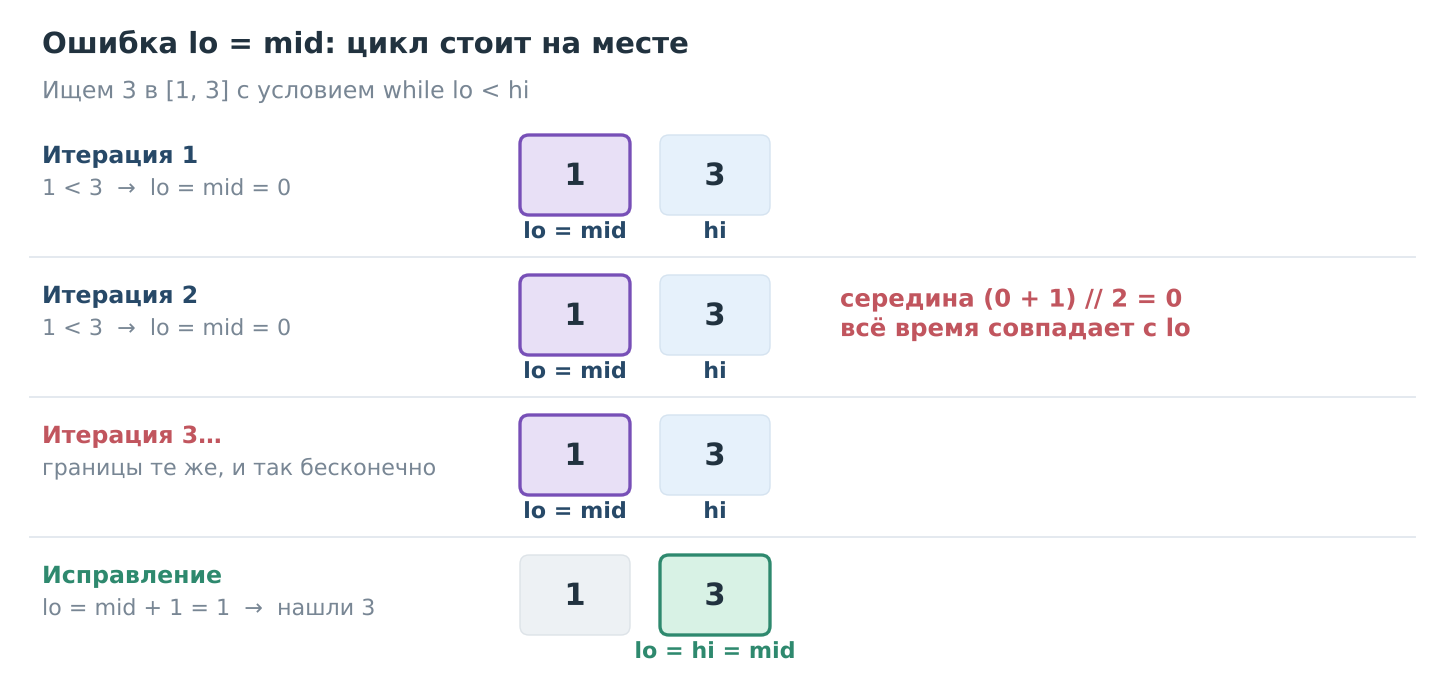
Если lo = mid действительно нужен, например, при поиске последнего подходящего значения, берите верхнюю середину (lo + hi + 1) // 2.
Пропущен последний элемент. Для отрезка [lo, hi] правильно hi = len(a) – 1 и while lo <= hi, для полуинтервала [lo, hi) нужны hi = len(a) и while lo < hi. Смешали соглашения, и код не найдёт 7 в [7] или упадёт с IndexError, обратившись к a[len(a)].

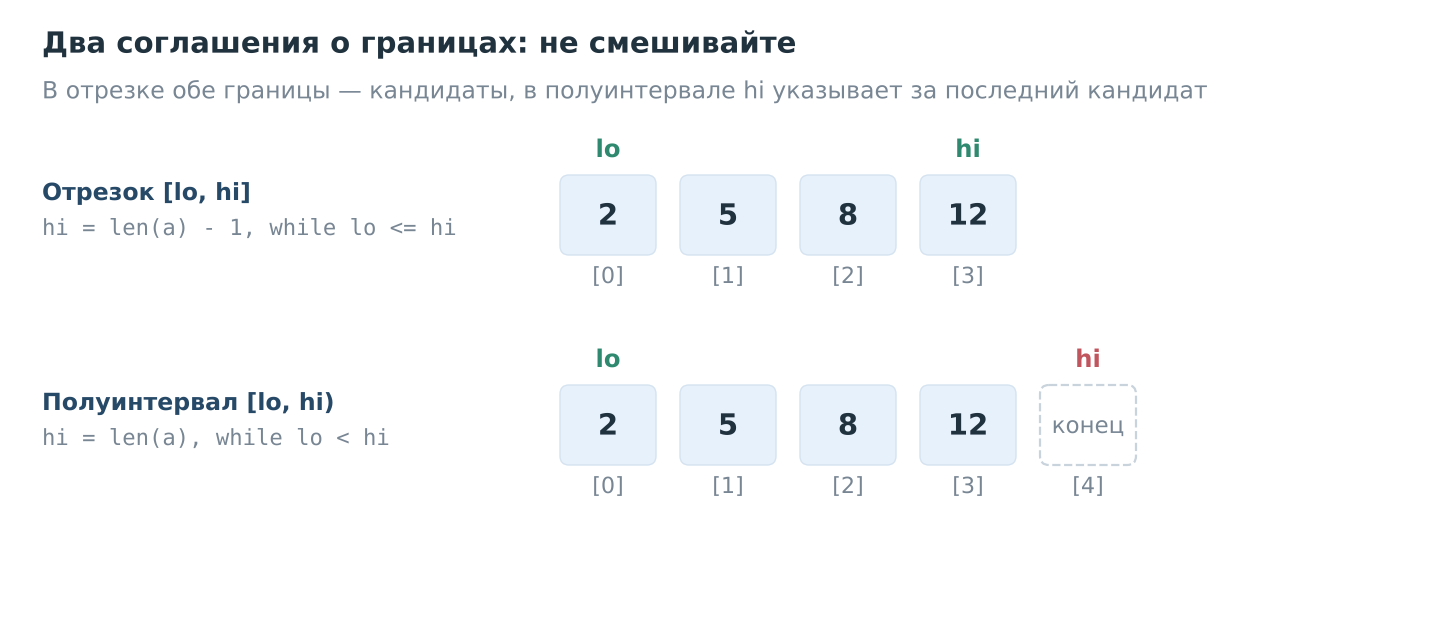
# плохо: на [7] и target = 7 цикл не запустится
lo, hi = 0, len(a) - 1
while lo < hi:
    ...
# хорошо: включённые границы и <=
while lo <= hi:
    ...
Срезы съели ускорение. Частая ошибка новичков: вместо сдвига границ на каждом шаге отрезать половину списка срезом. Но a[mid + 1:] создаёт новый список, копирования складываются в n/2 + n/4 + … ≈ n операций, и поиск превращается в O(n). Если функция при этом возвращает индекс, он считается внутри последнего среза, а не исходного списка. Вот такая реализация целиком:

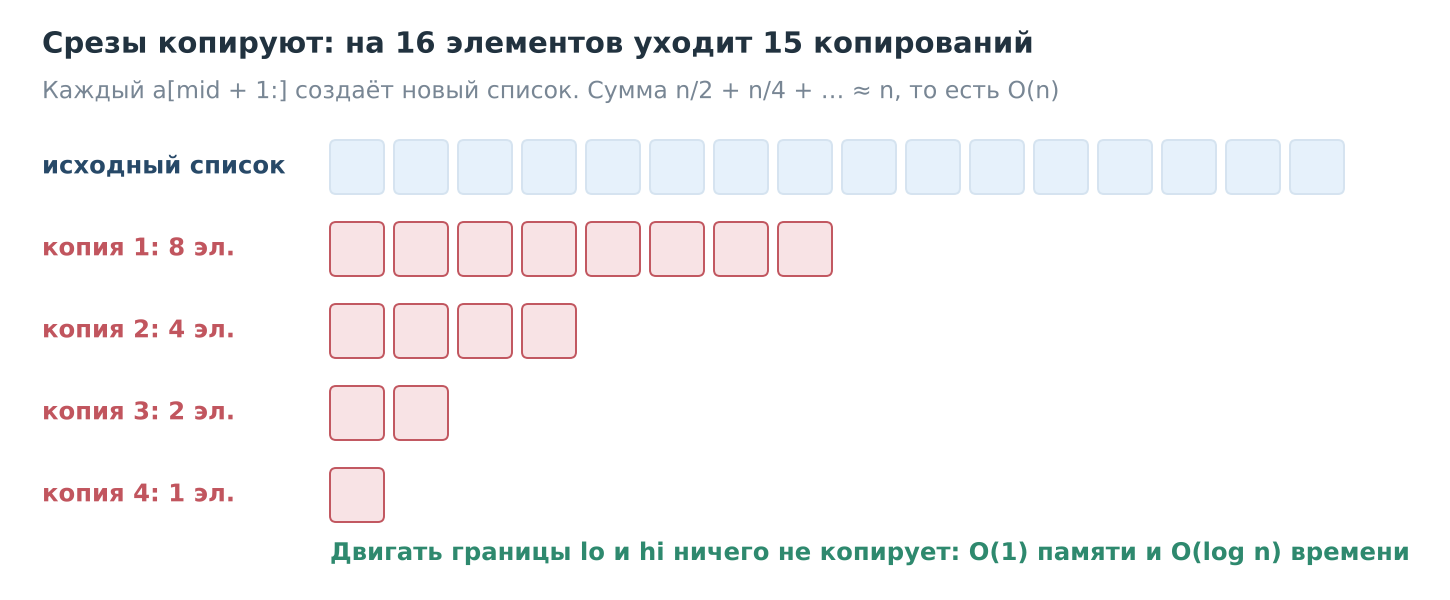
# плохо: каждый срез копирует половину списка,
# а индекс считается внутри среза
def search(a: list[int], target: int) -> int:
    if not a:
        return -1
    mid = len(a) // 2
    if a[mid] == target:
        return mid
    if a[mid] < target:
        return search(a[mid + 1:], target)
    return search(a[:mid], target)


# выведет 1, хотя 44 стоит на месте 7
print(search([2, 5, 8, 12, 16, 23, 38, 44, 57, 71, 90], 44))
Индекс можно починить, если при переходе вправо прибавлять смещение среза: mid + 1 + search(a[mid + 1:], target) с отдельной обработкой −1. Но копирование при этом останется, и поиск по-прежнему будет O(n). Правильный вариант работает с одним и тем же списком и двигает только границы, как binary_search выше: вместо search(a[mid + 1:], target) пишем lo = mid + 1.
Переполнилась середина. В Python целые числа не переполняются, а в Java, C++ и Go сумма двух больших индексов может выйти за пределы типа. Эту ошибку в 2006 году описал Джошуа Блох, автор java.util.Arrays.binarySearch: код ломался на массивах примерно от миллиарда элементов, и девять лет этого никто не замечал.

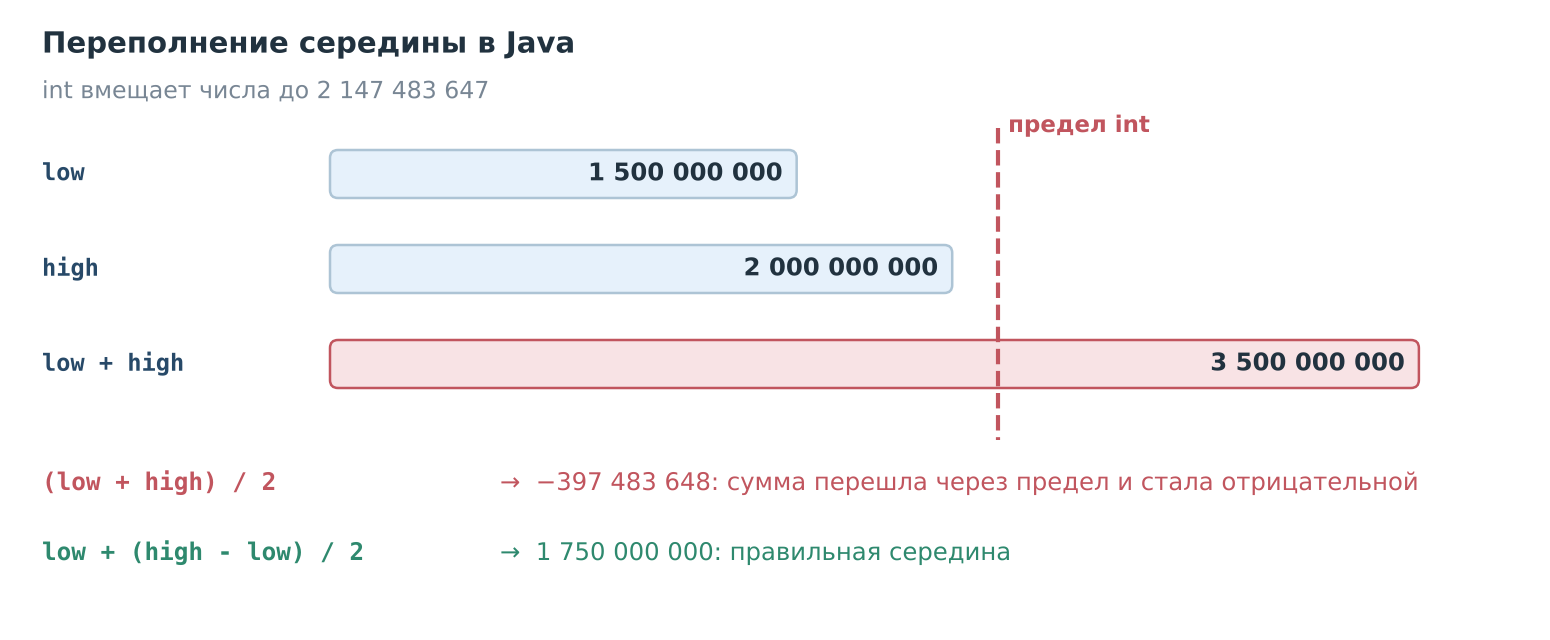
// плохо: low + high может превысить максимум int
int mid = (low + high) / 2;
// хорошо: разность границ не переполняется
int mid = low + (high - low) / 2;
Нарушена сортировка. Проверка порядка стоила бы O(n), поэтому бинарный поиск её не делает и на неотсортированных данных молча ошибается. При дублях классическая версия вернёт любое совпадение.
# выведет -1, хотя 9 стоит на месте 0
print(binary_search([9, 2, 7, 1, 5], 9))
# выведет 2, хотя первая двойка на месте 1
print(binary_search([1, 2, 2, 2, 3], 2))
Модификации бинарного поиска
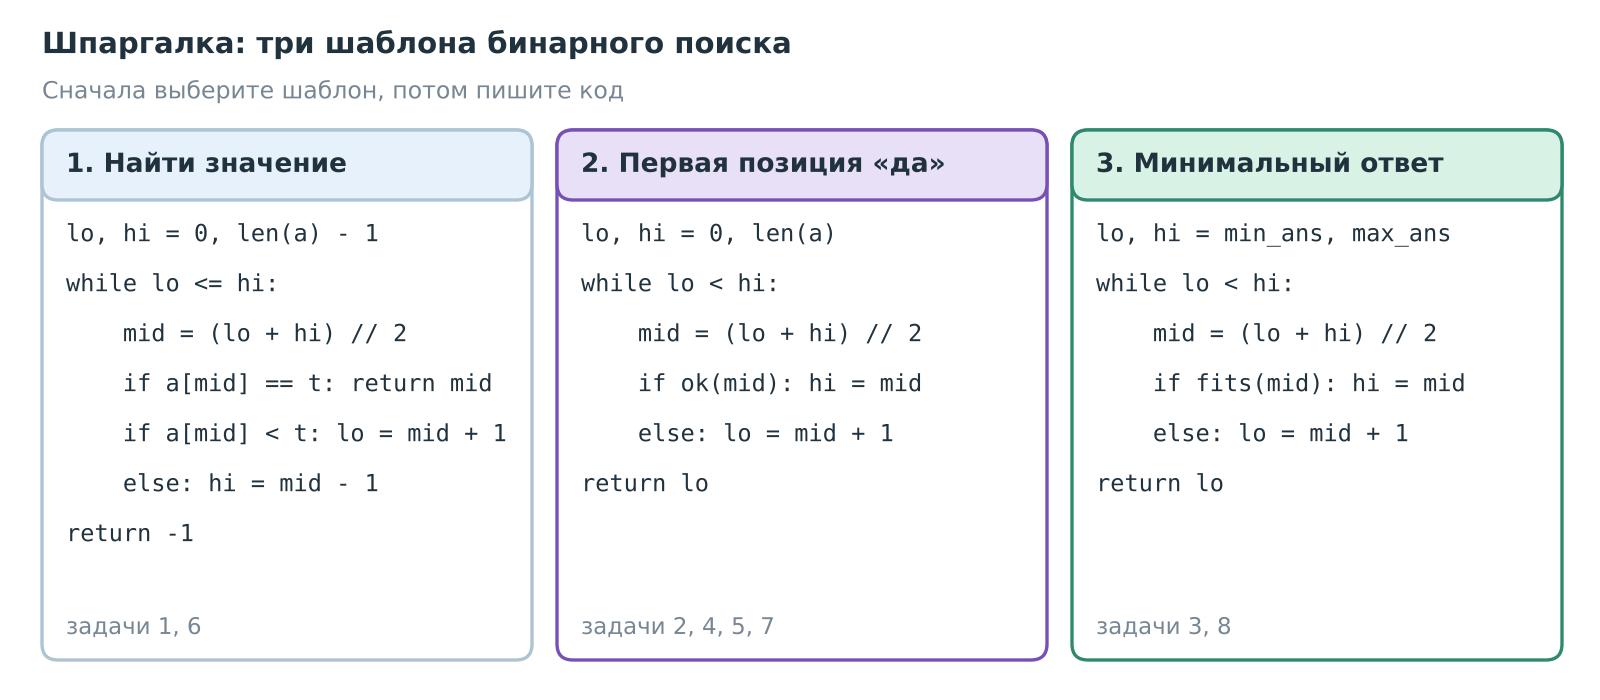
Почти любая задача на бинарный поиск укладывается в один из трёх шаблонов. Выберите шаблон до того, как писать код, и половина ошибок не случится:
| № | Что ищем | Границы и цикл | Сдвиг границ | Что вернуть |
|---|---|---|---|---|
| 1 | Конкретное значение | [lo, hi], lo <= hi | lo = mid + 1, hi = mid – 1 | mid или −1 |
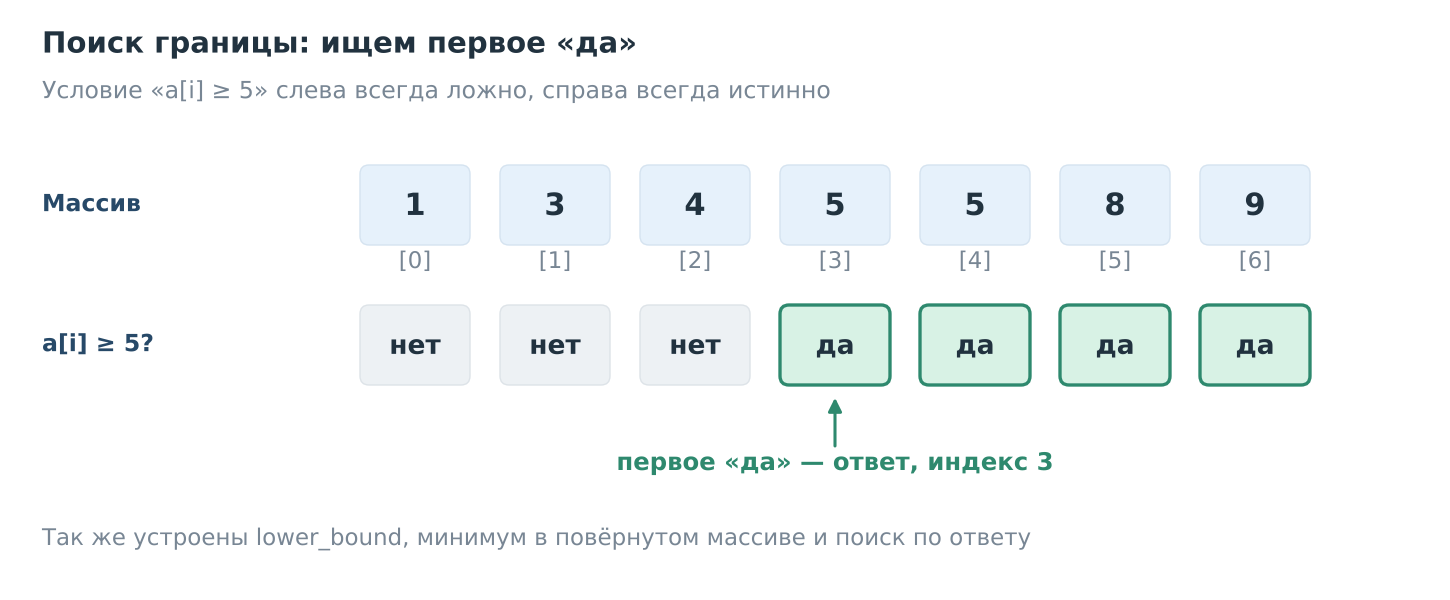
| 2 | Первую позицию, где условие истинно | [lo, hi), lo < hi | ложно: lo = mid + 1, истинно: hi = mid | lo |
| 3 | Минимальный подходящий ответ | по значениям ответа, lo < hi | не подходит: lo = mid + 1, подходит: hi = mid | lo |
Шаблоны 2 и 3 устроены одинаково. Условие вроде «элемент не меньше цели» или «скорости хватает» слева ложно, справа истинно: F F F T T T. Ищем точку перехода. Такое условие называют монотонным, и бинарный поиск работает с ним даже без отсортированного массива.
Поиск первого и последнего вхождения
С дублями ищут две границы: первый элемент не меньше target и первый элемент строго больше. В Python это bisect_left и bisect_right: для [1, 3, 3, 3, 8] и цели 3 они вернут 1 и 4, значит, тройки занимают индексы с 1 по 3. Ручная реализация обеих границ разобрана в задаче 4.
Бинарный поиск по ответу
Бинарный поиск по ответу работает, когда check(x) монотонна: до некоторого значения возвращает False, затем только True. Так ищут, например, минимальную мощность оборудования, которое успеет выполнить заказ.
from collections.abc import Callable


# минимальное x из [lo, hi], при котором check(x) истинно
def first_true(
    lo: int, hi: int, check: Callable[[int], bool]
) -> int:
    # пустой отрезок: искать негде
    if lo > hi:
        raise ValueError("нижняя граница больше верхней")
    # без этой проверки функция молча вернёт hi
    if not check(hi):
        raise ValueError("на отрезке [lo, hi] нет подходящего x")
    while lo < hi:
        mid = lo + (hi - lo) // 2
        # подходит: ответ в mid или левее
        if check(mid):
            hi = mid
        # не подходит: ответ правее
        else:
            lo = mid + 1
    return lo


# минимальное x, у которого 3x >= 25, выведет 9
print(first_true(1, 20, lambda x: x * 3 >= 25))
У шаблона одно обязательное условие: check(hi) должна быть истинной, то есть верхняя граница точно подходит. Иначе цикл всё равно сойдётся к hi и вернёт ответ, которого нет, поэтому функция проверяет это заранее. В задаче про Коко такой границей служит max(piles). Понадобится O(log R) проверок для R вариантов ответа. Если сама проверка стоит O(n), итог O(n log R).
Вещественный бинарный поиск

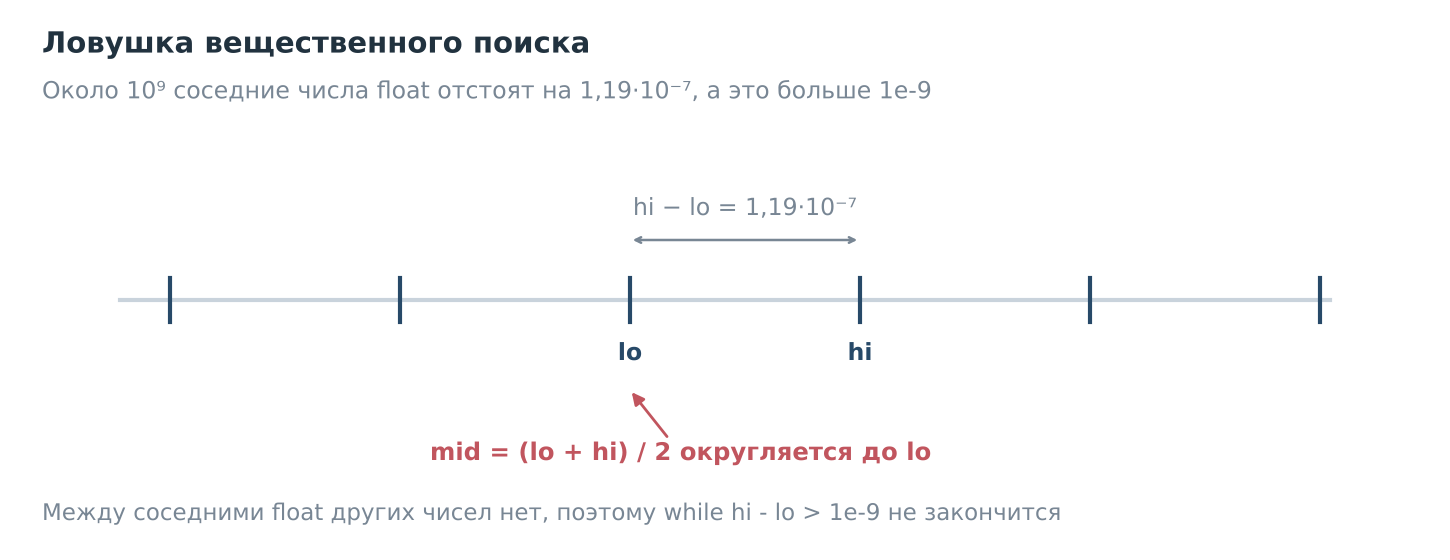
С дробными числами есть ловушка. Условие while hi – lo > 1e-9 может не стать ложным никогда: у больших чисел соседние значения float отстоят друг от друга больше чем на 1e-9, середина совпадает с границей, и цикл крутится вечно. Надёжнее сделать фиксированное число шагов:
# приближённый корень из x при 0 <= x <= 10**6
def sqrt_approx(x: float) -> float:
    # для отрицательных x корня нет
    if x < 0:
        raise ValueError("x должен быть неотрицательным")
    # иначе для нуля получится не 0.0, а число около 1e-19
    if x == 0:
        return 0.0
    lo, hi = 0.0, max(1.0, x)
    # 60 шагов сужают диапазон в 2⁶⁰ раз
    for _ in range(60):
        mid = (lo + hi) / 2
        # квадрат меньше x: корень правее
        if mid * mid < x:
            lo = mid
        # иначе корень левее
        else:
            hi = mid
    return (lo + hi) / 2


# выведет 1.414214
print(round(sqrt_approx(2.0), 6))
Число шагов прикидывают как log₂(ширина диапазона / точность): для отрезка до 10⁶ и точности 10⁻⁹ это около 50. Фиксированное число шагов гарантирует, что цикл остановится, но не даёт точности больше, чем позволяет float: результат не может быть точнее расстояния между соседними представимыми числами, а на больших значениях 60 шагов уже не хватит для малой ошибки.
Поиск в повёрнутом массиве
После сдвига [0, 1, 2, 4, 5, 6, 7] получается [4, 5, 6, 7, 0, 1, 2]. Относительно любой середины хотя бы одна половина отсортирована. Если значения уникальны, понять какая, легко: при a[lo] <= a[mid] левая, иначе правая. Дальше проверяем, попадает ли цель в отсортированную половину, и выбираем сторону.

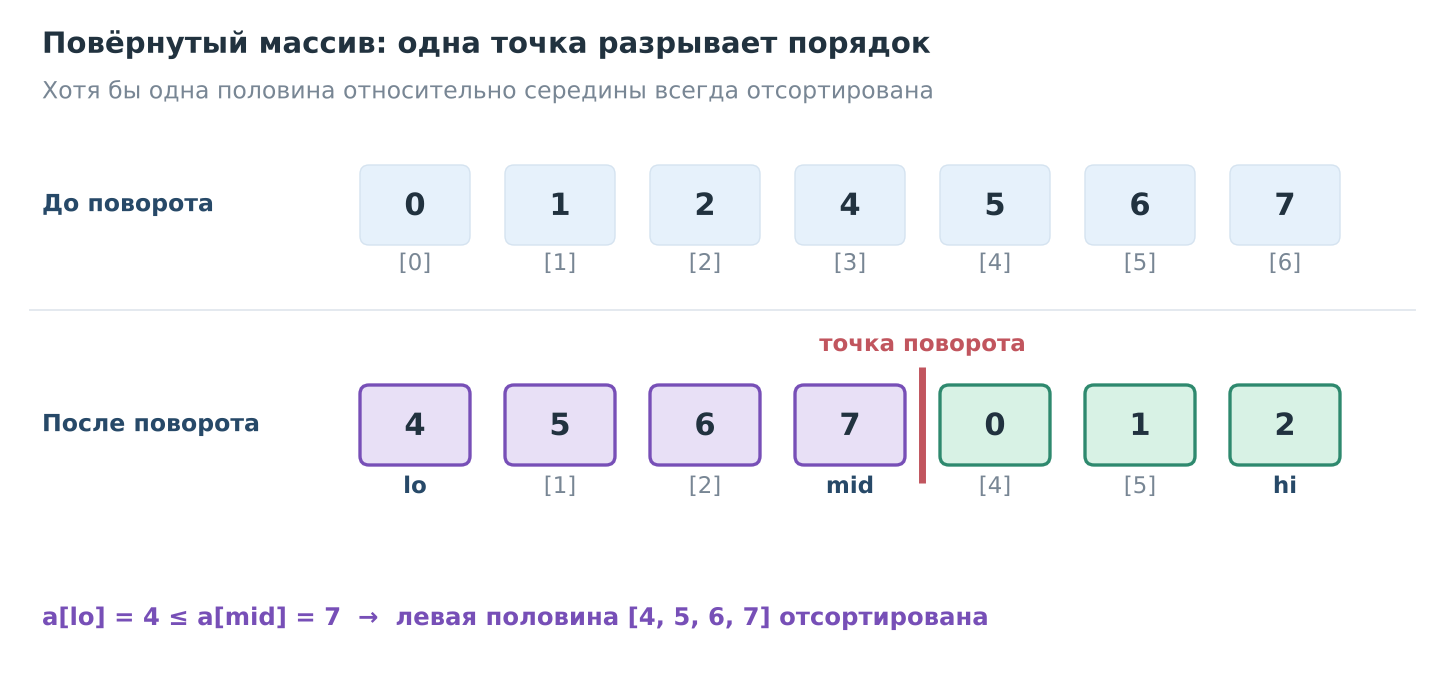
Минимум ищут сравнением a[mid] с a[hi]: если середина больше правого края, минимум правее, иначе он слева вместе с серединой. При дублях вроде [1, 1, 1, 0, 1] по краям и середине поворот уже не найти, и гарантия O(log n) пропадает.
Задачи на бинарный поиск
Каждую задачу сначала попробуйте решить сами на LeetCode, а подсказка с номером шаблона из таблицы выше поможет начать. Проверяйте решение на четырёх входах: пустой массив (если условие его допускает), один элемент, цель меньше минимума и больше максимума. Решения оформлены как class Solution, как ждёт платформа.
Задача 1. Найти индекс числа
[Легко] · LeetCode 704 · подсказка: шаблон 1
В отсортированном массиве уникальных чисел найдите индекс target или верните −1.
class Solution:
    # шаблон 1: обе границы — кандидаты
    def search(self, nums: list[int], target: int) -> int:
        lo, hi = 0, len(nums) - 1
        while lo <= hi:
            mid = lo + (hi - lo) // 2
            if nums[mid] == target:
                return mid
            # отбрасываем половину вместе с проверенным mid
            if nums[mid] < target:
                lo = mid + 1
            else:
                hi = mid - 1
        return -1


# выведет 3
print(Solution().search([-3, 0, 4, 9, 12], 9))
Каждое сравнение оставляет только ту половину, где цель может быть, а пересечение границ означает, что её нет. Типичная ошибка: while lo < hi при hi = len(nums) – 1. На [5] и цели 5 такой код вернёт −1. Время O(log n), память O(1).
Задача 2. Найти позицию вставки
[Легко] · LeetCode 35 · подсказка: шаблон 2
Верните индекс числа в отсортированном массиве, а если его нет, то индекс, куда его вставить без нарушения порядка.
class Solution:
    # первая позиция, где nums[i] >= target
    def searchInsert(self, nums: list[int], target: int) -> int:
        # hi = len(nums): ответ может быть за концом
        lo, hi = 0, len(nums)
        while lo < hi:
            mid = lo + (hi - lo) // 2
            # мало: ответ правее
            if nums[mid] < target:
                lo = mid + 1
            # подходит: ответ в mid или левее
            else:
                hi = mid
        return lo


# выведет 2
print(Solution().searchInsert([1, 3, 6, 8], 5))
Это ручная bisect_left. Полуинтервал позволяет вернуть len(nums) для цели больше всех элементов. Если по привычке взять hi = len(nums) – 1, для [1, 3, 6, 8] и цели 10 получится 3 вместо 4. Время O(log n), память O(1).
Задача 3. Вычислить целочисленный корень
[Легко] · LeetCode 69 · подсказка: шаблон 3, только ищем последнее подходящее
Для целого x ≥ 0 верните целую часть квадратного корня без math.sqrt, pow и дробных степеней.
class Solution:
    def mySqrt(self, x: int) -> int:
        lo, hi = 0, x
        # последнее mid, у которого mid² <= x
        answer = 0
        while lo <= hi:
            mid = lo + (hi - lo) // 2
            # подходит: запоминаем и ищем больше
            if mid * mid <= x:
                answer = mid
                lo = mid + 1
            # велико: ищем меньше
            else:
                hi = mid - 1
        return answer


# выведет 5
print(Solution().mySqrt(27))
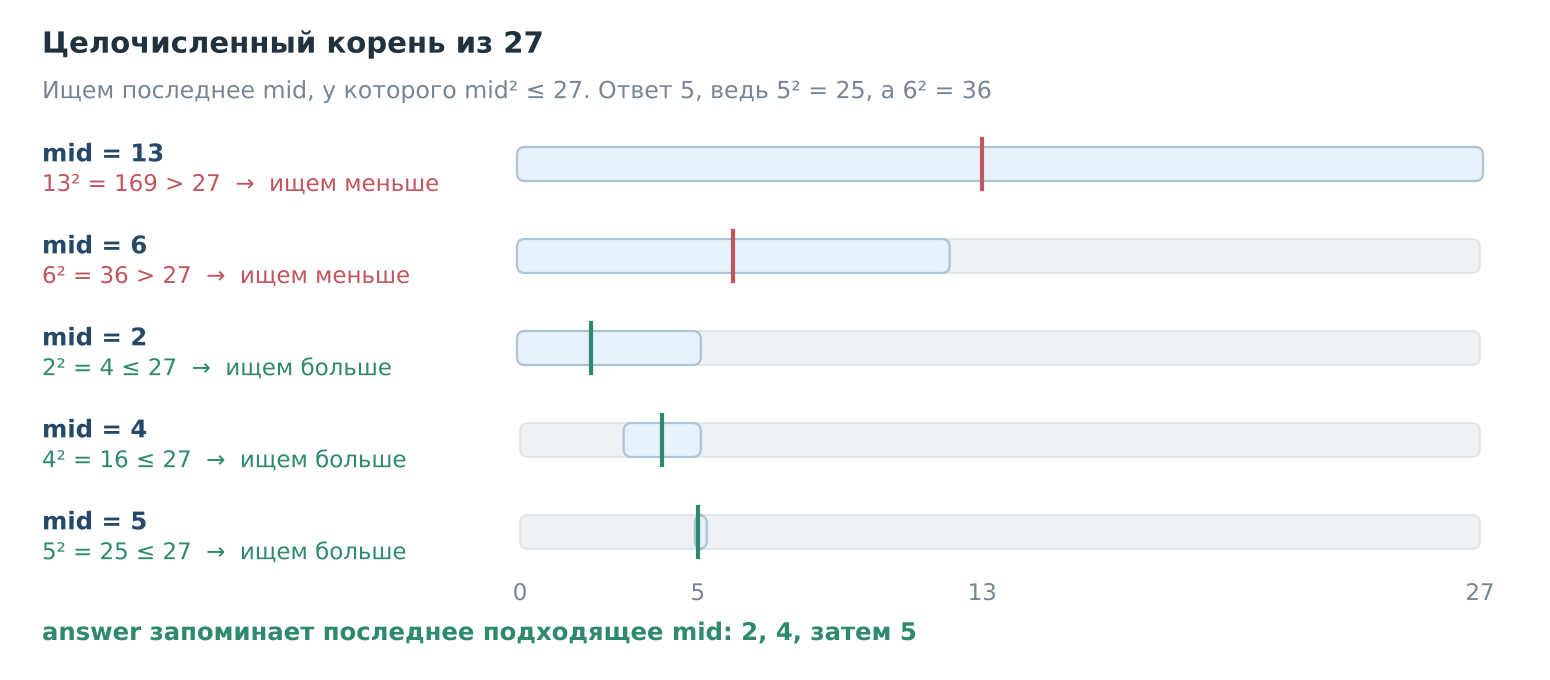
Ищем максимальное mid с mid² ≤ x, а answer хранит последний подходящий вариант. Частая ошибка состоит в том, чтобы вернуть lo вместо answer: после цикла он на единицу правее, и для 27 получится 6. В Java и C++ mid * mid может переполниться, там сравнивают mid <= x / mid. Время O(log x), память O(1).
Задача 4. Найти первое и последнее вхождение
[Средне] · LeetCode 34 · подсказка: дважды шаблон 2
Массив отсортирован, числа могут повторяться. Верните индексы первого и последнего вхождения цели либо [-1, -1].
class Solution:
    def searchRange(self, nums: list[int], target: int) -> list[int]:
        # первая позиция >= target или > target
        def boundary(after_equal: bool) -> int:
            lo, hi = 0, len(nums)
            while lo < hi:
                mid = lo + (hi - lo) // 2
                # ответ правее mid
                if nums[mid] < target or (
                    after_equal and nums[mid] == target
                ):
                    lo = mid + 1
                # ответ в mid или левее
                else:
                    hi = mid
            return lo

        first = boundary(False)
        # за концом или там другое число: target нет
        if first == len(nums) or nums[first] != target:
            return [-1, -1]
        # последнее вхождение стоит перед первым числом > target
        return [first, boundary(True) - 1]


# выведет [1, 3]
print(Solution().searchRange([1, 2, 2, 2, 7], 2))
boundary(False) находит начало блока одинаковых чисел, boundary(True) позицию сразу после него. Без проверки first == len(nums) пустой массив даст IndexError. Расширяться от найденного вхождения циклом тоже не стоит: на массиве из одинаковых чисел это O(n). Время O(log n), память O(1).
Задача 5. Найти минимум после поворота
[Средне] · LeetCode 153 · подсказка: шаблон 2
Отсортированный массив уникальных чисел циклически сдвинули. Найдите минимум, не перебирая все элементы.
class Solution:
    def findMin(self, nums: list[int]) -> int:
        lo, hi = 0, len(nums) - 1
        while lo < hi:
            mid = lo + (hi - lo) // 2
            # середина больше правого края: минимум правее
            if nums[mid] > nums[hi]:
                lo = mid + 1
            # иначе минимум в mid или левее
            else:
                hi = mid
        return nums[lo]


# выведет 1
print(Solution().findMin([5, 6, 8, 1, 3]))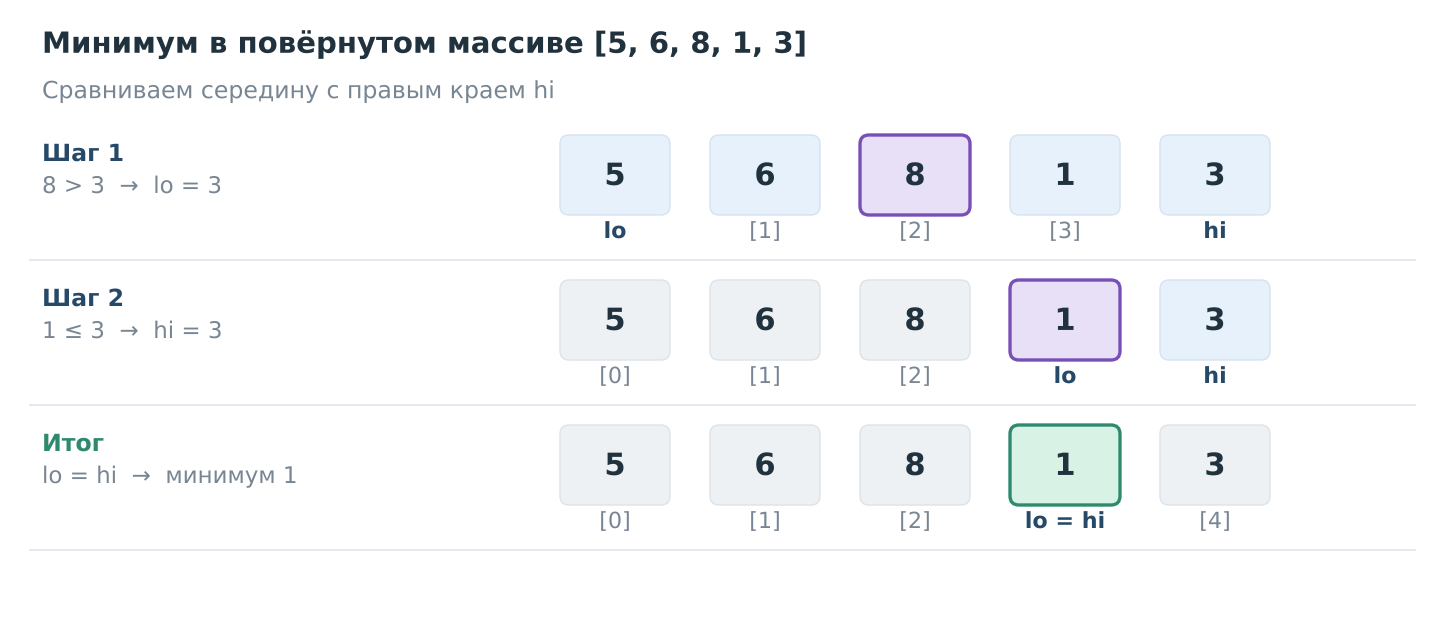
В повёрнутом массиве условие «элемент не больше последнего» ложно до точки поворота и истинно после неё, так что ищем первую истинную позицию. Если массив не повёрнут, условие истинно везде, и поиск вернёт индекс 0, то есть первый элемент. Если в этом коде просто заменить nums[hi] на nums[lo], на неповёрнутом [1, 2, 3] он вернёт 3. Сравнение с левым краем тоже можно сделать корректным, но тогда придётся отдельно обрабатывать отрезок, который уже отсортирован. Сравнение с правым краем проще. Время O(log n), память O(1).
Задача 6. Найти число после поворота
[Средне] · LeetCode 33 · подсказка: шаблон 1 плюс выбор отсортированной половины
В циклически сдвинутом массиве уникальных чисел найдите индекс target или верните −1.
class Solution:
    def search(self, nums: list[int], target: int) -> int:
        lo, hi = 0, len(nums) - 1
        while lo <= hi:
            mid = lo + (hi - lo) // 2
            if nums[mid] == target:
                return mid
            # отсортирована левая половина
            if nums[lo] <= nums[mid]:
                # цель внутри неё: идём влево, иначе вправо
                if nums[lo] <= target < nums[mid]:
                    hi = mid - 1
                else:
                    lo = mid + 1
            # отсортирована правая половина
            else:
                # цель внутри неё: идём вправо, иначе влево
                if nums[mid] < target <= nums[hi]:
                    lo = mid + 1
                else:
                    hi = mid - 1
        return -1


# выведет 4
print(Solution().search([6, 7, 0, 1, 2, 4, 5], 2))
Проверить, лежит ли цель внутри половины, можно только у отсортированной части: там диапазон задают края. Ловушка в строгом nums[lo] < nums[mid]: при двух элементах lo == mid, и на [3, 1] с целью 1 код вернёт −1. Время O(log n), память O(1).
Задача 7. Найти пиковый элемент
[Средне] · LeetCode 162 · подсказка: шаблон 2 без сортировки
Найдите индекс любого элемента, который больше соседей. Соседние числа различны, а за краями массива мысленно стоят значения меньше любых элементов.
class Solution:
    def findPeakElement(self, nums: list[int]) -> int:
        lo, hi = 0, len(nums) - 1
        while lo < hi:
            mid = lo + (hi - lo) // 2
            # справа подъём: пик правее mid
            if nums[mid] < nums[mid + 1]:
                lo = mid + 1
            # справа спуск: пик в mid или левее
            else:
                hi = mid
        return lo


# выведет 3
print(Solution().findPeakElement([1, 3, 2, 5, 4]))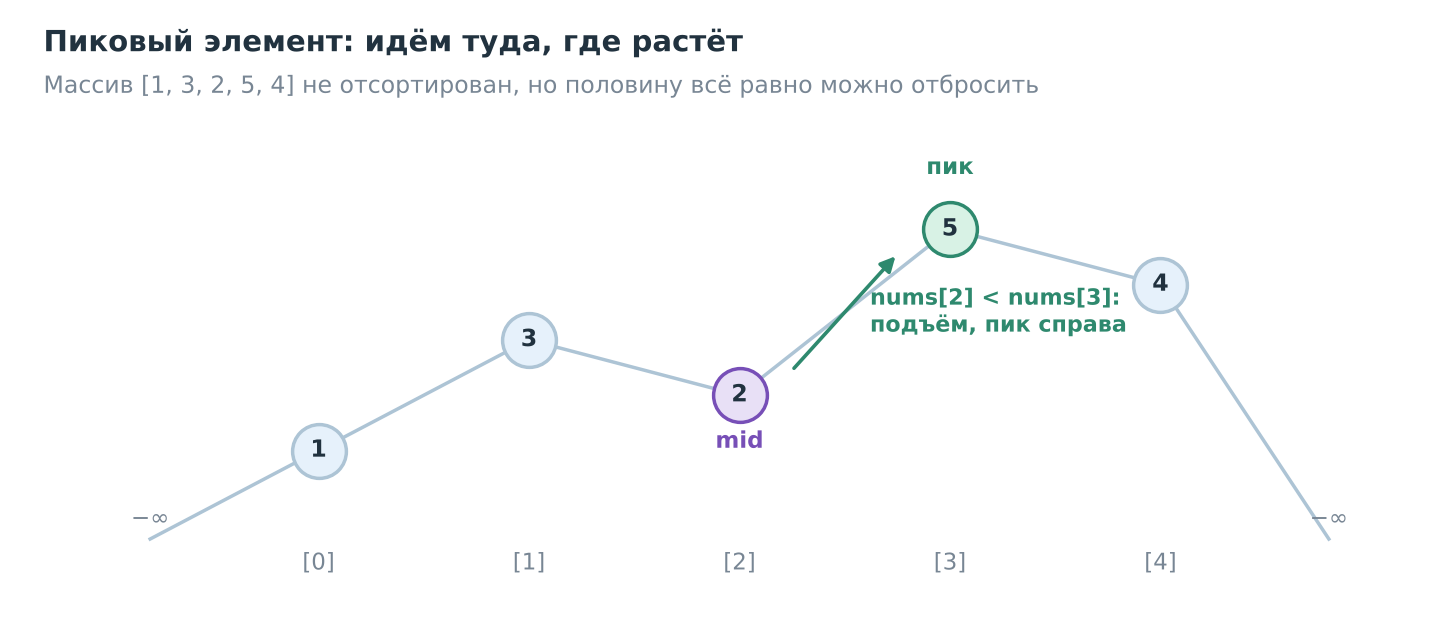
Массив не отсортирован, и это хороший урок: бинарному поиску нужно лишь условие, по которому можно уверенно отбросить половину. Подъём справа обязательно закончится пиком, ведь за краем стоят меньшие значения. С условием while lo <= hi на последнем шаге mid + 1 выйдет за пределы массива. Время O(log n), память O(1).
Задача 8. Подобрать минимальную скорость
[Средне] · LeetCode 875 · подсказка: шаблон 3
Обезьянка Коко ест бананы из нескольких куч, на всё у неё h часов. За час она съедает не больше k бананов из одной кучи, а доев кучу раньше, к другой в этот час не переходит. Найдите минимальную целую скорость k, чтобы успеть.
Это бинарный поиск по ответу: перебираем значения скорости, индексы массива здесь не нужны. Разберём по шагам.
Проверка. Куча из p бананов при скорости k съедается за p / k часов с округлением вверх, целочисленно (p + k – 1) // k. Суммируем по кучам и сравниваем с h.
Монотонность. Чем выше скорость, тем меньше часов. Если Коко успевает со скоростью k, успеет и с большей: условие выглядит как F F F T T T, нужно первое T.
Границы. Скорость не меньше 1. Сверху хватит max(piles): тогда каждая куча уходит за час, а часов по условию не меньше, чем куч.
class Solution:
    # минимальная скорость, чтобы успеть за h часов
    def minEatingSpeed(self, piles: list[int], h: int) -> int:
        # скорость от 1 до самой большой кучи
        lo, hi = 1, max(piles)
        while lo < hi:
            mid = lo + (hi - lo) // 2
            # часы при скорости mid с округлением вверх
            hours = sum((pile + mid - 1) // mid for pile in piles)
            # успевает: mid остаётся кандидатом
            if hours <= h:
                hi = mid
            # не успевает: нужно быстрее
            else:
                lo = mid + 1
        return lo


# выведет 4
print(Solution().minEatingSpeed([3, 6, 7, 11], 8))
Как сужаются границы на кучах [3, 6, 7, 11] при h = 8:
| Шаг | lo | hi | mid | Часы при скорости mid | Решение |
|---|---|---|---|---|---|
| 1 | 1 | 11 | 6 | 1 + 1 + 2 + 2 = 6 ≤ 8 | hi = 6 |
| 2 | 1 | 6 | 3 | 1 + 2 + 3 + 4 = 10 > 8 | lo = 4 |
| 3 | 4 | 6 | 5 | 1 + 2 + 2 + 3 = 8 ≤ 8 | hi = 5 |
| 4 | 4 | 5 | 4 | 1 + 2 + 2 + 3 = 8 ≤ 8 | hi = 4 |
Ответ 4: с этой скоростью Коко укладывается ровно в 8 часов, а со скоростью 3 ей нужно 10.

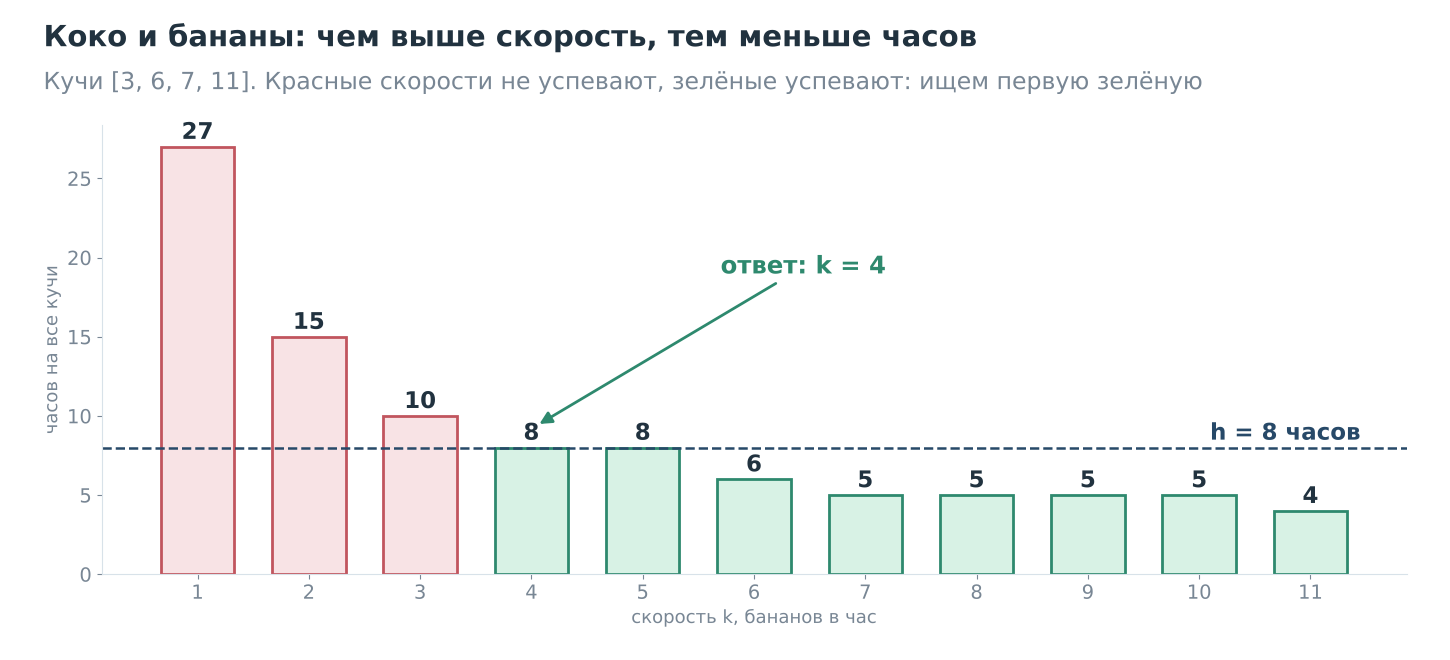
Ошибки здесь поучительные. lo = 0 даст деление на ноль. Строгое hours < h отбросит скорости, при которых Коко успевает впритык, и вернёт 6. А hi = mid – 1 после успешной проверки может выбросить сам ответ: на кучах [7, 1] при h = 6 код вернёт скорость 1, с которой нужно 8 часов.
Время O(n log M), память O(1), где M — самая большая куча. При ограничениях задачи это около 30 проверок, каждая проходит по всем кучам.

Частые вопросы
Можно ли применять бинарный поиск к связному списку?
Формально бинарный поиск применим, если элементы отсортированы. Но в связном списке нет быстрого доступа к середине: до неё приходится идти по ссылкам за O(n). Сам алгоритм работает, а выигрыш по времени теряется из-за стоимости доступа к элементу, и линейный проход оказывается не хуже. Для частых поисков лучше выбрать массив или сбалансированное дерево.
Чем бинарный поиск отличается от двоичного дерева поиска?
Бинарный поиск является алгоритмом и работает с готовым отсортированным массивом. Двоичное дерево поиска является структурой данных: в каждом узле ключи слева меньше, а справа больше. Сбалансированное дерево ищет за O(log n) и быстро вставляет элементы, а вырожденное, вытянутое в цепочку, тратит O(n).
Что вернёт бинарный поиск, если элементов несколько?
Классическая версия вернёт индекс того совпадения, на которое первым попала середина. Это может быть любое из равных чисел, не обязательно первое или последнее. Если нужна конкретная граница, используйте bisect_left для первого вхождения и bisect_right минус один для последнего или напишите аналоги по шаблону 2.
Почему bisect не находит элемент, а возвращает число?
Модуль решает другую задачу: ищет позицию, куда вставить значение, чтобы список остался отсортированным. Такой ответ полезен, даже когда значения в списке нет. Чтобы проверить наличие, возьмите индекс от bisect_left, убедитесь, что он меньше длины списка, и сравните элемент на этом месте с искомым.
Как бинарный поиск спрашивают на собеседовании?
Обычно с усложнением. Начинают с поиска числа, затем добавляют повторы, просят левую границу, поворачивают массив или дают задачу вообще без массива, как про бананы. Смотрят на код, объяснение инварианта, поведение на пустом входе и на то, можете ли вы доказать, что цикл закончится.
Заключение
Бинарный поиск работает, когда вы можете доказать, какую половину можно выбросить. Итеративный код и bisect закрывают большинство рабочих задач, а поиск границ и поиск по ответу пригодятся на собеседовании. Перед тем как писать код, выберите шаблон из таблицы и проверьте решение на пустом массиве и массиве из одного элемента.

Советуем дальше почитать
- Как отсортировать список в Python: sorted и sort — параметры key и reverse, сортировка словарей и объектов. Без этого бинарный поиск не на чем запускать.
- Как работает сортировка слиянием — ещё один алгоритм «раздели пополам», разобранный по шагам на массиве из четырёх чисел.
- Лямбда-функции в Python: что это и как работают — синтаксис и ограничения лямбд, которые передают в key у bisect и sorted.
- Хранение данных в дереве. Это как вообще? — двоичные деревья поиска и префиксное дерево Trie, на котором работают подсказки поиска и T9.
- Как устроен алгоритм поиска с возвратом — перебор, который отсекает заведомо неверные ветки, следующая ступень после бинарного поиска на собеседованиях.
Бонус для читателей
Хотите прокачать скиллы, чтобы расти в карьере без лишней суеты — берите промокод на курсы Яндекс Практикума. Он даст скидку и превратит инвестиции в себя в выгодную сделку. Бесплатные вводные курсы в Практикуме тоже есть. Стартовать можно в любой момент, карту привязывать не нужно, если что.