
Начинающие разработчики часто не понимают, почему сложность алгоритмов так важна, пока их приложение не падает на продакшене. Вы пишете скрипт, проверяете его на сотне записей — и всё отрабатывает за долю секунды. Но стоит загрузить в базу миллион строк, как тот же самый код намертво вешает сервер, пожирая всю оперативную память. Проблема здесь в том, как написан ваш код. В этой статье разберём, как оценивать свои решения до того, как они сломают систему.
ВАМ ПРИШЛО ПРИГЛАШЕНИЕ 💌
Приходите к нам в соцсети поделиться своим мнением и почитать, что пишут другие. А ещё там выходит дополнительный контент, которого нет на сайте — шпаргалки, опросы и разная дурка. В общем, вот тележка, вот ВК — велком!
Зачем измерять сложность
Если попытаться замерить производительность кода в секундах, мы получим бесполезные цифры. Секунды зависят от процессора, языка программирования и текущей загрузки ОС. Вы запустите скрипт на старом ноутбуке — он выполнится за 5 секунд. Запустите на мощном облачном сервере, и он отработает за 0,1 секунды. Код один и тот же, а время разное.
Поэтому инженеры измеряют не время, а то, как быстро растет количество базовых операций программы, когда увеличивается размер входных данных. Это позволяет оценить алгоритм математически.
Что означает запись O(n)
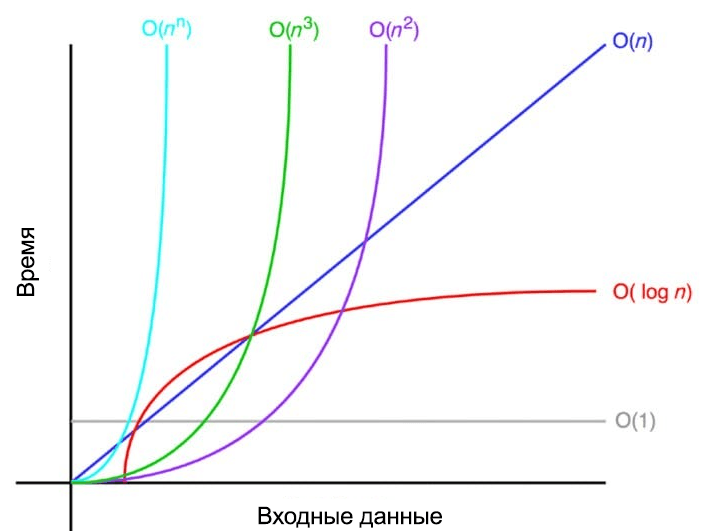
Математики придумали нотацию O-большое, чтобы описывать порядок роста функции. Буква «O» показывает верхнюю границу: код точно не будет работать медленнее, чем заявлено. Буква «n» — это размер входных данных (например, длина массива).
Разберем O(n) простыми словами. Если ваш алгоритм делает 3 прохода по массиву из n элементов и еще 15 дополнительных операций, математически это 3n + 15. Но в алгоритмике мы всегда отбрасываем константы и младшие слагаемые. При n = 1 000 000 прибавка в виде 15 операций не играет никакой роли. Мы смотрим только на самую быстрорастущую часть. Поэтому запись сокращается до O(n). Она говорит нам не о времени в секундах, а о том, что при увеличении данных в 10 раз, время работы увеличится тоже примерно в 10 раз.


Как посчитать сложность по коду
Теперь разберём, как определить сложность алгоритма на практике. Весь подсчёт операций сводится к анализу структуры вашего кода.
Один цикл по коллекции
Если у вас есть один цикл, который проходит по всем элементам списка, количество итераций равно размеру входа.
def print_items(arr):
    for item in arr: # n итераций
        print(item)
Вывод: cложность O(n).
Вложенные циклы
Когда цикл находится внутри другого цикла, и оба зависят от n, количество операций перемножается.
def print_pairs(arr):
    for i in arr:           # n итераций
        for j in arr:       # n итераций на каждый i
            print(i, j)
Вывод: cложность O(n2).
Оговорка: если внутренний цикл идет по фиксированному числу элементов (например, всегда от 1 до 5), то перемножения на n не происходит, и общая сложность остается O(n).
Деление задачи пополам
Классический двоичный поиск. Мы берем отсортированный массив и на каждом шаге отбрасываем половину элементов.
def binary_search(arr, target):
    low, high = 0, len(arr) - 1
    while low <= high:
        mid = (low + high) // 2
        if arr[mid] == target: return mid
        elif arr[mid] < target: low = mid + 1
        else: high = mid - 1
    return -1
Вывод: каждый шаг уменьшает массив вдвое. Это логарифм по основанию 2. Для массива из 1 000 000 элементов нам потребуется всего около 20 шагов. Итоговая сложность O(log n).
Последовательные блоки кода
Если алгоритм делает несколько разных действий одно за другим, их сложности складываются.
def process_data(arr):
    for item in arr: print(item)   # O(n)
    for i in arr:
        for j in arr: print(i, j)        # O(n^2)
Вывод: O(n) + O(n2). По правилам нотации оставляем только старшее слагаемое. Итог — O(n2).
Вызовы функций и рекурсия
Если внутри цикла вызывается другая функция, мы обязаны умножить итерации на сложность этой функции. С рекурсией сложнее: нужно строить дерево вызовов. Например, при сортировке слиянием (Merge Sort) массив делится пополам (log n уровней дерева), а на каждом уровне происходит слияние за O(n).
Вывод: перемножаем уровни на работу внутри уровня — получаем O(n log n).
Основные классы сложности
Классы сложности помогают разработчикам быстро понять, насколько алгоритм пригоден для продакшена.
| Класс | Название | Пример алгоритма | Операций при n = 1000 | При n = 1 000 000 |
| O(1) | постоянная | доступ к элементу массива по индексу | 1 | 1 |
| O(log n) | логарифмическая | двоичный поиск | ~10 | ~20 |
| O(n) | линейная | поиск максимума перебором | 1 000 | 1 000 000 |
| O(n log n) | линейно-логарифмическая | сортировка слиянием, Timsort | ~10 000 | ~20 000 000 |
| O(n²) | квадратичная | сортировка пузырьком | 1 000 000 | 10¹² |
| O(2ⁿ) | экспоненциальная | перебор подмножеств | недостижимо | недостижимо |
| O(n!) | факториальная | полный перебор перестановок | недостижимо | недостижимо |
Разберёмся, что значит «недостижимо»: если процессор выполняет миллион операций в секунду, то алгоритм, у которого квадратичная сложность, обработает миллион элементов (1012 операций) примерно за 11 с половиной суток. Алгоритмы с O(2n) на таких объемах не закончат работу до тепловой смерти Вселенной.
Большая скидка — 16% на все курсы Практикума
Если вы читаете эту статью, тогда вы точно разбираетесь в технологиях. Стать лучше и зарабатывать больше можно после курсов Практикума — по программированию, анализу данных и искусственному интеллекту.
До 17 сентября на все курсы действует скидка 16%, она применится автоматически при оплате. Потом цены станут выше, поэтому не откладывайте!
Ещё не пишете код свободно — начните с «Python-разработчика»; разобрались с синтаксисом, но путаетесь в сложности на собеседованиях — «Алгоритмы и структуры данных»; а если сложность отдельного фрагмента уже не проблема и хочется проектировать системы целиком — «Архитектуру программного обеспечения».
Сложность по памяти
Вторая ось оценки — это пространственная сложность. Мы анализируем, сколько памяти запрашивает алгоритм помимо самих входных данных (дополнительная память).
В разработке постоянно происходит размен время-память. Вы можете заставить код работать быстрее, если пожертвуете оперативной памятью, и наоборот. Рассмотрим поиск дубликатов в массиве.
Вариант 1 (экономим память): перебираем каждый элемент с каждым. Алгоритм работает «на месте» (in-place). Время: O(n2). Память: O(1).
def has_duplicates_slow(arr):
    for i in range(len(arr)):
        for j in range(i + 1, len(arr)):
            if arr[i] == arr[j]: return True
    return False
Вариант 2 (экономим время): заводим дополнительную структуру set. Проверка занимает мгновение, но мы копируем данные. Время: O(n). Память: O(n).
def has_duplicates_fast(arr):
    seen = set() # O(n) дополнительной памяти
    for item in arr:
        if item in seen: return True
        seen.add(item)
    return False
Лучший, средний и худший случай
У одного алгоритма почти всегда есть несколько оценок. Нас интересует худший случай, поскольку он показывает предел, при котором система не упадет. Средняя сложность отражает поведение на типичных данных.
Возьмем быструю сортировку (Quick Sort). В среднем она отрабатывает за идеальные O(n log n). Но если выбрать опорным элементом самый маленький или самый большой, то массив не разделится пополам, и сложность скатится до O(n2).
Еще есть амортизированная сложность. Типичный случай — добавление элемента в динамический массив (список в Python). Обычно элемент просто встает в конец за O(1). Но когда внутренний массив заполняется, Python выделяет новый кусок памяти вдвое большего размера и копирует туда все старые элементы за O(n). Но поскольку это происходит редко, затраты «размазываются» по всем вставкам. Итог: амортизированная вставка стоит O(1).
| Алгоритм | Худший случай | Средний случай | Амортизированно |
| Быстрая сортировка | O(n2) | O(n log n) | — |
| Добавление (append) | O(n) | — | O(1) |
Сложность операций в структурах данных
Хороший разработчик обязан знать сложность структур данных, с которыми он работает. В Python и JavaScript (под капотом объектов) чаще всего используются эти типы:
| Структура | Доступ по индексу | Поиск значения | Вставка | Удаление |
| Массив, list | O(1) | O(n) | O(n), в конец амортизированно O(1) | O(n) |
| Связный список | O(n) | O(n) | O(1) при известной позиции | O(1) при известной позиции |
| Хеш-таблица, dict | — | O(1) в среднем, O(n) в худшем | O(1) в среднем | O(1) в среднем |
| Множество, set | — | O(1) в среднем | O(1) в среднем | O(1) в среднем |
| Сбалансированное дерево | — | O(log n) | O(log n) | O(log n) |
| Куча (heap) | — | O(n) | O(log n) | O(log n) для минимума |
Конструкция if item in my_list работает за O(n) и тормозит код. Та же самая проверка if item in my_set (по хеш-таблице) работает за O(1). Просто поменяв тип коллекции, вы ускоряете программу без изменения бизнес-логики.
Как сложность проявляется в рабочем коде
Проблемы производительности (или узкое место) чаще всего возникают из-за неочевидных вложенных вызовов. Рассмотрим, как оптимизация кода решает эти проблемы.
- Фрагмент: поиск соответствия перебором двух списков.
Сложность: O(n × m) — вложенный цикл.
Как переписать: превратить второй список в словарь (dict) перед циклом. Сложность станет O(n + m). - Фрагмент: сборка длинной строки конкатенацией
text += wordв цикле.
Сложность: часто O(n2), так как строки неизменяемы, и язык при каждом плюсе создает новую строку в памяти.
Как переписать: собирать слова в массив и в конце делать”.join(array). Сложность упадет до O(n). - Фрагмент:
if item in list:внутри циклаfor.
Сложность: O(n2).
Как переписать: конвертировать список в множествоset(list)перед циклом. Итоговая сложность: O(n). - Фрагмент: запрос к базе данных внутри цикла (проблема N+1).
Сложность: выполняется O(n) сетевых запросов.
Как переписать: сделать один запрос сWHERE id IN (…)и индексами до цикла.. Мы получаем O(1) запросов к БД, что в сотни раз быстрее.
Где оценка O-большое обманывает
Ограничения асимптотики заключаются в том, что она описывает поведение на бесконечности. Но в реальности мы работаем с конечными данными.
Во-первых, нотация отбрасывает константу. Если у нас есть алгоритм O(n), который выполняет 1000 операций на элемент, и алгоритм O(n2), который выполняет 1 операцию на элемент, то на малых данных (например, n = 10) второй отработает в сто раз быстрее. Именно поэтому системные функции сортировки в языках (Timsort в Python) для коротких кусков массива переключаются на «медленную» сортировку вставками.
Во-вторых, O-большое не учитывает особенности архитектуры процессора (кеш). Последовательный проход по массиву O(n) в жизни будет намного быстрее, чем проход по связному списку O(n). Элементы массива лежат в памяти кучно и попадают в L1-кеш процессора, а узлы списка разбросаны по памяти, что заставляет процессор простаивать в ожидании данных.

Как рассуждать о сложности на собеседовании
Когда вы проходите техническое интервью и начинается алгоритмическая секция, интервьюер почти всегда задает вопросы про сложность. Отвечать нужно структурно. Допустим, вам задают такие вопросы:
- Назовите, что именно вы берете за размер входа (n).
- Разберите код по блокам, проговаривая сложность каждого.
- Назовите финальную оценку по времени.
- Назовите финальную оценку по памяти.
- Обязательно скажите, для какого случая эта оценка (средний или худший).
- Предложите вариант оптимизации.
Ответить можно примерно так: здесь мы ищем элемент в неотсортированном массиве. Размер входа n — это длина массива. В худшем случае нужного элемента там нет, и мы пройдем циклом по всем элементам. Сложность по времени O(n). Дополнительных структур мы не создаем, работаем in-place, поэтому сложность по памяти будет составлять O(1). Ускорить поиск можно, только если мы заранее отсортируем массив (за O(n log n)), тогда мы применим двоичный поиск за O(log n).
На собеседовании вас точно спросят сложность поиска в отсортированном массиве (O(log n)), почему словарь быстрее списка (хеширование дает O(1)), как ускорить вложенный цикл (использовать хеш-таблицу) и чем Timsort отличается от быстрой сортировки (Timsort стабилен и гарантирует O(n log n) в худшем случае, а Quick Sort падает до O(n2)).
Задачи для самопроверки
Рассмотрим 5 фрагментов кода, типичных для задачи на сложность алгоритмов — из тех, что встречаются на LeetCode. Попробуйте определить их класс.
Одиночный цикл с условием if i % 2 == 0.
- Два вложенных цикла, где внутренний идет не от 0, а от текущего
iдоn. - Функция, которая делит массив пополам и вызывает сама себя для одной половины.
- Функция вычисления чисел Фибоначчи, которая внутри возвращает
fib(n-1) + fib(n-2). - Цикл for, который на каждом шаге делает
my_set.add(item).
Решения будут такими:
- Время O(n), память O(1). Мы всё равно проходим по всем элементам.
- Время O(n2), память O(1). Сумма арифметической прогрессии — это всё еще квадрат.
- Время O(log n), память O(1) (если без рекурсии) или O(log n) (стек рекурсии). Это двоичный поиск.
- Время O(2n), память O(n). Экспоненциальный рост вызовов.
- Время O(n), память O(n). Цикл линейный, вставка в сет O(1), но само множество потребует O(n) дополнительного места.

Частые вопросы
Чем O-большое отличается от тета и омега?
O-большое (O) показывает верхнюю границу алгоритма (хуже не будет). Омега (Ω) показывает нижнюю границу (лучший случай, быстрее не будет). Тета (Θ) используется, когда верхняя и нижняя границы совпадают, давая точную оценку работы алгоритма.
Почему константы отбрасывают?
Нотация описывает поведение функции при стремлении n к бесконечности. На огромных массивах данных влияние констант или младших степеней становится математически ничтожным на фоне роста старшей степени (например, n2 растет настолько агрессивно, что множитель 3n просто теряется на графике).
Какая сложность у сортировки в Python и JavaScript?
Встроенные сортировки (.sort()) под капотом используют Timsort. Этот алгоритм в лучшем случае (когда данные почти отсортированы) отрабатывает за O(n), а в среднем и худшем — за O(n log n).
Всегда ли O(log n) быстрее O(n)?
На бесконечно больших объемах данных — всегда. Но на микромассивах из 5-10 элементов обычный линейный перебор O(n) отработает быстрее из-за отсутствия накладных расходов на вычисления или рекурсию, присущих логарифмическим алгоритмам.
Нужна ли теория сложности, если код пишет ИИ?
Да, нужна. Нейросети часто генерируют «наивные» решения, использующие вложенные циклы, потому что такой код проще выглядит. Инженер обязан проверить асимптотику предложенного кода, иначе сгенерированный скрипт гарантированно положит сервера при росте базы.
Заключение
Нотация О-большое — это ваш радар. Эта оценка нужна ровно для одного: предсказать поведение вашей системы на данных, которых у вас пока нет. Считать и анализировать сложность алгоритмов стоит именно на этапе проектирования, до того, как объем трафика вырастет в тысячу раз и пользователи начнут жаловаться на зависания.
Советуем дополнительно почитать
Как работает функция yield в Python и что она умеет делать — способ обходить большие коллекции без лишних затрат памяти, когда O(n) по времени — не единственное, что важно.
Что такое стек простыми словами — структура, на которой держится стек вызовов рекурсии из раздела про Фибоначчи и сортировку слиянием.
Разбор: задача про массив и сумму чисел — практика на конкретной задаче с LeetCode: применение того же анализа сложности к реальному коду.
Задача с собеседования: как найти палиндром — вторая практическая задача того же формата, что и в разделе самопроверки, только с разбором решения.
Роадмап Golang: путь от нуля до джуниора в 2026 — для тех, кому асимптотика нужна не в Python: как теория сложности встраивается в путь на другом языке.
Бонус для читателей
Если вам интересно погрузиться в мир IT и при этом немного сэкономить, держите наш промокод на курсы Практикума. Он даст вам скидку при оплате, поможет с льготной ипотекой или безлимитом на маркетплейсах. Ладно, окей, это просто скидка, без остального, но хорошая.