Схема с SEO-оптимизацией была простой: человек вводит запрос, поисковик показывает список ссылок, человек выбирает одну и переходит на сайт. Теперь между запросом и сайтом чаще появляется нейросеть: она сама находит страницы, читает их и собирает готовый ответ, иногда со ссылками на источники. Чтобы ваш проект оказался среди этих источников, сайт нужно к этому подготовить. Этим занимается GEO.
В статье разберём, как нейросеть выбирает, на что сослаться, чем GEO отличается от привычного SEO и что проверить на своём сайте: в коде, в текстах и в отчётах вебмастерских сервисов. В конце будет план проверки, который можно повторять на любом проекте.
ВАМ ПРИШЛО ПРИГЛАШЕНИЕ 💌
Приходите к нам в соцсети поделиться своим мнением и почитать, что пишут другие. А ещё там выходит дополнительный контент, которого нет на сайте — шпаргалки, опросы и разная дурка. В общем, вот тележка, вот ВК — велком!
Что такое GEO
GEO расшифровывается как Generative Engine Optimization, или генеративная оптимизация. Так называют работу над тем, чтобы контент и сам проект появлялись в ответах генеративных систем. Например, Алиса AI ссылается на вашу инструкцию, а ChatGPT называет ваш сервис в подборке похожих инструментов.
Термин получил исследовательское описание в работе GEO: Generative Engine Optimization. Её препринт появился в 2023 году, а конференционная публикация вышла на KDD 2024. Авторы изучали, как изменения на исходной странице влияют на то, насколько заметно она представлена в сгенерированном ответе.
Здесь важно сразу развести три события, которые легко спутать. Допустим, нейросеть назвала ваш проект, но сослалась на обзор другого автора:
- упоминание получил ваш проект;
- источником стал чужой обзор;
- переход на ваш сайт появится в аналитике, только если пользователь сам до него дойдёт.
Если сложить всё это в одну метрику, потом не получится понять, что именно изменилось и какую задачу решать дальше.
Поэтому GEO начинается с конкретной цели. Для технического блога целью может быть ссылка на инструкцию в ответе. Для продукта — присутствие в ответах на вопросы о выборе решения. У таких целей разные запросы для проверки и разные страницы, с которыми нужно будет работать.
Как нейросеть выбирает источники для ответа
У нейросети есть два способа что-то узнать. Первый — знания, которые она получила во время обучения. Второй — материалы, которые система находит прямо в момент запроса. Это как разница между человеком, который отвечает по памяти, и человеком, который нашел ответ в интернете. Популярные нейросети сегодня совмещают оба способа.
Когда модель отвечает по памяти, новая страница на вашем сайте ничего не меняет: модель о ней просто не знает. А вот в нейропоиске у системы есть путь к свежим материалам. На этот путь и можно влиять: через доступность сайта, содержание страниц и их присутствие в поиске.
В руководстве Google описаны два механизма: RAG и query fan-out.
RAG (retrieval-augmented generation) — генерация, дополненная найденной информацией. Система сначала извлекает подходящие материалы, а потом опирается на них, когда пишет ответ. Подробнее о том, как устроен RAG, мы уже рассказывали.
Query fan-out — это когда исходный вопрос разбивается на несколько связанных поисковых запросов. Так система собирает информацию по каждой части задачи отдельно. Сколько будет таких запросов, заранее неизвестно.
Посмотрим на примере. Пользователь спрашивает: «Как разрешить ChatGPT искать по моему сайту, но запретить сбор страниц для обучения?» Чтобы ответить, системе понадобятся сведения о поисковом боте, о боте для обучения и о правилах robots.txt. Это три отдельные подзадачи. Реальные внутренние запросы конкретного сервиса могут выглядеть иначе, но логика такая.
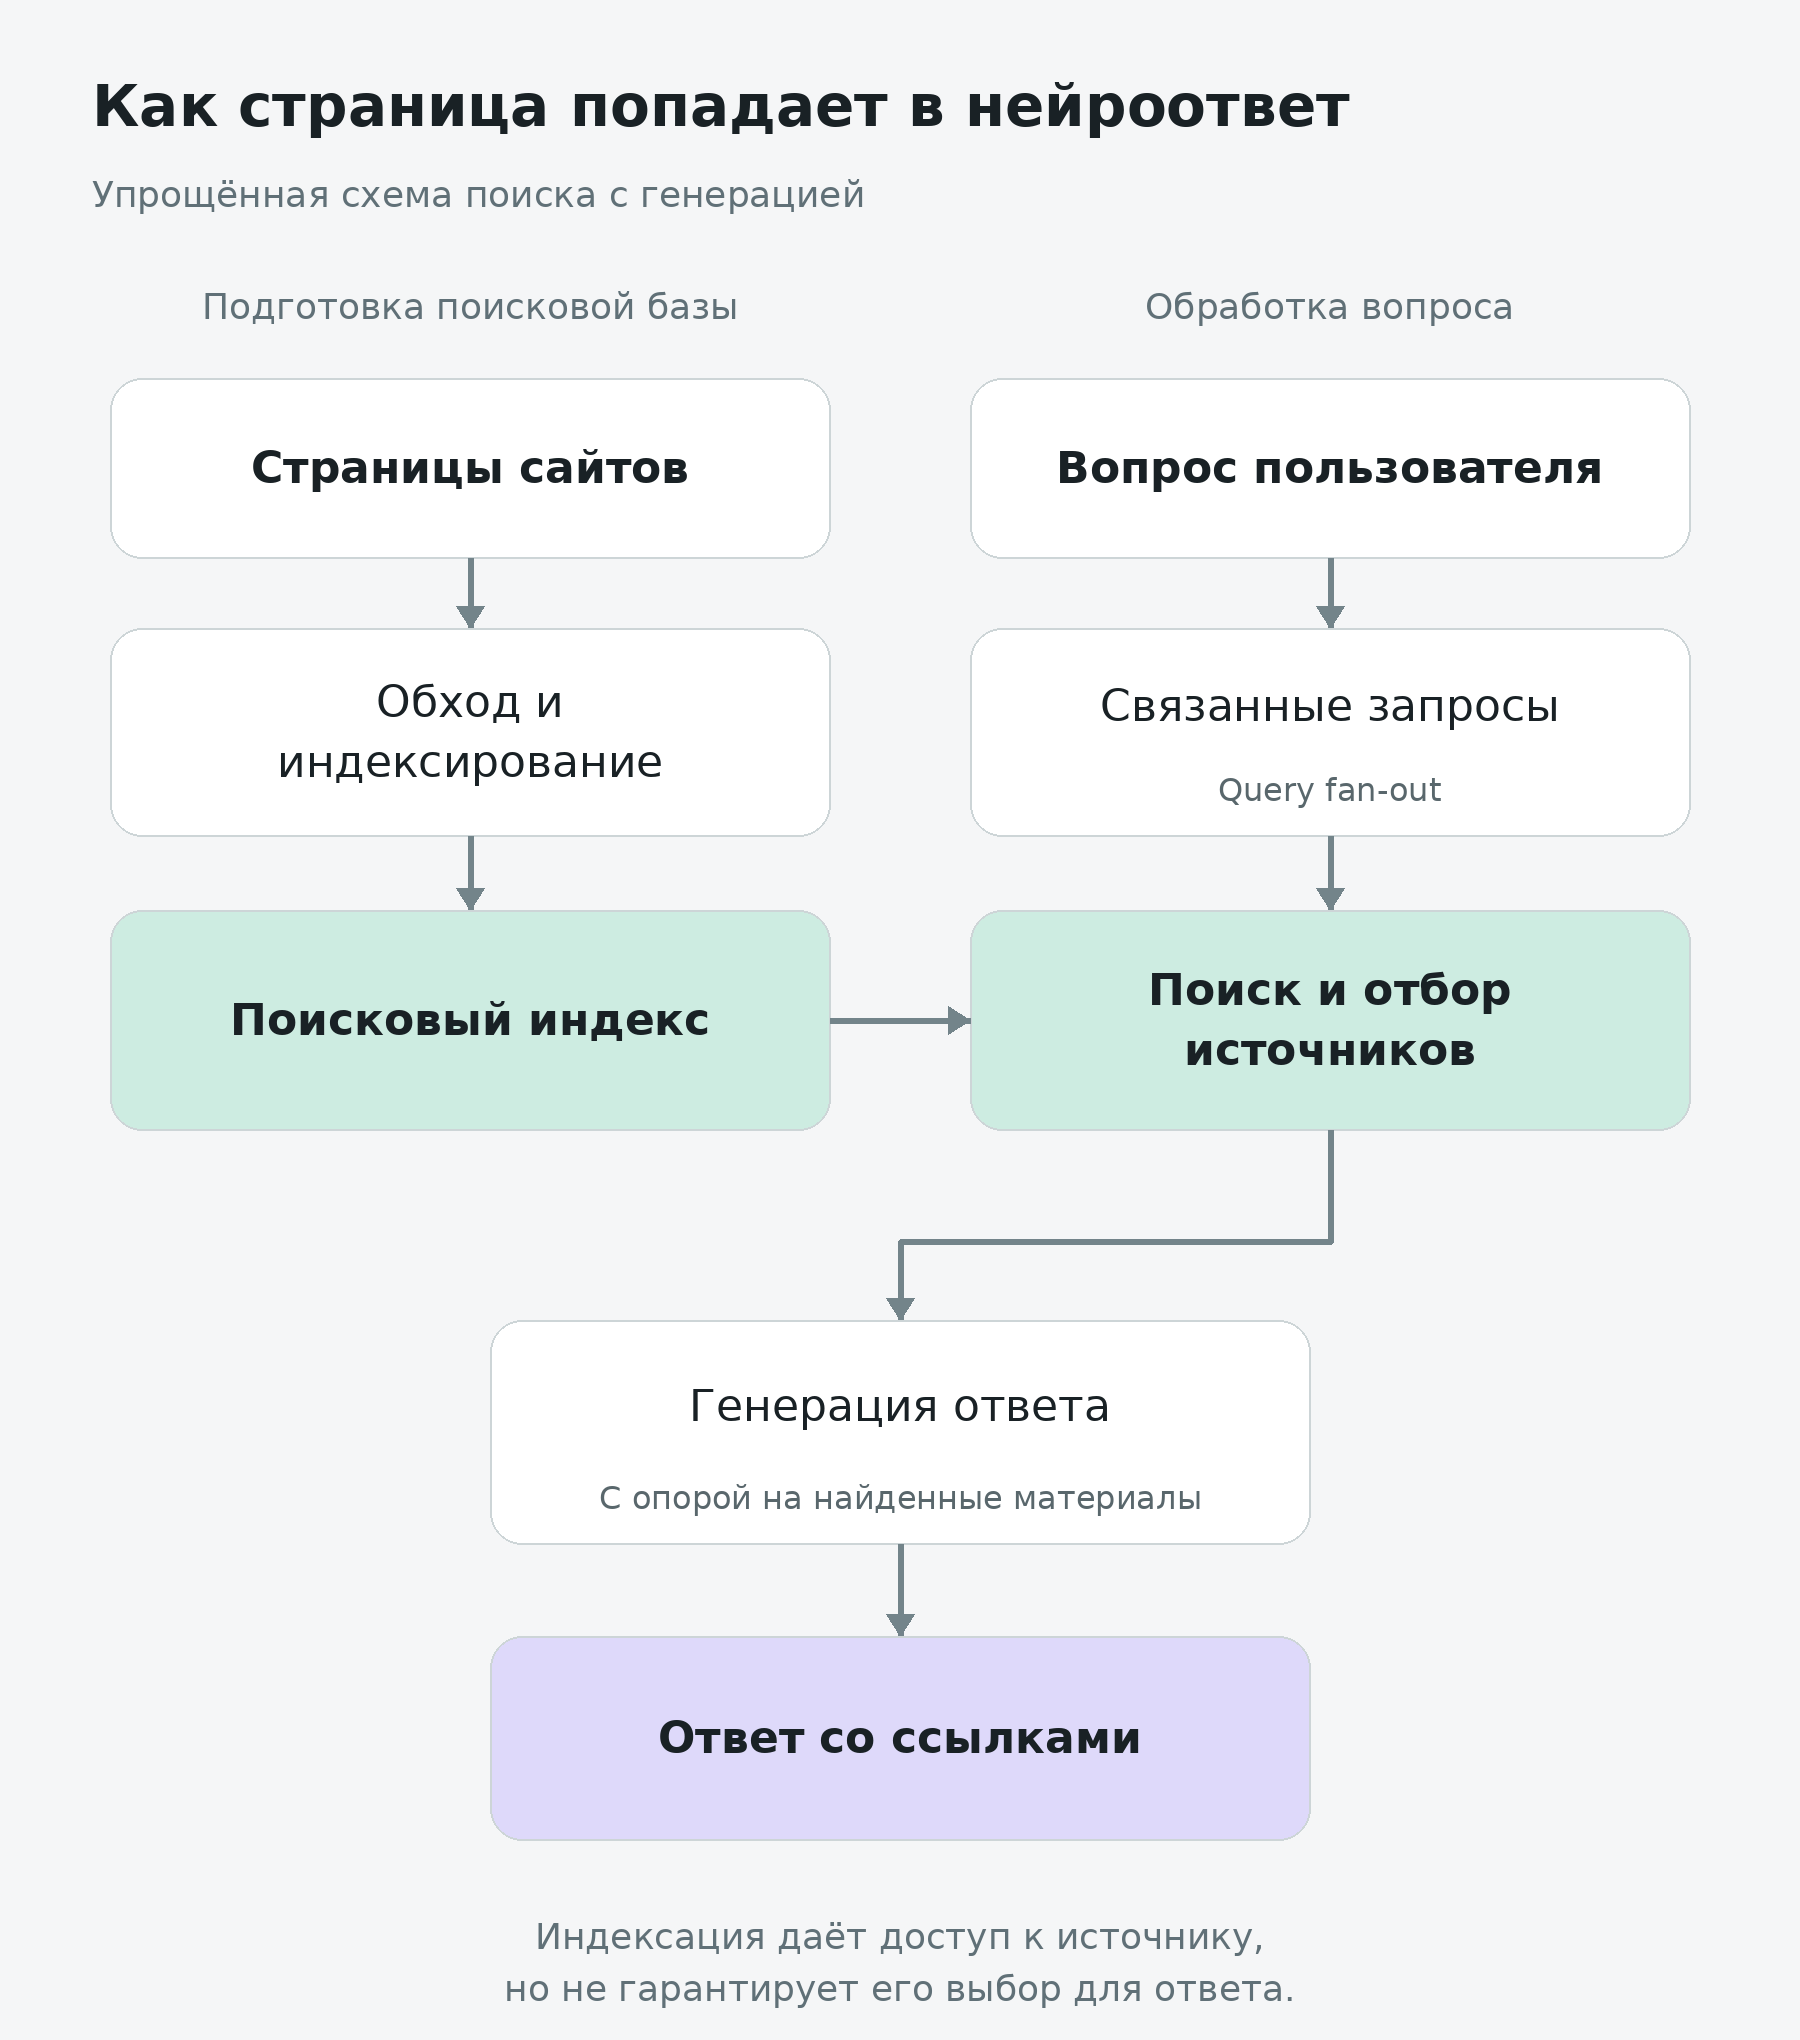
Яндекс описывает похожую последовательность: Алиса AI анализирует вопрос, формулирует уточняющие запросы, обращается к Поиску и собирает ответ по смысловым блокам. Порядок ссылок в таком ответе следует логике самого ответа, а не обычному ранжированию страниц.
Из этой схемы, мы понимаем, что, если вашей страницы нет в ответе, цепочка оборвалась на каком-то конкретном шаге. Вариантов четыре:
- Робот не может получить страницу.
- Страницы нет в индексе.
- Страница в индексе, но на ней нет нужной информации.
- Страницу нашли, но для этого ответа выбрали другую.
У каждого случая своё решение, а просто переписать первый абзац поможет только в третьем. То же касается позиций. Алиса действительно опирается на высоко ранжирующиеся источники, но правило, если нет в первых 20 результатах — нет в ответе — работает не всегда. Поиск идёт и по уточняющим вопросам, а сведения о проекте могут лежать вообще на другом сайте. Поэтому смотреть нужно на реальные источники ответов по вашей теме.
Чем GEO отличается от SEO
Главное отличие — в том, что мы измеряем. В обычной выдаче всё сводится к показам, позициям и кликам. В генеративном ответе к этому добавляются новые вопросы: упомянули ли проект, на какую страницу сослались и правильно ли описали продукт.
| Что сравниваем | SEO | GEO |
| Непосредственная цель | Видимость страниц в поисковой выдаче | Присутствие проекта и его материалов в нейроответах |
| Единица результата | Показ страницы, позиция, переход | Упоминание проекта, ссылка на источник, переход |
| Основные метрики | Показы, клики, CTR, позиции | Частота упоминаний и цитирований, доля присутствия в выбранных ответах |
| Проверка | Отчёты поисковых систем и аналитика сайта | Отчёты об ИИ-видимости и повторные проверки ответов |
| Общая основа | Доступность страниц, содержательный контент, понятная структура | Тот же фундамент плюс проверка того, как информация используется в ответах |
Google прямо относит оптимизацию под генеративные функции к SEO: эти функции работают на том же поисковом индексе и тех же основных системах ранжирования. Новое название не отменяет техническую работу над сайтом.
И ещё одно: упоминание само по себе не показывает, сколько людей зарегистрировались или купили продукт. Метрики GEO отвечают на вопрос «присутствует ли проект в ответах». Что пользователь делает дальше, показывает уже обычная аналитика.
Сколько трафика забирают нейроответы
Нейроответ может закрыть вопрос прямо в поиске. Человек прочитал ответ, получил что хотел и никуда не перешёл, даже если ваш сайт был в источниках. Такие сценарии называют zero-click. Масштаб этого явления оценивают несколько исследований. Важно понимать, что они считают разные вещи на разных данных, поэтому их цифры нельзя складывать или сравнивать напрямую.
В феврале 2026 года Ahrefs опубликовал анализ 300 тысяч запросов. Половина имела AI Overview, вторая половина состояла из информационных запросов без такого блока. Сравнивались данные Google Search Console по настольным устройствам за декабрь 2023 и декабрь 2025 года.
По оценке Ahrefs, присутствие AI Overview связано с CTR первой позиции примерно на 58% ниже ожидаемого без этого блока. Исследователи учитывали, что кликабельность снизилась и в группе без AI Overview. Поэтому 58% нельзя читать как «любой сайт потерял больше половины трафика» или как простое сравнение двух значений CTR.
Другой показатель дали SparkToro и Similarweb: в США за январь–апрель 2026 года 68,01% поисков Google завершились без клика. Здесь учитывались поиски в браузерах на компьютерах и мобильных устройствах. Речь обо всех таких поисках в выборке, включая запросы без нейроответа. В публикации эту долю сравнивают с 60,45% в 2024 году, но сами авторы говорят, что панель данных сменилась: наблюдения сделаны на разных наборах пользователей и устройств. Поэтому всю разницу нельзя объяснить появлением ИИ.
У Semrush есть исследование AI Mode, опубликованное в июле 2025 года. На данных почти 69 млн поисковых сессий Google в США на компьютерах изучалось поведение с 1 мая по 5 июля. Внутри этой выборки только 6–8% сессий AI Mode приводили к посещению внешнего домена. Отсюда часто цитируемые примерно 93% без внешнего перехода. Эта цифра относится к раннему периоду AI Mode. Её нельзя выдавать за текущую долю всех запросов Google или переносить на Алису.
Что из этого нужно понимать владельцу сайта: если переходов стало меньше, их стоит разбирать вместе с показами, позициями и составом выдачи, а присутствие в источниках — измерять отдельно. Тогда в отчёте будет видно, что произошло на самом деле: сайт стали реже находить, по ссылкам стали реже переходить или проект начали упоминать без ссылки на его страницу.
Полезный блок со скидкой
По промокоду: KOD (можно просто нажать) — вы получите скидку на все курсы Практикума.
Если хочется понять, как нейросети ищут и собирают ответы изнутри, посмотрите курс ИИ-инженер. Если ближе продвижение, есть Нейросети для маркетинга с модулем про SEO и проверку ответов ИИ, а начать с нуля можно на курсе Интернет-маркетолог.
Бесплатные вводные курсы в Практикуме тоже есть — по всем направлениям, от Python до аналитики.
Как попасть в ответы нейросетей
Начать можно с одной страницы, которая уже отвечает на важный для проекта вопрос. Пройдите с ней весь путь — от доступа робота до содержания ответа — и сохраните исходный замер. Тогда изменения можно будет связать с конкретной работой, а не с ощущением, что «текст стал лучше оптимизирован».
Проверьте индексацию и доступ ботов
Сначала выясните, может ли нужная система получить страницу и использовать её содержимое. Для Google базовые условия включают индексацию и возможность показа со сниппетом. Дополнительно проверьте настройку Search generative AI в Search Console: сайт не должен быть исключён из соответствующих генеративных функций.
У OpenAI поисковый обход и сбор данных для обучения разделены между двумя ботами. OAI-SearchBot работает на поиск в ChatGPT, а GPTBot собирает материалы, которые могут пойти на обучение моделей. Управлять ими можно независимо: например, первого пустить, второго — нет.
Например, такой фрагмент robots.txt разрешает поисковый обход OpenAI и запрещает обход для обучения:
# Правила для поискового бота ChatGPT
User-agent: OAI-SearchBot
# Разрешаем обход страниц для поиска
Allow: /

# Правила для бота, собирающего материалы для обучения
User-agent: GPTBot
# Запрещаем этому боту обход всех путей
Disallow: /
Это кусок кода, а не готовый файл для вашего сайта. Его нужно аккуратно сопоставить с уже существующими группами и ограничениями. И важно помнить, что настройка даёт боту только возможность обхода — появление страницы в ответе она не гарантирует.
У других сервисов свои боты:
- В Perplexity поиском занимается PerplexityBot. В документации отдельно сказано, что он не собирает контент для обучения базовых моделей.
- Для обычного поиска Яндекса проверьте доступ YandexBot. Ограничения на использование материалов в ответах Алисы настраиваются отдельно от основного обхода.
robots.txt — не единственное место, где бота могут остановить. Запросы иногда блокируются на уровне сервера или защиты от ботов. Поэтому загляните в логи и настройки защиты: получает ли бот содержимое страницы на самом деле. Perplexity рекомендует при настройке доступа учитывать и User-Agent, и опубликованные IP-адреса — название бота в заголовке запроса ещё не доказывает, кто этот запрос отправил.
Следующая проверка — JavaScript. То, что вы видите текст в своём браузере, не значит, что его видит робот. Google обрабатывает JavaScript-страницы в три этапа: обход, рендеринг и индексирование. Если основной текст появляется только после выполнения скрипта, он попадёт в индекс, только если рендеринг прошёл успешно и все нужные ресурсы были доступны.
У Google есть рендерер на основе Chromium, но не все боты умеют исполнять JavaScript. Поэтому для публичной документации и посадочных страниц имеет смысл рассмотреть серверный рендеринг или предварительную генерацию HTML. Конкретное решение зависит от устройства проекта, а начинать нужно с проверки: какой контент робот получает прямо сейчас.
И последнее — метатег robots и HTTP-заголовок X-Robots-Tag. В Google они работают так:
noindexисключает страницу из результатов поиска;nosnippetзапрещает текстовый сниппет и использование содержимого как прямого входа для AI Overviews и AI Mode;max-snippetограничивает объём такого использования.
Если одна из этих директив случайно попала в шаблон, она затронет сразу все страницы на его основе.
Ставьте ответ в начало раздела
Схема такая: подзаголовок формулирует вопрос, первый абзац на него отвечает, следующие абзацы объясняют условия и детали. В таком тексте сразу видно, есть ли на странице нужная информация. Объём менять не обязательно — часто достаточно переставить готовый ответ наверх и убрать длинную подводку.
Сравним два варианта начала раздела в документации:
Было: «Развитие генеративных технологий ставит перед владельцами сайтов новые вопросы управления информацией. При взаимодействии с автоматическими системами необходимо учитывать различные сценарии использования материалов».
Стало: «Чтобы разрешить поиск в ChatGPT и запретить обход для обучения, настройте отдельные группы OAI-SearchBot и GPTBot в robots.txt. Ниже — пример и объяснение, как учесть существующие ограничения сайта».
Во втором варианте читатель с первой фразы понимает, решает ли инструкция его задачу. Дальше ему нужны конфигурация, объяснение директив и ограничения. Это структура удобного технического текста. Сама по себе она не гарантирует попадания в нейроответ, но помогает системе найти ответ на странице.
Подгонять материал под правило «всё важное — в первых 30%» не нужно. Если в документации пять самостоятельных вопросов, каждый может получить свой раздел со своим ответом. Проверка простая: понятен ли смысл абзаца и можно ли по нему выполнить заявленное действие.
Добавляйте цифры, цитаты и источники
В исследовании GEO проверяли, как на видимость страницы влияют ссылки на источники, цитаты и количественные данные. Для самых результативных методов авторы описывают улучшение на 30-40% по метрике, которая учитывает объём использованного текста и его положение в ответе. Результат при этом зависел от метода, темы и способа измерения.
Для технического проекта рабочий вопрос звучит так: какие утверждения на странице читатель может проверить?
- Если сравниваете решения — укажите условия сравнения.
- Если приводите результат своего теста — опишите, что и как измеряли.
- Если ссылаетесь на чужое исследование — дайте ссылку на оригинал и сохраните его ограничения.
Пример: фраза «поддерживает JavaScript» оставляет открытым вопрос, что именно поддерживается. Описание конкретного поведения, условий работы и исключений даёт нейросети больше материала для точного ответа. А вот числа ради чисел ничего не добавляют: без метода измерения они ничего не объясняют.
Как попасть в ответы Алисы: работайте с данными вне сайта
Нейросеть может узнать о проекте не с вашего сайта, а из обзора, обсуждения или карточки компании. Поэтому проверять стоит не только свои страницы, но и внешние источники, которые появляются в ответах на важные для вас вопросы.
У Алисы есть и локальный сценарий. Яндекс описывает обращение к Поиску и Картам, включая сведения об организациях и учёт города пользователя. Для сайта компании это знак, что нужно проверить, согласованы ли данные на сайте и в её карточке: название, адрес, часы работы, услуги.
Если вы делаете проект для локального бизнеса, включите проверку карточки в Яндекс Бизнесе в работу над публичной информацией. Сайт и Карты — это два разных источника, и исправление на одном не обновит автоматически другой.
Как выбрать внешние площадки? Начните с ответов по своей теме. Посмотрите, откуда система берёт сведения о похожих проектах, откройте эти страницы и разберитесь, какую задачу закрывает каждая: сравнение решений, описание ограничений, практический опыт или отзыв.
То, что площадку цитируют, ещё не значит, что любая публикация на ней попадёт в ответы. Сначала нужна содержательная причина упомянуть ваш проект. Поэтому порядок такой: изучаем реальные страницы-источники, потом решаем, какие сведения о проекте на них можно опубликовать и чего там не хватает.
Показывайте автора и экспертизу
На технической странице должно быть понятно, откуда взялись утверждения. Кто проверял пример? На каком опыте основан вывод? Какая версия документации использована? Ответы на эти вопросы помогают читателю понять, подходит ли материал к его ситуации, ещё до того, как он скопирует конфигурацию.
В рекомендациях Google по полезному контенту отдельно упоминаются ясные источники, сведения об авторе и опыт. Для разработчика это значит: дополнить общие заявления проверяемыми деталями — описанием собственного теста, условиями воспроизведения, ссылками на документацию.
Дата обновления работает, когда материал действительно проверили и изменили. Если инструкция описывает старое поведение сервиса, новая дата её не обновит. В статье про настройку ботов, например, нужно перепроверить сами правила и назначение каждого User-Agent.
Профиль автора добавляет контекст, но не заменяет содержание. Читателю всё равно нужно видеть, как получен результат и где заканчиваются выводы, поэтому экспертиза страницы начинается с доказательств внутри неё.
Какие GEO-приёмы не работают
Часть советов обещает видимость после одного технического изменения. У таких обещаний стоит проверять две вещи: какой сервис должен это изменение учитывать и где он описал такое поведение.
llms.txt. Его иногда называют аналогом robots.txt для нейросетей, но задача у него другая. Это компактный указатель по материалам сайта для языковых моделей и агентов. Например, в документации OpenAI Agents SDK он содержит ссылки на разделы и их описания.
Anthropic в руководстве по созданию инструментов для агентов llms.txt как способ отдать модели документацию в удобном виде — агент получает сведения о библиотеке или API, с которыми работает.
С поисковой видимостью всё иначе. Google сообщает, что не использует llms.txt ни для ранжирования, ни как условие попадания в генеративные ответы. И то, что такой файл есть у документации ИИ-компании, не означает, что её поисковый продукт читает его на чужих сайтах.
Отсюда простой критерий: если ваш агент или инструмент действительно использует llms.txt, файл стоит поддерживать. Если цель — попасть в AI Overviews, рекомендации Google на этот файл не опираются.
Особая разметка, дробление страниц, нужная длина. То же руководство Google не требует специальной AI-разметки, разбиения материала на маленькие страницы или определённого объёма текста. Структурированные данные могут быть частью обычной поисковой оптимизации, но схемы, которая гарантирует попадание в нейроответ, Google не описывает.
Поэтому выносить каждый подзапрос на отдельную страницу или переписывать весь сайт под один шаблон не нужно, отдельная страница нужна, когда у неё появляется самостоятельная задача для читателя. И важный момент: у всех этих выводов есть область действия. Заявление Google относится к поиску Google. Требования других сервисов проверяются в их документации, а результат собственного эксперимента — в тех условиях, в которых он проводился.
Как проверить видимость сайта в нейросетях
Здесь два инструмента: отчёты сервисов и ручная проверка. Отчёт показывает накопленные данные по своей методике. Ручной запрос показывает, как звучит конкретный ответ и на какие источники он опирается.
Яндекс Вебмастер
В Вебмастере есть раздел «Видимость сайта в Алисе AI». Там видно долю присутствия сайта среди источников, её динамику, примеры запросов и страницы других сайтов в той же тематике. Данные доступны за последние три месяца и обновляются раз в неделю.
У показателя Share of Voice есть важная граница: статистика собирается только по запросам, где сайт уже достаточно высоко в поисковой выдаче. То есть это не доля всех ответов Алисы, где встречается ваш проект. Если данных нет, это ещё не значит, что сайт нигде не упоминается. В справке перечислены разные причины: мало наблюдений, низкие позиции, недостаточно текстового содержимого, редкое появление нейроответа по нужным запросам.
Google Search Console
В Search Console есть отдельный Generative AI performance report. Он показывает, сколько раз ссылки на ваш сайт появлялись в AI Overviews и AI Mode, с разбивкой по страницам, странам, устройствам и датам. По данным Google, глобальное развёртывание отчёта завершилось 31 августа 2026 года. Если показов мало, отчёт может не отображаться.
Этот отчёт измеряет присутствие ссылок в генеративных функциях Google. Упоминания названия компании в ответах других нейросетей он не показывает, чтобы увидеть, как именно работает рекомендация, нужно открыть ответ вручную.
Bing Webmaster Tools
В есть раздел AI Performance. Он показывает цитирования в поддерживаемых ИИ-сценариях, страницы-источники и примеры grounding queries — поисковых фраз, по которым система находила материалы. По ним видно, для каких задач Bing использовал ваши страницы.
Bing отдельно предупреждает: число цитирований не говорит о позиции или авторитете страницы внутри ответа. Поэтому сравнивать его со средней позицией в обычном поиске напрямую не получится.
Ручная проверка
Составьте список из 10-20 вопросов, важных для проекта. Это стартовый объём для работы, а не требование поисковиков. Формулируйте вопросы так, как их задал бы человек, который что-то выбирает, настраивает или выясняет.
Задайте одни и те же вопросы в Алисе AI, ChatGPT, Perplexity и Gemini. Чтобы результаты можно было сравнивать, начинайте каждый раз новый диалог и отмечайте, включён ли поиск. Если выбираете, за какими сервисами наблюдать, пригодится наш материал про AI-поисковики.
В журнал проверки заносите:
- точный вопрос, дату, сервис и режим работы;
- упомянут ли проект и что о нём сказано;
- ссылки на ваш сайт и конкретные страницы;
- сторонние источники сведений о проекте;
- ошибки, устаревшие данные и названные альтернативы.
Отсутствие ссылки и отсутствие упоминания — разные ситуации. Если проект назван со слов чужого обзора, правки на вашем сайте могут не исправить ошибку в этом обзоре. Сначала нужно найти страницу, откуда система взяла сведения.
Повторять замер можно раз в 2-4 недели с тем же набором вопросов. Это ритм наблюдения, а не расписание обновления нейросетей. Яндекс, например, говорит, что ответ и его источники могут меняться даже в течение одного дня.
Один удачный ответ после правки ещё не доказывает, что сработала именно она. Записывайте, какие страницы и когда менялись, и смотрите на повторяющийся результат по группе запросов.

Частые вопросы про GEO
Нужно ли бросать SEO ради GEO?
Нет. Генеративные функции поисковиков работают на поисковой инфраструктуре, и Google прямо относит работу над их видимостью к SEO. Доступность, индексация и содержание страниц остаются в работе, к ним добавляется проверка того, как проект представлен в ответах.
Сколько времени занимает попадание в нейроответы?
Общего срока нет. Повторный обход страницы и выбор её источником ответа — разные этапы. Выполнение технических требований не гарантирует показ, поэтому обещание, что сайт попадёт через пять дней — не работает как универсальное правило.
Можно ли запретить нейросетям использовать контент сайта?
У отдельных сервисов есть свои механизмы: OpenAI разделяет поисковый обход и сбор для обучения, а Яндекс позволяет ограничить использование страниц Алисой через правила для YandexAdditional или YandexAdditionalBot. У Google есть настройка Search generative AI и директивы управления содержимым. Единого переключателя для всех нейросетей нет, а ограничения на вашем сайте не убирают сведения о проекте со сторонних площадок.
Работает ли GEO для маленького сайта?
Размер сайта сам по себе не исключает его страницы из возможных источников. Начать можно с узкой задачи, по которой у вас есть содержательный ответ или собственные данные. Гарантии цитирования это не даёт, а отчётам сервисов может не хватить объёма публикаций.
Итого
Чтобы разобраться, как попасть в ответы нейросетей, пройдите весь путь своей страницы: доступна ли она роботу, есть ли она в поиске, отвечает ли на нужный вопрос и появляется ли среди источников. Если проект упоминают по чужим материалам, включите их в проверку тоже.
Результат работы описывайте конкретно: исправлен доступ к странице, дополнена инструкция, обновлены сведения о продукте, выросло число подтверждённых цитирований по выбранным вопросам. У каждого такого изменения есть свой способ проверки — с него и начинается следующая задача по GEO.
Советуем дополнительно почитать
Что такое SEO — что такое поисковая выдача, почему она разная у разных людей и чем SEO отличается от контекстной рекламы.
Что может узнать о вас любой сайт — какие данные сервер получает с каждым запросом: HTTP-заголовки, серверные логи, куки и трекеры.
Нейросети 2026 года, которыми может пользоваться каждый (почти) — Алиса AI и другие сервисы для текста, поиска и разбора информации с примерами задач.
Вся база про токены в нейросетях: что это и как их эффективно использовать — как модель режет текст на токены, что такое контекстное окно и почему оно ограничивает объём прочитанного.
LangChain: что это такое и как построить на нём AI-агента — практический разбор с разделом про RAG: как агент находит фрагменты документов и передаёт их модели вместе с вопросом.
Бонус для читателей
Если вам интересно погрузиться в мир IT и при этом немного сэкономить, держите наш промокод на курсы Практикума. Он даст вам скидку при оплате, поможет с льготной ипотекой или безлимитом на маркетплейсах. Ладно, окей, это просто скидка, без остального, но хорошая.